SLS ofrece un servicio de transformación de datos (nueva versión) totalmente administrado, escalable y de alta disponibilidad para normalizar, extraer, limpiar, filtrar y distribuir datos en varios Logstores.
Funcionamiento
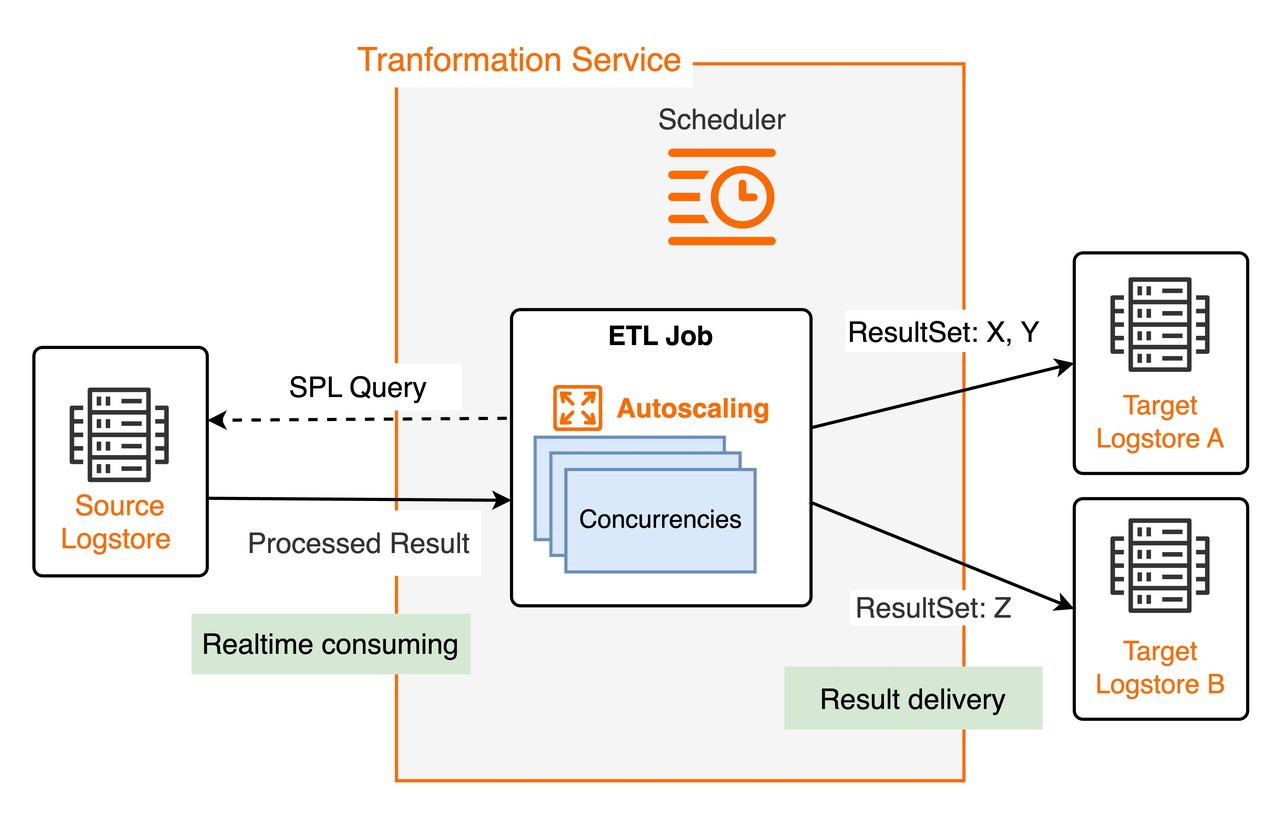
La transformación de datos (nueva versión) procesa registros en tiempo real mediante trabajos de consumo alojados y reglas SPL. SPL syntax. Standard consumption overview.
La transformación de datos utiliza la API de consumo en tiempo real de SLS y no depende de la configuración de índices del Logstore de origen.
Mecanismo de programación
El programador inicia una o más instancias por trabajo para procesar los datos simultáneamente. Cada instancia consume datos de uno o más shards del Logstore de origen. El número de instancias se ajusta según el uso de recursos y el progreso del procesamiento para lograr un escalado elástico. La concurrencia máxima por trabajo equivale al número de shards del Logstore de origen.
Instancias en ejecución
Según las reglas SPL del trabajo y la configuración del Logstore de destino, cada instancia consume registros de origen de los shards asignados; luego, distribuye y escribe los resultados en el Logstore de destino. Las instancias guardan automáticamente los puntos de control de los shards, por lo que un trabajo reiniciado continúa desde el último punto de control guardado.
Detener y reanudar trabajos
Detención automática: Un trabajo con hora de finalización configurada se detiene tras procesar todos los registros anteriores a dicha hora. Si no se define una hora de finalización, el trabajo se ejecuta continuamente. ETL.
Procesamiento reanudable: Tras una detención inesperada, el trabajo reiniciado continúa desde el último punto de control de shard guardado de forma predeterminada, lo cual garantiza la consistencia de los datos.
Consultar el estado de ejecución del trabajo
SLS admite el monitoreo de trabajos de transformación de datos. Observe and monitor data transformation (new version) jobs.
Escenarios
La transformación de datos admite los siguientes escenarios:
Normalización de datos y extracción de información: Extraiga campos de registros con formato inconsistente y normalice los formatos para generar datos estructurados aptos para el procesamiento de flujos y el análisis de almacenes de datos.
-
Reenvío y distribución de datos:
Recopile tipos mixtos de registros en un solo Logstore y distribúyalos a Logstores posteriores según sus características (módulo de origen, componente de negocio) para aislar los datos y ejecutar cómputo específico por escenario.
En despliegues multirregión, agregue los registros de cada región en una región central con aceleración entre regiones para facilitar la administración centralizada.
Limpieza y filtrado de datos: Elimine entradas no válidas o campos sin usar, y escriba la información clave filtrada en Logstores posteriores para un análisis enfocado.
Enmascaramiento de datos: Enmascare datos sensibles como contraseñas, números telefónicos y direcciones.
Funciones
SPL proporciona un lenguaje unificado para la recopilación, consulta y procesamiento de datos, lo que reduce la necesidad de aprender varias sintaxis.
La depuración línea por línea y las sugerencias de código ofrecen una experiencia de codificación SPL similar a la de un IDE.
Procesamiento en tiempo real con visibilidad de datos en segundos, escalado elástico y alto throughput.
Instrucciones integradas de procesamiento de datos y funciones SQL para el análisis de registros.
Métricas de observability en tiempo real, paneles y reglas de monitoreo personalizadas basadas en métricas de ejecución.
Servicio totalmente administrado y libre de mantenimiento, con integraciones al ecosistema de big data y de código abierto de Alibaba Cloud.
Facturación
Logstores pay-by-ingested-data: La transformación de datos (nueva versión) es gratuita. El tráfico saliente generado al extraer o escribir datos a través del endpoint público de SLS se cobra según el volumen de datos comprimidos. Billable items for the pay-by-ingested-data mode.
Logstores pay-by-feature: Se le cobran los recursos de cómputo y red consumidos por la transformación de datos (nueva versión). Billable items for the pay-by-feature mode.
El filtrado dentro de un trabajo de transformación de datos (nueva versión) no reduce el volumen de datos facturable. Esto aplica a filtros como la instrucción SPL
wherey las funciones de descarte del lenguaje específico de dominio (DSL) de la transformación de datos (versión anterior). En el modo pay-by-ingested-data, la facturación se basa en los datos sin procesar ingeridos en el LogStore de origen. El filtrado en un trabajo de transformación de datos solo afecta a los datos escritos en el LogStore de destino; no modifica el volumen ya ingerido en el LogStore de origen.Para reducir el volumen de datos facturable, filtre los registros durante la recopilación. En la configuración de recopilación de Logtail, utilice un plugin de filtrado de datos, como el plugin extendido
processor_filter_regex, para recopilar únicamente los registros necesarios; por ejemplo, solo aquellos cuyo nivel sea error. Los registros que no se recopilan nunca se ingieren en un LogStore, lo que reduce el volumen facturable desde el origen y evita que pasen por la transformación de datos. Para obtener más información, consulte Logtail data filtering plug-ins.