Server Load Balancer (SLB) distribuye las solicitudes entrantes a los servidores backend según el algoritmo de programación que se configura en cada regla de reenvío. SLB admite round-robin, round-robin ponderado, conexiones mínimas ponderadas y hash consistente; cada uno es adecuado para distintos patrones de tráfico y configuraciones de servidores.
ALB, NLB y CLB admiten diferentes subconjuntos de estos algoritmos:
ALB admite round-robin ponderado, conexiones mínimas ponderadas y hash consistente basado en direcciones IP de origen y URL.
NLB admite round-robin, round-robin ponderado, conexiones mínimas ponderadas y hash consistente basado en direcciones IP de origen, la combinación de cuatro elementos y QUIC IDs.
CLB admite round-robin, round-robin ponderado y hash consistente basado en direcciones IP de origen, la combinación de cuatro elementos y QUIC IDs.
Round-robin
Descripción general
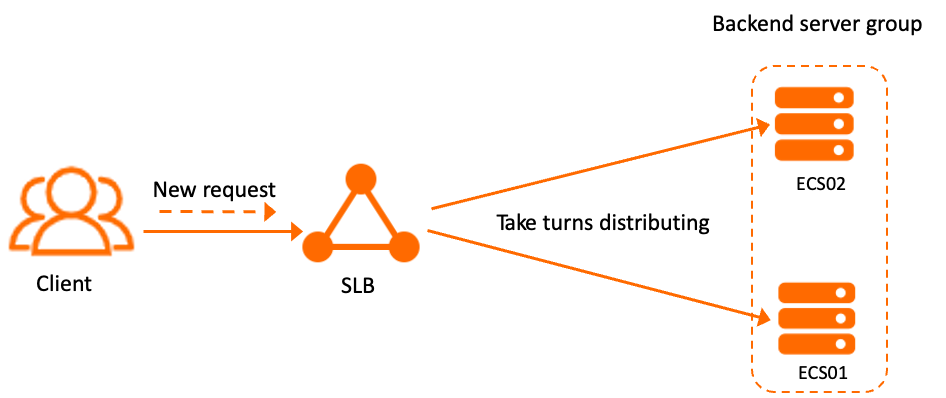
El algoritmo round-robin distribuye las solicitudes a los servidores backend una por una en una secuencia fija. Funciona bien para conexiones efímeras y sin estado, como HTTP, donde cada solicitud es independiente y el tiempo de procesamiento es aproximadamente uniforme.
Por ejemplo, con dos instancias de Elastic Compute Service (ECS) en un grupo de servidores backend, cada instancia recibe solicitudes de forma alterna: la primera solicitud va a ECS01, la segunda a ECS02, la tercera a ECS01, y así sucesivamente.
Ventajas
Operación sencilla: no requiere configuración por servidor y es fácil de implementar y mantener.
Distribución uniforme: reparte las solicitudes equitativamente entre todos los servidores backend cuando el tiempo de procesamiento y la capacidad del servidor son similares.
Desventajas
Sin detección de carga en tiempo real: ignora el nivel de ocupación actual de cada servidor. Si el rendimiento varía significativamente, los servidores más rápidos pueden tener poca carga mientras que los más lentos se sobrecargan.
Las conexiones persistentes causan desequilibrio: no considera la duración de las conexiones. Si algunas permanecen abiertas mucho más tiempo que otras, esos servidores acumulan más conexiones activas con el paso del tiempo, lo que incrementa los tiempos de espera para las solicitudes posteriores.
Cuándo utilizarlo
Capacidad uniforme de servidores: round-robin ofrece su mejor rendimiento cuando los servidores backend tienen CPU y memoria similares. Con hardware comparable, la distribución uniforme mantiene todos los servidores con una carga aproximadamente igual.
Solicitudes cortas y sin estado: resulta adecuado para cargas de trabajo donde cada solicitud se completa rápidamente y no requiere afinidad a un servidor específico; por ejemplo, para servir recursos estáticos o llamadas API simples.
Round-robin ponderado
Descripción general
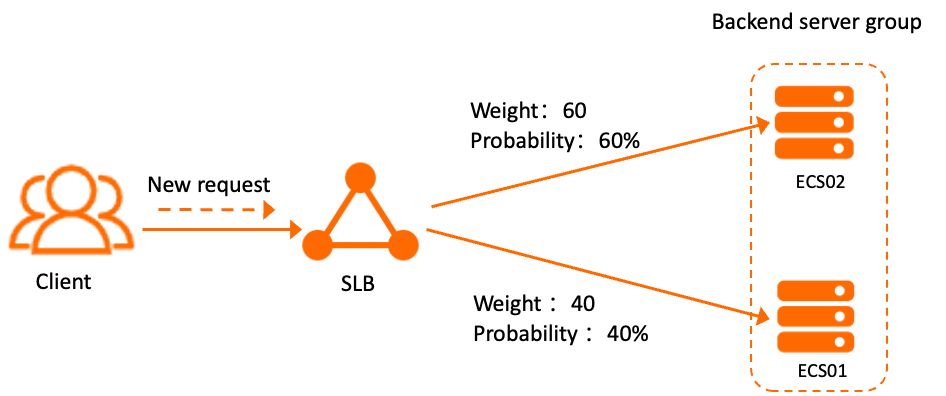
El algoritmo round-robin ponderado extiende el round-robin al permitir asignar un peso a cada servidor backend. Los servidores con pesos mayores reciben proporcionalmente más solicitudes. Al igual que el round-robin, es adecuado para conexiones no persistentes como HTTP.
Por ejemplo, con dos instancias de ECS a las que se asignan pesos de 60 y 40, la primera instancia maneja el 60 % de las solicitudes y la segunda el 40 %.
Ventajas
Distribución proporcional: asigna el tráfico en proporción al peso de cada servidor, de modo que los servidores de mayor capacidad absorben más carga sin saturarse.
Control explícito: permite decidir exactamente cuánto tráfico recibe cada servidor, lo que facilita considerar servidores con distintas especificaciones de hardware.
Desventajas
Sobrecarga de configuración: cada servidor backend necesita un valor de peso. Cuando hay muchos servidores o la capacidad cambia con frecuencia, mantener los pesos precisos requiere esfuerzo continuo de operación y mantenimiento.
Riesgo de pesos mal configurados: unos pesos inexactos producen una distribución de carga desequilibrada. Si el rendimiento del servidor cambia debido a actualizaciones, degradación o variaciones de tráfico, los pesos deben actualizarse manualmente.
Cuándo utilizarlo
Servidores de capacidad mixta: cuando los servidores backend tienen diferente capacidad de CPU, memoria o red, establezca pesos proporcionales a su rendimiento relativo para que los servidores de mayor capacidad absorban más tráfico.
Cambios graduales de tráfico: para migrar tráfico entre generaciones de servidores o implementar progresivamente una nueva instancia, ajuste los pesos de forma incremental en lugar de cambiar todo el tráfico de golpe.
Control detallado del tráfico: cuando se necesita un control preciso sobre las proporciones de tráfico (por ejemplo, enviar el 20 % de las solicitudes a un servidor canary), el round-robin ponderado permite expresar esa proporción directamente mediante valores de peso.
Conexiones mínimas ponderadas
Descripción general
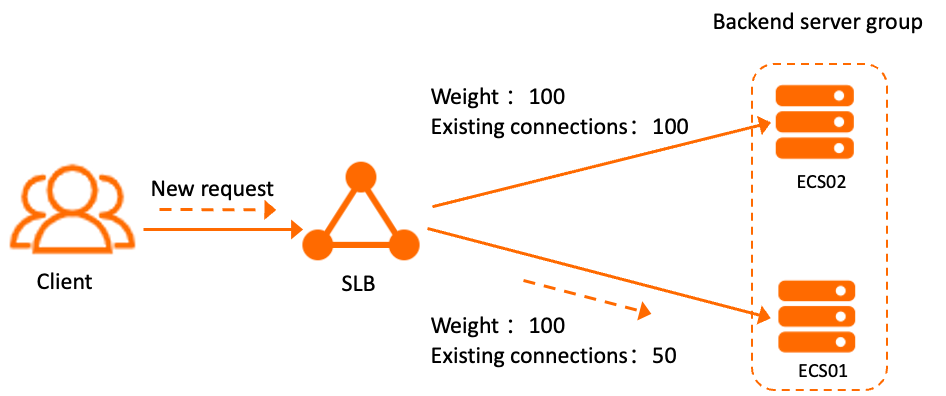
El algoritmo de conexiones mínimas ponderadas enruta cada nueva solicitud al servidor backend con menos conexiones activas en relación con su peso. Si dos servidores comparten el mismo peso, el que tenga menos conexiones actuales recibe la siguiente solicitud. Este algoritmo funciona mejor para conexiones persistentes, como las de bases de datos, donde el recuento de conexiones es un indicador significativo de la carga del servidor.
Por ejemplo, con dos instancias de ECS ambas con peso 100 (una con 100 conexiones activas y la otra con 50), las nuevas solicitudes van a la instancia con 50 conexiones hasta que los recuentos se equilibran.
Ventajas
Detección de carga en tiempo real: rastrea continuamente las conexiones activas por servidor y dirige las nuevas solicitudes lejos de los servidores más ocupados, lo que mantiene la carga equilibrada ante fluctuaciones de tráfico.
Equidad ajustada por peso: combina el recuento de conexiones con el peso del servidor para evitar tanto la sobrecarga de servidores de alta capacidad como la subutilización de los de baja capacidad.
Desventajas
Mayor sobrecarga de programación: en comparación con round-robin y round-robin ponderado, este algoritmo debe consultar y comparar los recuentos de conexiones activas en todos los servidores backend antes de seleccionar uno, lo que añade costo computacional a gran escala.
Visión incompleta de la carga del servidor: solo rastrea las conexiones entre SLB y el servidor backend. Si los datos de monitoreo son inexactos o están desactualizados, es posible que las solicitudes no se distribuyan al servidor con menos conexiones. Además, si el mismo servidor pertenece a varias instancias de SLB, los recuentos de conexiones de una sola instancia de SLB subestiman la carga real del servidor, lo que puede provocar sobrecarga o subutilización.
Picos de carga al agregar nuevos servidores: los servidores nuevos comienzan con cero conexiones y atraen una ráfaga repentina de solicitudes. Esto puede sobrecargarlos antes de que se estabilicen y potencialmente desestabilizar el clúster.
Cuándo utilizarlo
Servidores de capacidad mixta con conexiones persistentes: combine pesos con el seguimiento de conexiones en tiempo real para mantener la carga proporcional a la capacidad de cada servidor, incluso cuando la duración de las conexiones varía ampliamente.
Patrones de tráfico dinámicos: cuando las conexiones activas fluctúan significativamente con el tiempo, el algoritmo reequilibra continuamente el tráfico sin necesidad de ajustes manuales de peso.
Cargas de trabajo sensibles a la estabilidad: para aplicaciones que requieren tiempos de respuesta consistentes, como bases de datos o pools de conexiones, dirigir las nuevas solicitudes al servidor menos cargado ayuda a prevenir que servidores individuales se conviertan en cuellos de botella.
Hash consistente
Descripción general
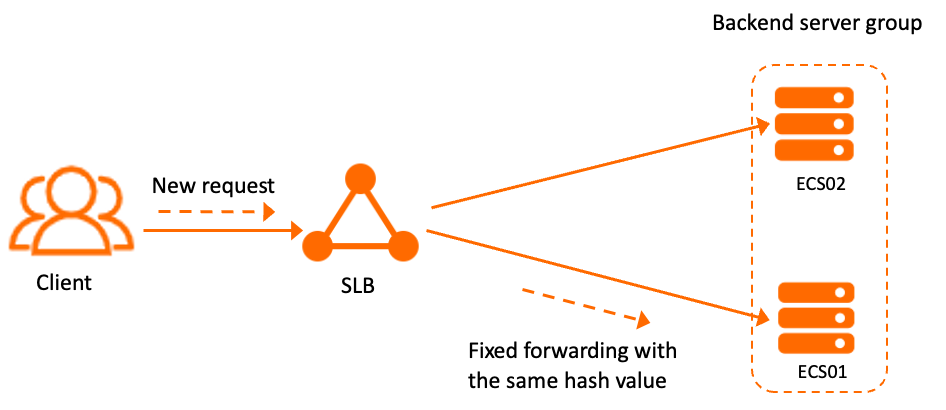
El hash consistente asigna cada solicitud a un servidor backend basándose en un hash calculado a partir de uno o más atributos de la solicitud (factores de hash). Las solicitudes que comparten el mismo valor de hash siempre van al mismo servidor, incluso si cambia el número de servidores backend. Cuando se agrega o elimina un servidor, solo se reenruta un subconjunto mínimo de solicitudes.
Los factores de hash incluyen:
Dirección IP de origen: las solicitudes provenientes de la misma IP de cliente siempre llegan al mismo servidor backend.
Cuatro elementos: el hashing utiliza la combinación de dirección IP de origen, puerto de origen, dirección IP de destino y puerto de destino. Las solicitudes que comparten los cuatro valores van al mismo servidor.
QUIC ID: el hashing utiliza el ID de conexión QUIC, que identifica de manera única cada conexión QUIC. El hashing basado en QUIC IDs puede equilibrar la carga entre conexiones. Las solicitudes con el mismo QUIC ID se distribuyen al mismo servidor backend.
Cadena de consulta de URL: las solicitudes con la misma cadena de consulta de URL se enrutan al mismo servidor backend.
Por ejemplo, con dos instancias de ECS en un grupo de servidores, si la última solicitud se enrutó a ECS01, cualquier solicitud posterior con el mismo valor de hash también se envía a ECS01.
Ventajas
Persistencia de sesión: las solicitudes del mismo origen se enrutan consistentemente al mismo servidor backend, lo que preserva el estado de la sesión sin requerir un almacén de sesiones separado. Esto hace que el hash consistente sea muy adecuado para aplicaciones que dependen de datos de sesión del lado del servidor o de caché específica por usuario.
Interrupción mínima durante cambios de servidores: cuando se agregan o eliminan servidores, solo se reenrutan las solicitudes cuyos valores de hash corresponden al espacio modificado. Las solicitudes restantes continúan llegando a los mismos servidores que antes.
Desventajas
Desequilibrio temporal tras cambios de servidores: agregar o eliminar un servidor provoca que se redistribuyan las solicitudes asignadas al espacio de hash de ese servidor. Si aumenta el número de servidores backend, se reprograman menos solicitudes; si disminuye, se reprograman más. Hasta que el tráfico se reequilibre, algunos servidores pueden soportar una parte desproporcionada de la carga.
Mayor complejidad operativa durante el escalado horizontal: cada cambio de servidor desencadena un rehash parcial. En entornos con eventos de escalado frecuentes, este reenrutamiento continuo añade sobrecarga operativa y puede complicar la planificación de capacidad.
Cuándo utilizarlo
Aplicaciones con persistencia de sesión: utilice hash consistente cuando su aplicación almacene datos de sesión o estado de usuario en servidores backend individuales y no pueda tolerar que las solicitudes del mismo usuario lleguen a diferentes servidores durante la sesión.
Backends con uso intensivo de caché: cuando los servidores backend mantienen cachés locales, enrutar las mismas solicitudes al mismo servidor maximiza las tasas de aciertos de caché y reduce la computación redundante en todo el clúster.
Requisitos de localidad de datos: en cargas de trabajo donde los datos particionados por clave deben procesarse en un servidor específico, como bases de datos fragmentadas o procesamiento de flujos con estado, el hash consistente garantiza que las solicitudes de cada clave siempre lleguen a la partición correcta.
El hashing basado en QUIC IDs solo aplica a aplicaciones QUIC. Dado que QUIC evoluciona rápidamente, no se puede garantizar la compatibilidad con versiones específicas de QUIC. Pruebe sus aplicaciones exhaustivamente antes de habilitar QUIC en producción.
NLB y CLB admiten hashing basado en QUIC IDs. Q10 y Q29 son compatibles.