SchedulerX programa diversos tipos de trabajos, incluidos trabajos programados, flujos de trabajo orquestados y reejecuciones de datos históricos. Ofrece modelos de fragmentación para Java, Python, Shell y Go que le permiten satisfacer sus necesidades de procesamiento de big data.
Contexto
Los modelos de fragmentación incluyen la fragmentación estática y la fragmentación dinámica.
Fragmentación estática: este modelo se utiliza para procesar un número fijo de shards. Por ejemplo, puede usarlo para procesar 1,024 tablas fragmentadas en varias máquinas dentro de un entorno distribuido.
Fragmentación dinámica: este modelo se emplea para el procesamiento distribuido de datos con un volumen desconocido. Por ejemplo, sirve para procesar por lotes una tabla grande que se actualiza con frecuencia. El framework principal para esto es el modelo MapReduce proporcionado por SchedulerX, el cual aún no es de código abierto.
Funciones
El modelo fragmentado multilenguaje también ofrece las siguientes funciones.
Compatible con el modelo de fragmentación estática de elastic-job.
Admite cuatro lenguajes: Java, Python, Shell y Go.
Alta disponibilidad (HA): los modelos de fragmentación se basan en el modelo MapReduce y heredan sus funciones de alta disponibilidad. Si un worker presenta errores durante la ejecución, el worker maestro transfiere automáticamente el shard a otro nodo esclavo mediante failover.
Limitación de velocidad: los modelos de fragmentación se basan en el modelo MapReduce y heredan sus funciones de limitación. Es posible controlar la concurrencia de tareas en una sola máquina. Por ejemplo, con 1,000 shards y 10 máquinas, puede limitar cada máquina para que ejecute un máximo de cinco shards simultáneamente. Los demás shards esperan en una cola.
Reintentos automáticos para shards con errores: los modelos de fragmentación se basan en el modelo MapReduce y heredan su capacidad para reintentar automáticamente las subtareas que presentaron errores.
Puede establecer la disponibilidad y la limitación de velocidad en la configuración avanzada al crear un trabajo. Para obtener más información, consulte Create a scheduling job y Advanced configuration parameters for job management.
El modelo fragmentado multilenguaje solo es compatible con versiones del cliente 1.1.0 y posteriores.
Trabajo de fragmentación en Java
Inicie sesión en la consola de SchedulerX.
Inicie sesión en la consola de EDAS.
En la barra de navegación superior, seleccione una región.
En el panel de navegación izquierdo, seleccione Job Management.
En el panel de navegación izquierdo, seleccione Task Scheduling y luego haga clic en Job Management.
En la página Job Management, seleccione el namespace deseado y luego haga clic en Create Job en la esquina superior izquierda.
-
En el panel Create Job, en la pestaña Basic Configuration, establezca Execution Mode en Sharded Run, configure Shard Parameters y luego haga clic en Next.
Separe varios parámetros de shard con una coma (,) o un salto de línea. Por ejemplo,
Shard ID 1=Shard parameter 1,Shard ID 2=Shard parameter 2,....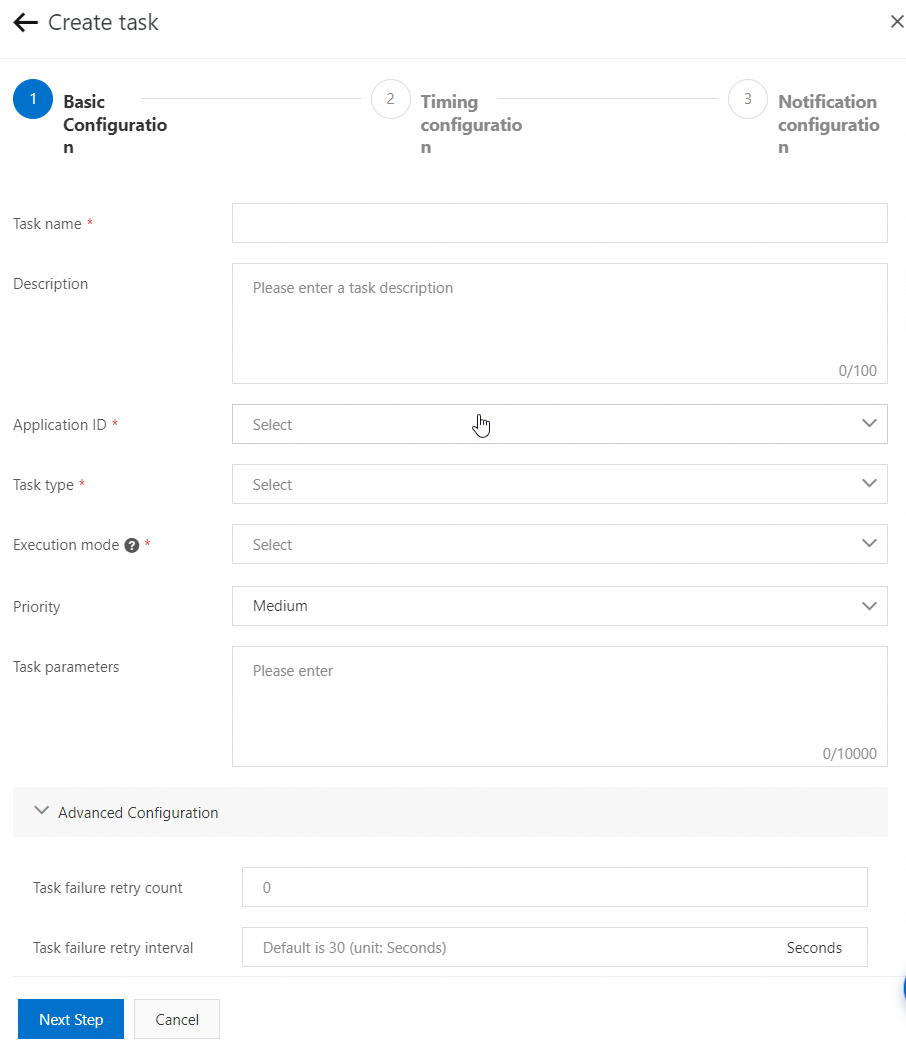
-
En el código de la aplicación, herede
JavaProcessor. UtiliceJobContext.getShardingId()para obtener el ID del shard yJobContext.getShardingParameter()para obtener el parámetro del shard.Ejemplo:
@Component public class HelloWorldProcessor extends JavaProcessor { @Override public ProcessResult process(JobContext context) throws Exception { System.out.println("Shard ID=" + context.getShardingId() + ", Shard parameter=" + context.getShardingParameter()); return new ProcessResult(true); } } -
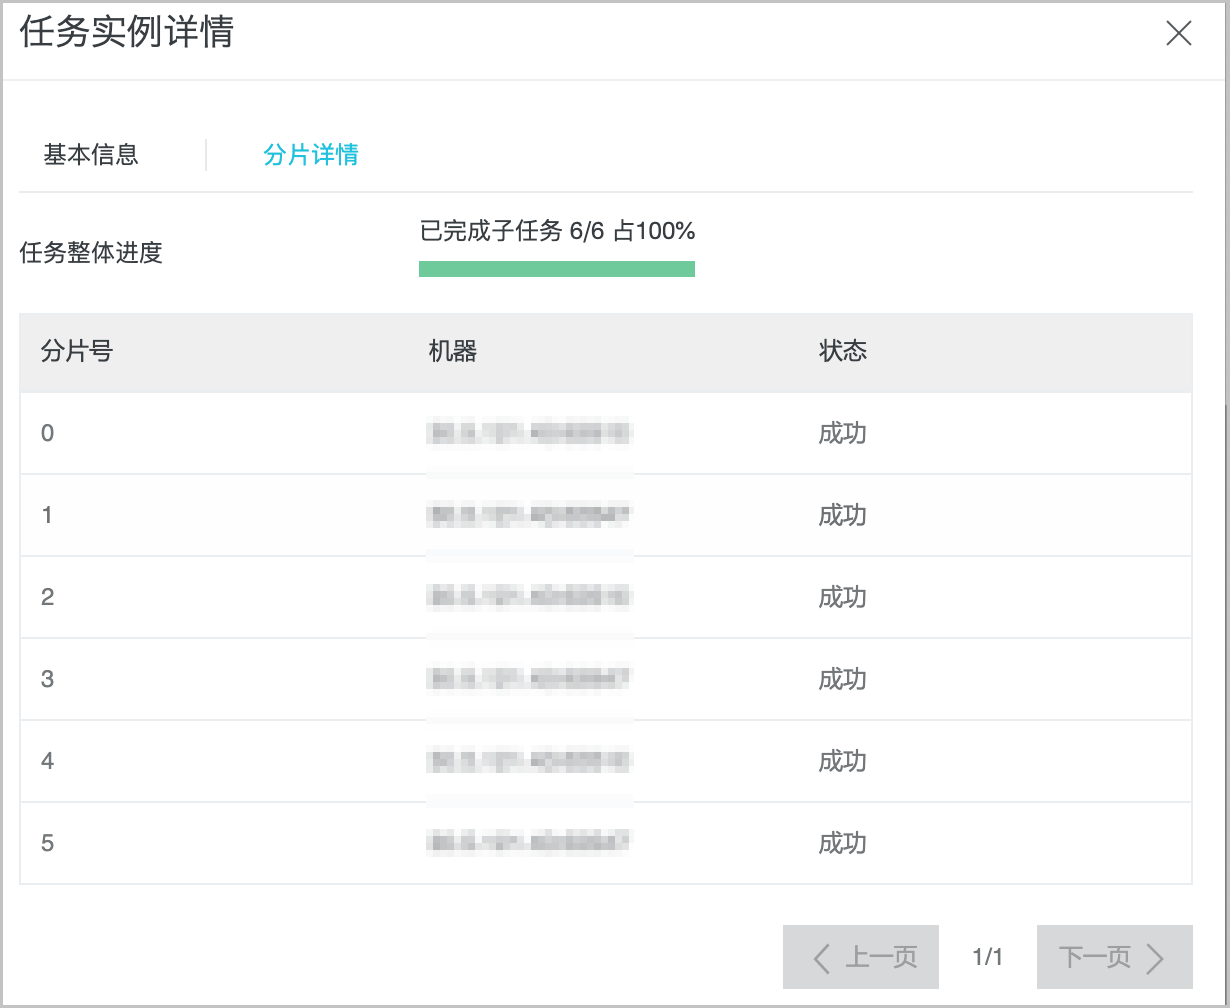
En la página Execution List, haga clic en Details en la columna Actions del trabajo correspondiente para consultar los detalles del shard.
Trabajo de fragmentación en Python
Para utilizar el procesamiento por lotes distribuido en una aplicación de Python, solo necesita instalar el agente. Posteriormente, SchedulerX puede gestionar los scripts.
Descargue el agente de SchedulerX y utilícelo para desplegar un trabajo de script.
-
Cree un trabajo de fragmentación en Python en SchedulerX. Para obtener más información, consulte Create a scheduling job.
sys.argv[1]es el ID del shard ysys.argv[2]es el parámetro del shard.Separe varios parámetros de shard con una coma (,) o un salto de línea. Por ejemplo,
Shard ID 1=Shard parameter 1,Shard ID 2=Shard parameter 2,....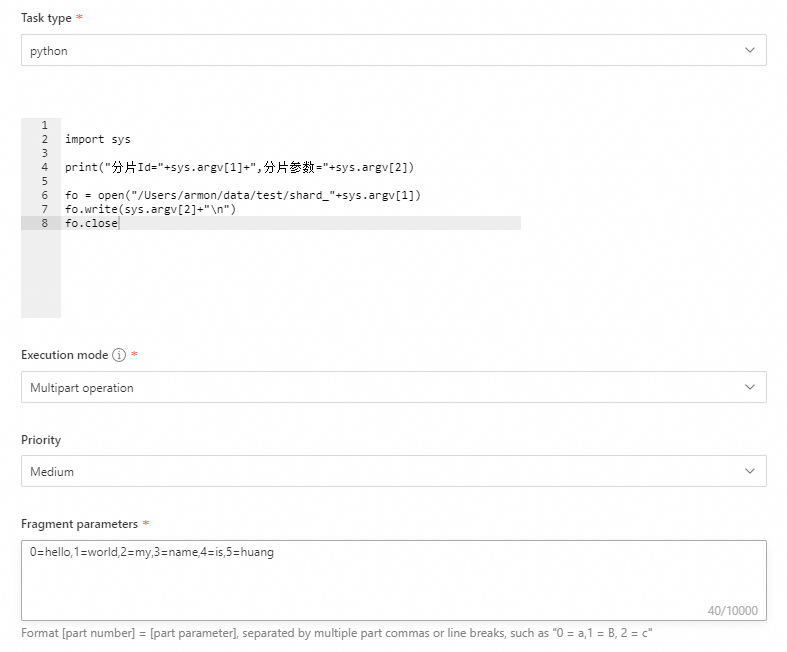
-
En la página Execution List, haga clic en Details en la columna Actions del trabajo correspondiente para consultar los detalles del shard.
Trabajos de fragmentación en Shell y Go
El proceso para crear trabajos de fragmentación en Shell y Go es similar al de los trabajos de fragmentación en Python. Para obtener más información, consulte Python sharding job.