Identificar las claves que consumen mucha memoria antes de que causen problemas resulta difícil cuando una instancia de Redis está bajo carga. El análisis de claves sin conexión examina los archivos de copia de seguridad de su instancia de Tair (compatible con Redis OSS) para detectar claves grandes y mostrar el uso de memoria, la distribución de claves y los tiempos de expiración, sin afectar el rendimiento de la instancia. Utilice los resultados para optimizar su instancia y evitar el agotamiento de la memoria o la degradación del rendimiento causada por la concentración de claves.
Esta función se basa en la función de análisis de caché de CloudDBA.
Limitaciones
Disk-based instances no son compatibles.
Si cambia el tipo de instancia, no se pueden analizar los archivos de copia de seguridad creados antes del cambio.
Solo se admiten las estructuras de datos de Redis Open-Source Edition y las siguientes estructuras propietarias de Tair: TairString, TairHash, TairGIS, TairBloom, TairDoc, TairCpc y TairZset. La tarea de análisis falla si el archivo de copia de seguridad contiene otras estructuras propietarias de Tair.
Elegir un método de análisis
Hay tres métodos de análisis disponibles. Elija uno según la actualidad que requieran los datos.
|
Método |
Actualidad de los datos |
Cuándo utilizarlo |
|
Use Recent Backup File |
Última copia de seguridad programada |
Inspección diaria o rutinaria |
|
Select a historical backup file |
Un punto específico en el pasado |
Comparación con un estado conocido |
|
Create New Backup for Analysis |
Estado actual de la instancia |
Investigación de un problema activo |
Si analiza un archivo de copia de seguridad existente, confirme que su hora de creación coincida con el momento que desea inspeccionar.
Ejecutar un análisis de claves sin conexión
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Una instancia de Tair (compatible con Redis OSS) que no esté basada en disco
Los permisos necesarios. Si utiliza un usuario de Resource Access Management (RAM), consulte
Iniciar una tarea de análisis
Inicie sesión en la consola y vaya a la página de Instances. Seleccione la región donde reside su instancia y haga clic en el ID de la instancia.
En el panel de navegación izquierdo, elija CloudDBA > Offline Key analysis. De forma predeterminada, la página muestra los resultados del análisis del día anterior. Ajuste el intervalo de tiempo según sea necesario.
Haga clic en Analyze.
-
En el cuadro de diálogo, configure los siguientes parámetros.
Parámetro
Descripción
Node
El nodo que se va a analizar. Seleccione toda la instancia o un nodo específico.
Analysis method
El archivo de copia de seguridad que se utilizará. Consulte Elegir un método de análisis para obtener orientación.
Delimiter
Caracteres utilizados para identificar prefijos de clave. Los delimitadores predeterminados son `:;,_-+@=
#`. Déjelo en blanco para usar los valores predeterminados.
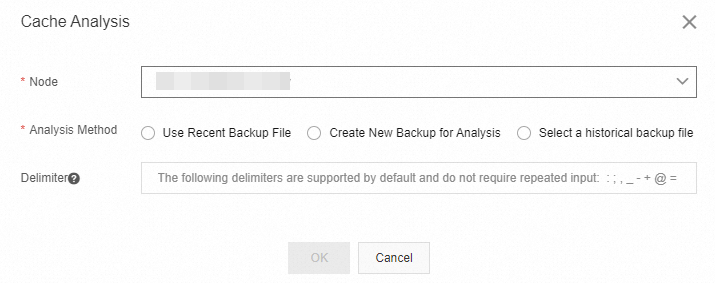
Haga clic en OK. El sistema envía la tarea de análisis y muestra su estado. Haga clic en Refresh para actualizar el estado.
Consultar resultados
Cuando el estado de la tarea muestre que se ha completado, haga clic en Details en la columna Actions.
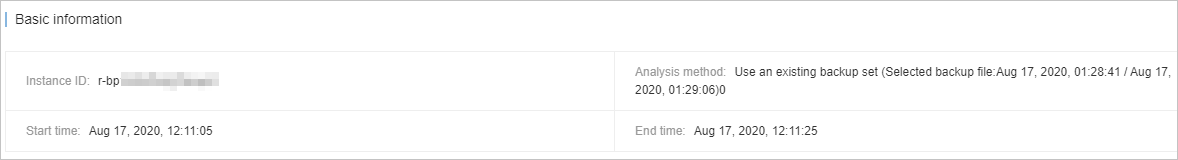
La página de detalles contiene las siguientes secciones:
-
Basic information: atributos de la instancia y método de análisis utilizado.
-
Relevant Nodes: uso de memoria y estadísticas de claves para cada nodo.
Esta sección aparece solo para instancias de clúster o de división de lectura/escritura cuando se seleccionó toda la instancia como Node .

-
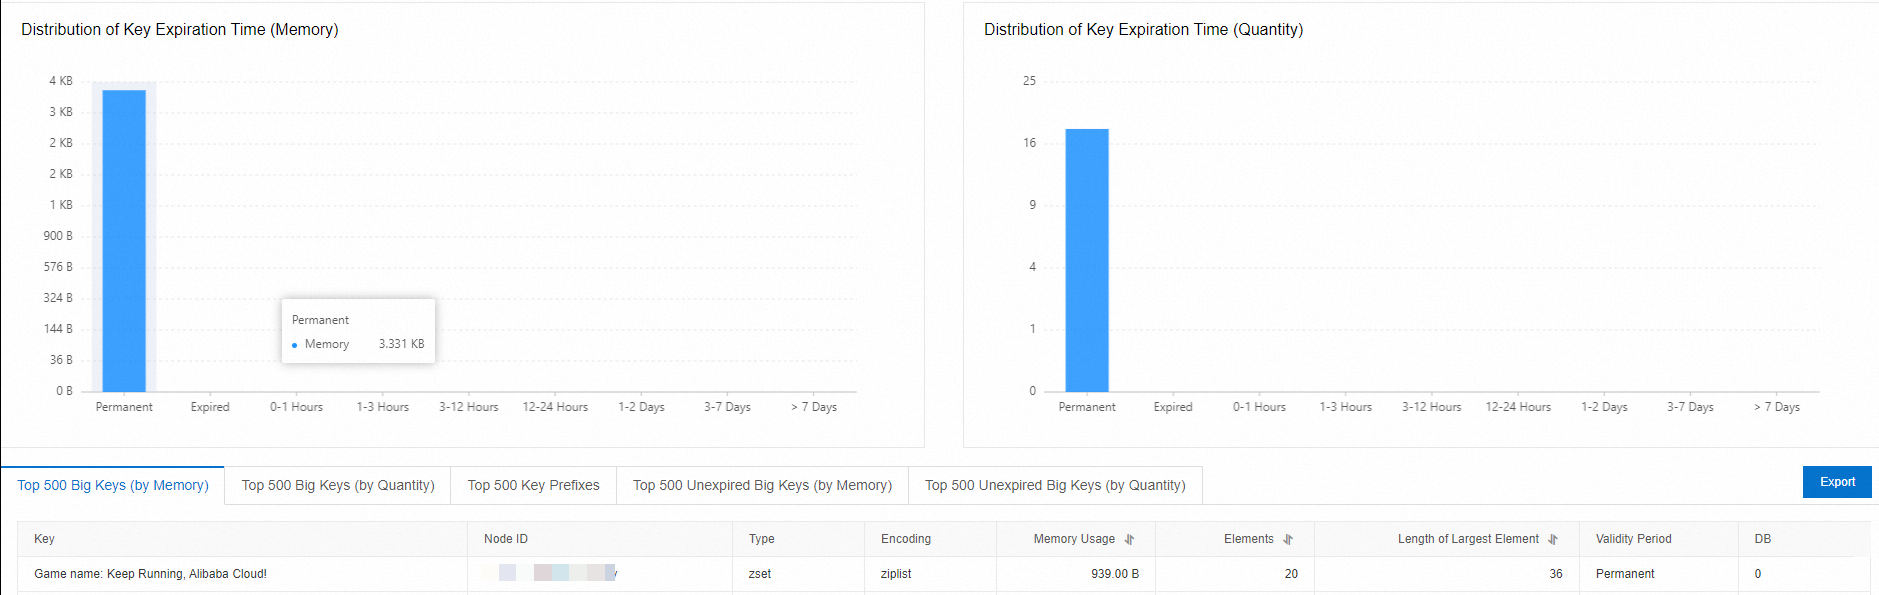
Details: un desglose que incluye:
Uso y distribución de memoria por tipo de clave
Recuento de elementos y distribución de tamaño dentro de las claves
Distribución del tiempo de expiración de claves
Principales claves grandes clasificadas por memoria
Preguntas frecuentes
¿Por qué hay tantas claves caducadas?
Las claves con un tiempo de vida (TTL) configurado pueden acumularse cuando muchas caducan al mismo tiempo. La instancia las elimina automáticamente, pero para liberar memoria de inmediato, utilice la función Clear Data. Consulte Clear expired keys.
¿Qué hago si se reporta un error de "permission denied" al usar un usuario de RAM?
Otorgue los permisos necesarios al usuario de RAM y reintente la operación. Para más información, consulte Common scenarios and examples of custom policies.
¿Por qué varía la velocidad de análisis entre tareas en la misma instancia?
Las tareas de análisis se ejecutan de forma asíncrona en CloudDBA. Si hay otras tareas en cola antes que la suya, su tarea esperará más tiempo. El tiempo total depende de la profundidad de la cola, no solo del tamaño de su instancia.
¿Cómo soluciono el error decode rdbfile error: rdb: unknown object type 116 for key?
La copia de seguridad contiene estructuras Bloom no estándar, las cuales no son compatibles con el análisis.
¿Cómo soluciono el error decode rdbfile error: rdb: invalid file format?
Existen dos causas comunes:
La configuración de la instancia cambió después de crear la copia de seguridad. Seleccione una copia de seguridad que coincida con la configuración actual.
Transparent Data Encryption (TDE) está habilitado. Esta función no puede analizar archivos de copia de seguridad cifrados.
¿Cómo soluciono el error decode rdbfile error: rdb: unknown module type?
La copia de seguridad contiene estructuras de datos propietarias de Tair que no están en la lista de estructuras compatibles (TairString, TairHash, TairGIS, TairBloom, TairDoc, TairCpc, TairZset). El análisis no puede continuar para copias de seguridad que incluyen estructuras no compatibles.
¿Cómo soluciono el error XXX backup failed al crear una nueva copia de seguridad para el análisis?
Se está ejecutando un comando BGSAVE o BGREWRITEAOF en la instancia, lo cual bloquea la nueva copia de seguridad. Ejecute el análisis fuera de las horas pico o cambie a Use Recent Backup File o Select a historical backup file.
¿Por qué el uso de memoria en la página Details parece menor que el uso real?
El análisis calcula la memoria basándose en los datos serializados de claves y valores en el archivo de copia de seguridad de Redis Database (RDB). Esto cubre solo una parte de la huella de memoria real. El resto incluye:
Datos de estructura, punteros y sobrecarga de alineación de bytes. Para instancias con 250 millones de claves, esto puede añadir aproximadamente de 2 a 3 GB (asignados mediante jemalloc).
Búferes del lado del cliente: búfer de salida, búfer de consultas y búfer de reescritura de archivo de solo anexión (AOF).
Registros atrasados de replicación primaria/réplica.
¿Por qué el uso de memoria para claves Stream es varias veces mayor de lo esperado?
Stream es una estructura de datos compleja que utiliza árboles radix y listpacks internamente. El análisis no puede medir con precisión la memoria de estas estructuras anidadas, por lo que los resultados son aproximados. Esta discrepancia es estadística y no afecta la funcionalidad de la instancia.
¿Por qué el recuento de elementos y la longitud del elemento son iguales para las claves String?
Para las instancias de Tair (compatible con Redis OSS), el número de elementos de una clave String se define como la longitud del valor. Esto funciona así por diseño.
Referencia de API
|
API |
Descripción |
|
Crea una tarea de análisis de caché |
|
|
Consulta los detalles de una tarea de análisis de caché |
|
|
Lista las tareas de análisis de caché |
Pasos siguientes
Top key statistics: supervise claves grandes en tiempo real sin necesidad de un archivo de copia de seguridad