El mecanismo de pipelining de Redis permite ejecutar operaciones por lotes o mejorar el rendimiento en la ejecución de comandos. Esta técnica envía varios comandos al servidor de forma simultánea, lo que reduce la latencia de red y mejora el rendimiento. Tair (Redis OSS-compatible) es compatible con el pipelining nativo de Redis.
Introducción a pipelining
Por lo general, los clientes y los servidores de Redis utilizan un patrón de interacción tipo ping-pong. En este patrón, el cliente envía un comando y espera la respuesta del servidor antes de enviar el siguiente.
Redis también admite un modo pipeline. Este modo funciona como una línea de ensamblaje: el cliente envía un comando sin esperar la respuesta antes de enviar los siguientes. Una vez enviados todos los comandos, el cliente lee todas las respuestas y las asocia con los comandos originales en orden. En la mayoría de las implementaciones de clientes de Redis para el modo pipeline, los comandos se envían en lote. Después de recibir todos los resultados, estos se devuelven a la aplicación.
La siguiente figura muestra la comunicación de red para los patrones ping-pong y pipeline.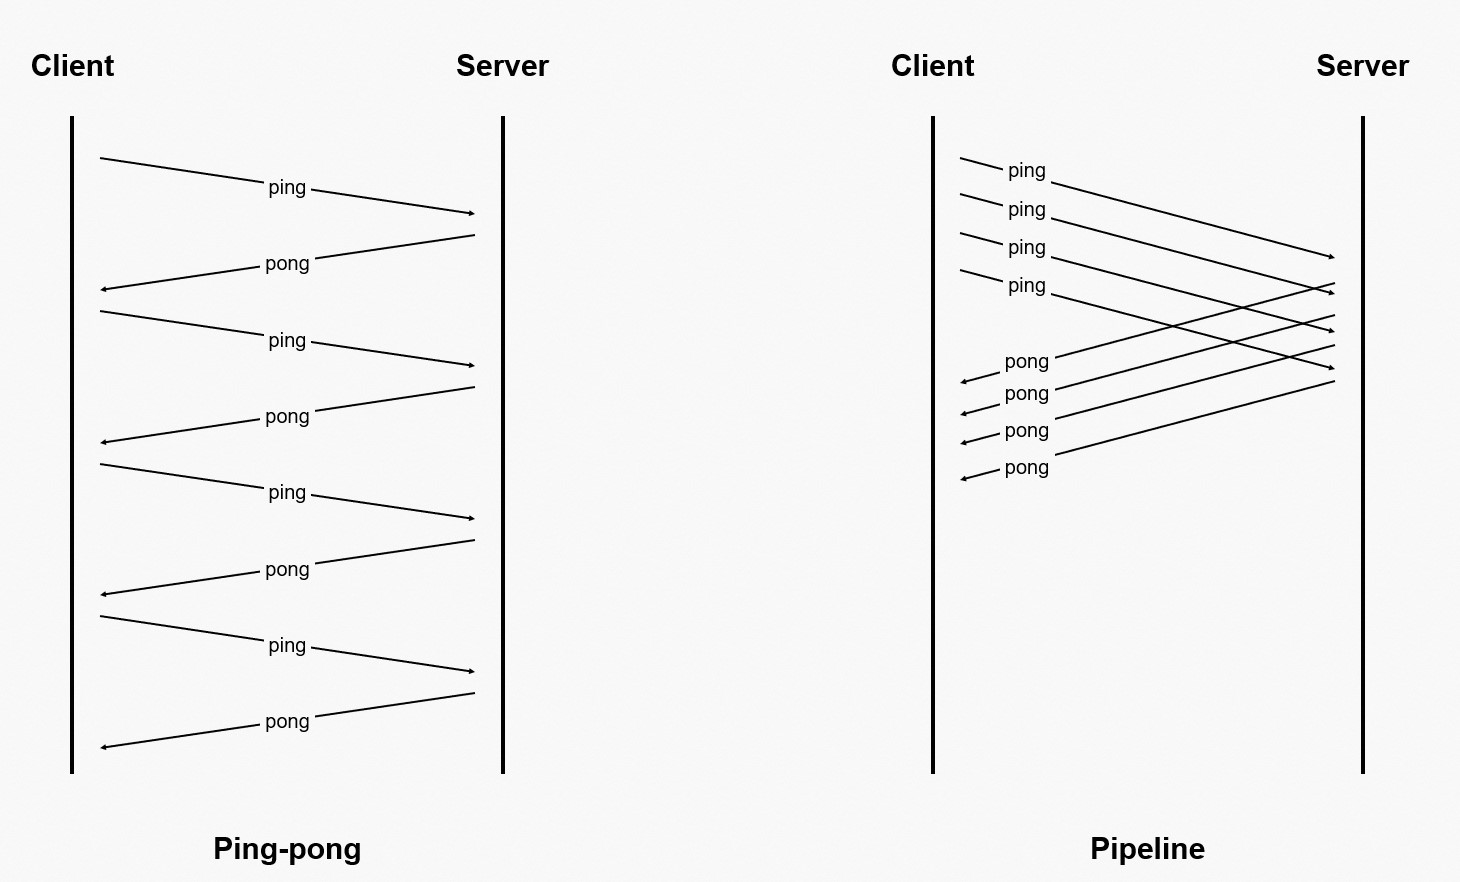
Pipelining mejora la eficiencia y el rendimiento del programa al reducir el tiempo de ida y vuelta de la red (RTT). También disminuye el número de llamadas al sistema read() y write(), así como los cambios de contexto de proceso.
Pipelining resulta muy eficaz en ciertos escenarios. Por ejemplo, si necesita enviar varios comandos al servidor rápidamente y no requiere una respuesta inmediata para cada uno, utilice pipelining como herramienta de procesamiento por lotes para optimizar el rendimiento.
Al usar pipelining, el cliente tiene uso exclusivo de la conexión al servidor. Durante este tiempo, no es posible realizar otras operaciones fuera del pipeline hasta que este se cierre. Para ejecutar otras operaciones simultáneamente, cree una conexión independiente para la operación de pipeline y manténgala separada de las operaciones regulares.
Para obtener más información, consulte Pipeline.
Precauciones
-
Pipelining no garantiza la atomicidad.
Pipelining solo modifica el método de envío del cliente para agrupar los comandos en lotes. El servidor sigue analizando el flujo de datos en comandos individuales y los ejecuta en orden. Cada comando es independiente, por lo que el servidor podría ejecutar comandos de otros clientes durante este proceso. Para garantizar la atomicidad, use transacciones o scripts de Lua.
-
No se admite la reversión si ocurre un error durante la ejecución del pipeline.
Pipelining no posee las propiedades de una transacción. No utilice pipelining si los comandos por ejecutar tienen dependencias entre sí.
NotaAlgunos clientes, como redis-py, usan los comandos de transacción MULTI y EXEC para simular un pipeline. Al utilizar estos clientes, tenga en cuenta las diferencias entre pipelining y las transacciones; de lo contrario, podrían producirse errores. Para más información sobre los límites de las transacciones, consulte Transactions.
Los servidores y algunos clientes tienen límites de búfer. Evite usar demasiados comandos en un solo pipeline.
-
Pipelining es un patrón de interacción cliente-servidor independiente de la arquitectura del servidor. Por lo tanto, las instancias que usan una arquitectura de clúster con modo proxy, una arquitectura de clúster con modo de conexión directa o una arquitectura de división de lectura/escritura son compatibles con pipelining.
NotaLa arquitectura de clúster tiene sus propios límites. Por ejemplo, no admite el acceso a claves en distintos slots dentro de un mismo comando. Si intenta acceder a datos que no pertenecen al nodo actual, se producirá un error
-MOVED. Al usar pipelining en una arquitectura de clúster, asegúrese de que los comandos dentro del pipeline cumplan con las condiciones de ejecución de dicha arquitectura. Para más información sobre los límites, consulte Command limitations for cluster and read/write splitting instances.
Ejemplos de código
Comparación de rendimiento
El siguiente código demuestra la diferencia de rendimiento entre usar y no usar un pipeline.
package pipeline.kvstore.aliyun.com;
import java.util.Date;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Pipeline;
public class RedisPipelinePerformanceTest {
        static final String host = "xxxxxx.m.cnhza.kvstore.aliyuncs.com";
        static final int port = 6379;
        static final String password = "password";
        public static void main(String[] args) {
            Jedis jedis = new Jedis(host, port);
                // The password of the Tair instance
                String authString = jedis.auth(password);// password
                if (!authString.equals("OK")) {
                    System.err.println("AUTH Failed: " + authString);
                    jedis.close();
                    return;
                }
                // Run multiple commands consecutively.
                final int COUNT=5000;
                String key = "KVStore-Tanghan";
                // 1 ---Operation without a pipeline---
                jedis.del(key);// Initialize the key.
                Date ts1 = new Date();
                for (int i = 0; i < COUNT; i++) {
                    // Send a request and receive a response.
                    jedis.incr(key);
                }
                Date ts2 = new Date();
                System.out.println("Without pipeline > value is:"+jedis.get(key)+" > Time elapsed: " + (ts2.getTime() - ts1.getTime())+ "ms");
                //2 ----Comparison with a pipeline operation---
                jedis.del(key);// Initialize the key.
                Pipeline p1 = jedis.pipelined();
                Date ts3 = new Date();
                for (int i = 0; i < COUNT; i++) {
                    // Send the request.
                    p1.incr(key);
                }
                // Receive the response.
                p1.sync();
                Date ts4 = new Date();
                System.out.println("With pipeline > value is:"+jedis.get(key)+" > Time elapsed: " + (ts4.getTime() - ts3.getTime())+ "ms");
                jedis.close();
        }
    }
Después de introducir el endpoint y la contraseña correctos para la instancia de Tair (Redis OSS-compatible) y ejecutar el programa Java, el sistema devuelve la siguiente salida. Esta salida muestra que el uso de un pipeline es mucho más rápido.
Without pipeline > value is:5000 > Time elapsed: 5844ms
With pipeline > value is:5000 > Time elapsed: 78ms
Cómo gestionar los datos de respuesta
Existen dos formas de gestionar los datos de respuesta de un pipeline de Jedis. Para más información, consulte el siguiente ejemplo de código.
package pipeline.kvstore.aliyun.com;
import java.util.List;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Pipeline;
import redis.clients.jedis.Response;
    public class PipelineClientTest {
        static final String host = "xxxxxxxx.m.cnhza.kvstore.aliyuncs.com";
        static final int port = 6379;
        static final String password = "password";
        public static void main(String[] args) {
            Jedis jedis = new Jedis(host, port);
                // Instance password
                String authString = jedis.auth(password);// password
                if (!authString.equals("OK")) {
                    System.err.println("AUTH Failed: " + authString);
                    jedis.close();
                    return;
                }
                String key = "KVStore-Test1";
                jedis.del(key);// Initialize
                // -------- Method 1
                Pipeline p1 = jedis.pipelined();
                System.out.println("-----Method 1-----");
                for (int i = 0; i < 5; i++) {
                    p1.incr(key);
                    System.out.println("Pipeline sends request");
                }
                // Requests sent. Start receiving responses.
                System.out.println("Requests sent. Start receiving responses.");
                List<Object> responses = p1.syncAndReturnAll();
                if (responses == null || responses.isEmpty()) {
                    jedis.close();
                    throw new RuntimeException("Pipeline error: No response received");
                }
                for (Object resp : responses) {
                    System.out.println("Pipeline receives response: " + resp.toString());
                }
                System.out.println();
                //-------- Method 2
                System.out.println("-----Method 2-----");
                jedis.del(key);// Initialize
                Pipeline p2 = jedis.pipelined();
                // You must declare the Response object first.
                Response<Long> r1 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r2 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r3 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r4 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r5 = p2.incr(key);
                System.out.println("Pipeline sends request");
                try{
                    r1.get();  // This operation fails because the client has not started to receive responses.
                }catch(Exception e){
                    System.out.println(" <<< Pipeline error: The client has not started to receive responses. >>> ");
                }
             // Requests sent. Start receiving responses.
                System.out.println("Requests sent. Start receiving responses.");
                p2.sync();
                System.out.println("Pipeline receives response: " + r1.get());
                System.out.println("Pipeline receives response: " + r2.get());
                System.out.println("Pipeline receives response: " + r3.get());
                System.out.println("Pipeline receives response: " + r4.get());
                System.out.println("Pipeline receives response: " + r5.get());
                jedis.close();
            }
    }
Después de introducir el endpoint y la contraseña correctos para la instancia de Tair (Redis OSS-compatible) y ejecutar el programa Java, el programa devuelve la siguiente salida:
-----Method 1-----
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
Requests sent. Start receiving responses.
Pipeline receives response: 1
Pipeline receives response: 2
Pipeline receives response: 3
Pipeline receives response: 4
Pipeline receives response: 5

-----Method 2-----
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
 <<< Pipeline error: The client has not started to receive responses. >>>
Requests sent. Start receiving responses.
Pipeline receives response: 1
Pipeline receives response: 2
Pipeline receives response: 3
Pipeline receives response: 4
Pipeline receives response: 5