A medida que escalan las cargas de trabajo de monitoreo, un solo recolector suele ser insuficiente para mantener escrituras de alta frecuencia y la latencia de las consultas aumenta bajo carga concurrente. TairTS, un módulo de series temporales integrado en Tair (Enterprise Edition), resuelve ambos problemas con consultas de latencia en milisegundos y acumulación de escrituras segura ante concurrencia. Este tema muestra cómo usar TairTS para construir un sistema de monitoreo detallado.
Conceptos clave
TairTS organiza los datos de series temporales mediante dos identificadores:
|
Identificador |
Función |
Ejemplo |
|
pkey (clave primaria) |
Agrupa series temporales relacionadas |
|
|
skey (clave secundaria) |
Identifica una serie específica dentro del grupo |
|
Otras capacidades principales:
|
Capacidad |
Descripción |
|
Compresión Gorilla |
Reduce los costos de almacenamiento al aplicar el algoritmo Gorilla con un diseño optimizado para datos de series temporales |
|
TTL por skey |
Cada skey tiene su propio tiempo de vida (TTL), lo que permite renovar automáticamente los datos según ventanas de tiempo |
|
Agregación en un solo comando |
Ejecute consultas por lotes con reducción de muestreo, filtrado basado en atributos y filtrado multinivel en un solo comando para reducir la interacción de red |
Arquitectura
Figura 1. Arquitectura de monitoreo detallado 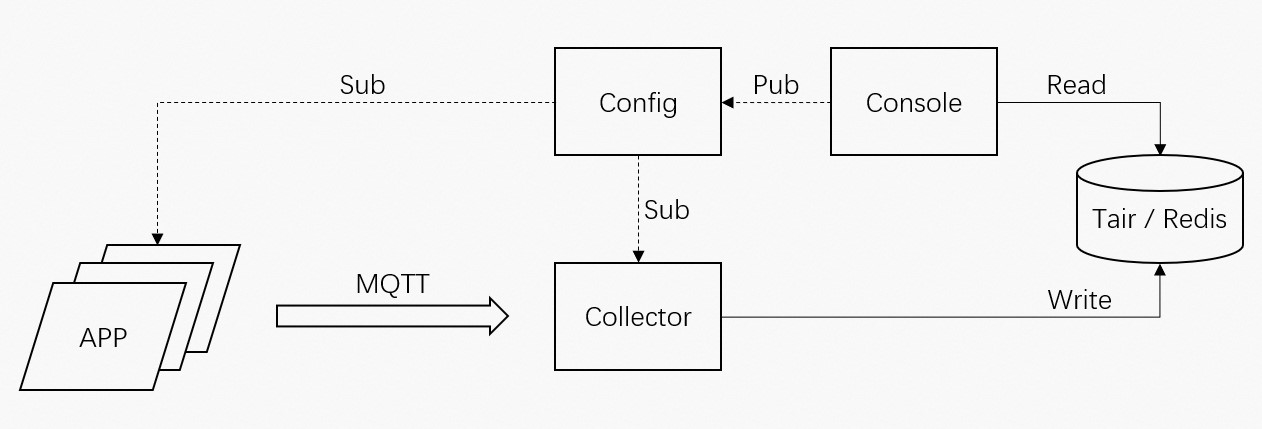
El sistema de monitoreo funciona de la siguiente manera:
La consola envía configuraciones de monitoreo detallado a la aplicación.
La aplicación distribuye las configuraciones a los recolectores mediante MQ Telemetry Transport (MQTT).
Los recolectores procesan los datos entrantes y los escriben en bases de datos Tair mediante comandos de TairTS.
Gestione consultas de alta concurrencia
TairTS admite operaciones de agregación (reducción de muestreo, filtrado basado en atributos, consulta por lotes y filtrado multinivel mediante funciones numéricas) en una sola consulta. Esto reduce la interacción de red y devuelve resultados en milisegundos, lo que permite detectar problemas de inmediato.
Gestione escrituras de alta concurrencia
Conforme escalan las aplicaciones, un solo recolector podría no seguir el ritmo del volumen de escrituras entrantes. TairTS resuelve esto con extsrawincr, que acumula valores entre escrituras concurrentes en lugar de sobrescribirlos. Varios recolectores que escriben en la misma skey con la misma marca de tiempo generan un resultado acumulativo correcto, reducen el uso de memoria y evitan la pérdida de datos.
El siguiente ejemplo demuestra escrituras concurrentes desde dos recolectores hacia la misma pkey (cpu_load) y skey (app1):
import com.aliyun.tair.tairts.TairTs;
import com.aliyun.tair.tairts.params.ExtsAggregationParams;
import com.aliyun.tair.tairts.params.ExtsAttributesParams;
import com.aliyun.tair.tairts.results.ExtsSkeyResult;
import redis.clients.jedis.Jedis;

public class test {

    protected static final String HOST = "127.0.0.1";
    protected static final int PORT = 6379;

    public static void main(String[] args) {
        try {
            Jedis jedis = new Jedis(HOST, PORT, 2000 * 100);
            if (!"PONG".equals(jedis.ping())) {
                System.exit(-1);
            }
            TairTs tairTs = new TairTs(jedis);
            // Use the following code if you want to work with a cluster instance:
            //TairTsCluster tairTsCluster = new TairTsCluster(jedisCluster);

            String pkey = "cpu_load";
            String skey1 = "app1";
            long startTs = (System.currentTimeMillis() - 100000) / 1000 * 1000;
            long endTs = System.currentTimeMillis() / 1000 * 1000;
            String startTsStr = String.valueOf(startTs);
            String endTsStr = String.valueOf(endTs);

            tairTs.extsdel(pkey, skey1);
            long num = 5;

            // Concurrently update data in Collector A.
            for (int i = 0; i < num; i++) {
                double val = i;
                long ts = startTs + i*1000;
                String tsStr = String.valueOf(ts);
                ExtsAttributesParams params = new ExtsAttributesParams();
                params.dataEt(1000000000);
                String addRet = tairTs.extsrawincr(pkey, skey1, tsStr, val, params);
            }

            ExtsAggregationParams paramsAgg = new ExtsAggregationParams();
            paramsAgg.maxCountSize(10);
            paramsAgg.aggAvg(1000);

            System.out.println("Updated result of Collector A:");
            ExtsSkeyResult rangeByteRet = tairTs.extsrange(pkey, skey1, startTsStr, endTsStr, paramsAgg);
            for (int i = 0; i < num; i++) {
                System.out.println("    ts: " + rangeByteRet.getDataPoints().get(i).getTs() + ", value: " + rangeByteRet.getDataPoints().get(i).getDoubleValue());
            }

            // Concurrently update data in Collector B.
            for (int i = 0; i < num; i++) {
                double val = i;
                long ts = startTs + i*1000;
                String tsStr = String.valueOf(ts);
                ExtsAttributesParams params = new ExtsAttributesParams();
                params.dataEt(1000000000);
                String addRet = tairTs.extsrawincr(pkey, skey1, tsStr, val, params);
            }

            System.out.println("Updated result of Collector B:");
            rangeByteRet = tairTs.extsrange(pkey, skey1, startTsStr, endTsStr, paramsAgg);
            for (int i = 0; i < num; i++) {
                System.out.println("    ts: " + rangeByteRet.getDataPoints().get(i).getTs() + ", value: " + rangeByteRet.getDataPoints().get(i).getDoubleValue());
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Ambos recolectores llaman a extsrawincr con las mismas marcas de tiempo y valores. Después de que el Recolector A escribe 5 puntos de datos, la consulta devuelve:
Updated result of Collector A:
    ts: 1597049266000, value: 0.0
    ts: 1597049267000, value: 1.0
    ts: 1597049268000, value: 2.0
    ts: 1597049269000, value: 3.0
    ts: 1597049270000, value: 4.0
Después de que el Recolector B escribe los mismos valores, extsrawincr acumula los nuevos valores sobre los existentes:
Updated result of Collector B:
    ts: 1597049266000, value: 0.0
    ts: 1597049267000, value: 2.0
    ts: 1597049268000, value: 4.0
    ts: 1597049269000, value: 6.0
    ts: 1597049270000, value: 8.0
Cada valor se duplica porque ambos recolectores aportaron cantidades iguales. Este comportamiento de acumulación hace que extsrawincr sea seguro para escrituras concurrentes desde varios recolectores.