Cuando varios hosts compiten por un recurso compartido, se requieren bloqueos distribuidos para evitar la corrupción de datos y los fallos lógicos. Este tema explica el funcionamiento de los bloqueos distribuidos, cómo implementarlos en ApsaraDB for Redis y Tair (Enterprise Edition), y cómo mantener la consistencia del bloqueo tras un failover. Los comandos CAD y CAS específicos de Tair eliminan la necesidad de scripts de Lua requeridos por Redis estándar, lo que reduce la complejidad de implementación y mejora el rendimiento.
Cuándo usar bloqueos distribuidos
Los distintos escenarios de concurrencia requieren diferentes mecanismos de coordinación:
|
Escenario |
Mecanismo |
|
Varios hilos en el mismo proceso |
Mutex o bloqueo de lectura/escritura |
|
Varios procesos en el mismo host |
Semáforo, pipeline o memoria compartida |
|
Varios hosts en un sistema distribuido |
Bloqueo distribuido |
Los bloqueos distribuidos son bloqueos de exclusión mutua con alcance global. Utilícelos para coordinar el acceso a recursos compartidos entre hosts y prevenir fallos lógicos causados por la contención de recursos.
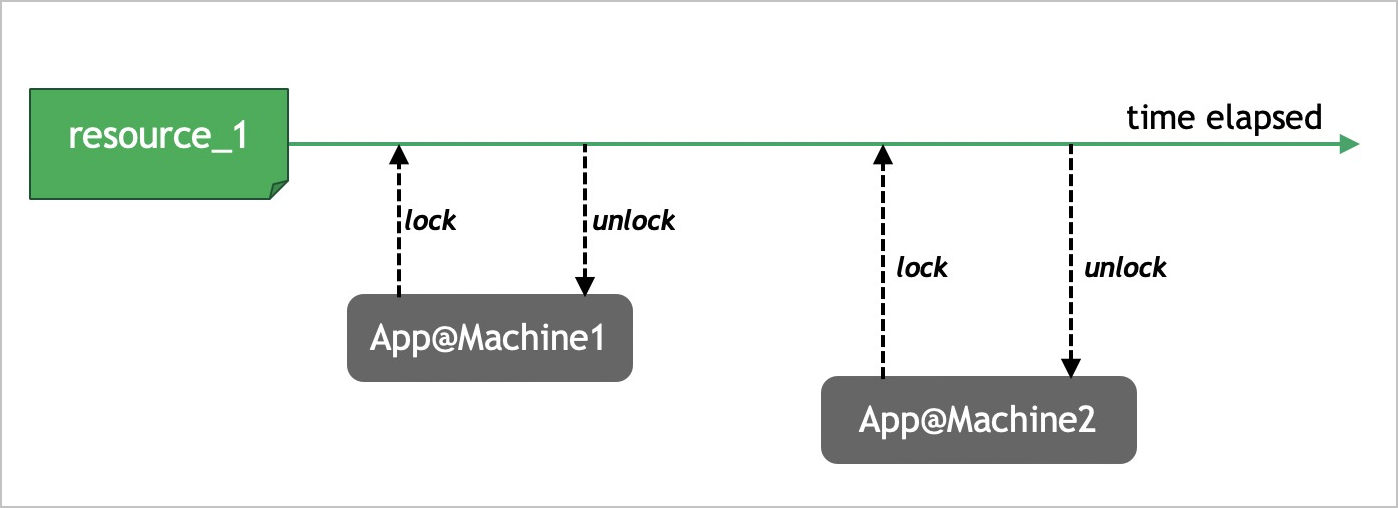
Propiedades de un bloqueo distribuido bien implementado
Un bloqueo distribuido debe cumplir tres propiedades. Cada enfoque de implementación en este tema se evalúa con base en estas propiedades:
Exclusión mutua: En cualquier momento dado, solo un cliente posee el bloqueo.
Libre de interbloqueos: Los bloqueos utilizan un mecanismo basado en concesiones. Si un cliente encuentra una excepción después de adquirir un bloqueo, este expira automáticamente y evita el bloqueo indefinido de recursos.
Consistente: Después de un cambio por alta disponibilidad (HA), el estado del bloqueo debe permanecer intacto. Los cambios pueden desencadenarse por errores externos (fallos de hardware, excepciones de red) o errores internos (consultas lentas, defectos del sistema). Cuando ocurre un cambio, un nodo réplica se promueve como el nuevo nodo maestro.
Implementación de bloqueos distribuidos en Redis
Los métodos de esta sección aplican tanto a ApsaraDB for Redis como a Redis Open-Source Edition.
Adquisición de un bloqueo
Ejecute el comando SET con las opciones NX y EX para adquirir un bloqueo de forma atómica:
SET resource_1 random_value NX EX 5|
Parámetro |
Descripción |
|
|
La clave del bloqueo. Si esta clave existe, el recurso está bloqueado e inaccesible para otros clientes. |
|
|
Una cadena aleatoria única para todos los clientes. Se usa para verificar la propiedad antes de liberar el bloqueo. |
|
|
El periodo de validez del bloqueo en segundos. Use |
|
|
Cancela la operación SET si la clave ya existe. |
En este ejemplo, el bloqueo expira después de 5 segundos si no se libera explícitamente. La expiración previene interbloqueos: si el cliente falla, el sistema recupera el bloqueo automáticamente.
Liberación de un bloqueo
Ejecutar DEL resource_1 directamente no es seguro. Considere este escenario de fallo:
En t1, la aplicación 1 adquiere
resource_1con una concesión de 3 segundos.La aplicación 1 se detiene durante más de 3 segundos. La clave expira en t2 y el bloqueo se libera automáticamente.
En t3, la aplicación 2 adquiere el bloqueo.
La aplicación 1 se reanuda en t4 y ejecuta
DEL resource_1, lo que libera accidentalmente un bloqueo que ya no posee.
Un bloqueo solo debe ser liberado por el cliente que lo estableció. Use el siguiente script de Lua para verificar la propiedad y eliminar de forma atómica:
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end
Renovación de un bloqueo
Si el cliente no puede completar su trabajo dentro del periodo de concesión, debe renovar el bloqueo. Solo el cliente que estableció el bloqueo puede renovarlo:
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("expire", KEYS[1], ARGV[2])
else
    return 0
end
Implementación de bloqueos distribuidos en Tair
Instancias compatibles: Instancias basadas en DRAM de Tair e instancias optimizadas para memoria persistente.
En estas instancias, el tipo de dato TairString proporciona los comandos CAD y CAS. Estos comandos reemplazan los scripts de Lua anteriores con operaciones atómicas únicas, lo que reduce la complejidad de implementación y mejora el rendimiento.
Adquisición de un bloqueo
La adquisición del bloqueo es idéntica al enfoque de Redis:
SET resource_1 random_value NX EX 5Liberación de un bloqueo
El comando CAD (Compare-And-Delete) verifica la propiedad y elimina la clave en una sola operación atómica, lo que reemplaza por completo el script de Lua:
CAD resource_1 my_random_valueEsto equivale a: si GET(resource_1) == my_random_value, ejecute DEL(resource_1).
Renovación de un bloqueo
El comando CAS (Compare-And-Swap) extiende la expiración del bloqueo en una sola operación atómica, lo que reemplaza por completo el script de Lua:
CAS resource_1 my_random_value my_random_value EX 10El comando CAS no verifica si el nuevo valor es igual al valor original. Pase el mismo valor aleatorio tanto para el campo de valor antiguo como para el nuevo a fin de preservar la identidad del bloqueo mientras extiende la concesión.
Código de ejemplo con Jedis
Los siguientes ejemplos en Java muestran un ciclo de vida completo de bloqueo mediante Jedis. Las tres operaciones (adquisición, liberación y renovación) usan la misma resourceKey y el mismo randomValue.
Definición de los comandos CAS y CAD
enum TairCommand implements ProtocolCommand {
    CAD("CAD"), CAS("CAS");

    private final byte[] raw;

    TairCommand(String alt) {
        raw = SafeEncoder.encode(alt);
    }

    @Override
    public byte[] getRaw() {
        return raw;
    }
}
Adquisición de un bloqueo
public boolean acquireDistributedLock(Jedis jedis, String resourceKey, String randomValue, int expireTime) {
    SetParams setParams = new SetParams();
    setParams.nx().ex(expireTime);
    String result = jedis.set(resourceKey, randomValue, setParams);
    return "OK".equals(result);
}
Liberación de un bloqueo
public boolean releaseDistributedLock(Jedis jedis, String resourceKey, String randomValue) {
    jedis.getClient().sendCommand(TairCommand.CAD, resourceKey, randomValue);
    Long ret = jedis.getClient().getIntegerReply();
    return 1 == ret;
}
Renovación de un bloqueo
public boolean renewDistributedLock(Jedis jedis, String resourceKey, String randomValue, int expireTime) {
    jedis.getClient().sendCommand(TairCommand.CAS, resourceKey, randomValue, randomValue, "EX", String.valueOf(expireTime));
    Long ret = jedis.getClient().getIntegerReply();
    return 1 == ret;
}
Garantía de la consistencia del bloqueo tras un failover
La replicación de maestro a réplica es asíncrona. Si un nodo maestro falla después de escribir un bloqueo pero antes de que se replique la escritura, la réplica promovida no tendrá registro de dicho bloqueo. Dos clientes podrían entonces poseer el mismo bloqueo simultáneamente, lo que viola la propiedad de consistencia.
Tres enfoques abordan este riesgo:
|
Enfoque |
Costo |
Limitaciones |
Ideal para |
|
Algoritmo Redlock |
Alto (requiere varias instancias) |
No se puede usar con instancias de clúster o instancias maestro-réplica estándar; adquisición de bloqueo más lenta |
Requisitos máximos de tolerancia a fallos |
|
Comando WAIT |
Bajo |
No garantiza la consistencia si ocurre un cambio antes de que WAIT retorne |
Despliegues estándar donde el costo es relevante |
|
Replicación semisíncrona de Tair |
Integrado |
Se degrada a asíncrono si falla una réplica |
Cargas de trabajo de alta concurrencia en instancias Tair |
Uso del algoritmo Redlock
El algoritmo Redlock, propuesto por los fundadores del proyecto de código abierto Redis, reduce la probabilidad de pérdida de bloqueo al distribuir los bloqueos en N instancias independientes de Redis. Una sola instancia maestro-réplica puede perder un bloqueo con una probabilidad de k% durante un cambio. Con Redlock, la probabilidad de que las N instancias pierdan sus bloqueos simultáneamente cae a (k%)^N.
El algoritmo requiere que los bloqueos tengan éxito en M de N nodos, donde 1 < M ≤ N. No es necesario que los N bloqueos tengan éxito simultáneamente.
Compromisos de Redlock:
La adquisición y liberación de bloqueos son más lentas porque intervienen varias instancias.
Requiere varias instancias independientes de ApsaraDB for Redis o de Redis autogestionado, lo que incrementa los costos de infraestructura.
Es incompatible con instancias de clúster e instancias maestro-réplica estándar.
Uso del comando WAIT
El comando WAIT bloquea al cliente actual hasta que todos los comandos de escritura anteriores se repliquen en un número especificado de nodos réplica, o hasta que expire el tiempo de espera (en milisegundos). El comando WAIT es mucho más rentable que el algoritmo Redlock.
Después de adquirir un bloqueo, ejecute WAIT para confirmar la replicación:
SET resource_1 random_value NX EX 5
WAIT 1 5000
En este ejemplo, el periodo de tiempo de espera es de 5,000 milisegundos. Si WAIT retorna 1, los datos están sincronizados entre el nodo maestro y los nodos réplica, y se garantiza la consistencia. Sin embargo, si se activa un cambio por HA antes de que WAIT retorne una respuesta exitosa, los datos podrían perderse; el valor de retorno solo indica un posible fallo de sincronización. Después de que WAIT retorne un error, vuelva a adquirir el bloqueo o verifique su estado antes de continuar.
Notas de uso:
WAIT solo bloquea al cliente que lo envía; los demás clientes no se ven afectados.
No ejecute WAIT antes de liberar un bloqueo. Los bloqueos distribuidos son exclusivos por diseño, por lo que una liberación ligeramente retrasada no causa fallos lógicos.
Uso de Tair
Las instancias basadas en DRAM de Tair abordan la consistencia de los bloqueos a nivel de infraestructura:
Rendimiento 3x: Las instancias basadas en DRAM de Tair ofrecen tres veces el rendimiento de Redis de código abierto, y mantienen cargas de trabajo de bloqueo de alta concurrencia sin interrupción del servicio.
Replicación semisíncrona: Se retorna una respuesta exitosa solo después de que la escritura se confirma en el nodo maestro y se replica en como mínimo un nodo réplica. Esto evita la pérdida de bloqueos tras un cambio.
La replicación semisíncrona se degrada a replicación asíncrona si falla un nodo réplica o si ocurre una excepción de red durante la sincronización.
Los comandos CAD y CAS reducen aún más la complejidad de implementación en comparación con los scripts de Lua y eliminan la necesidad de múltiples instancias independientes que requiere Redlock.