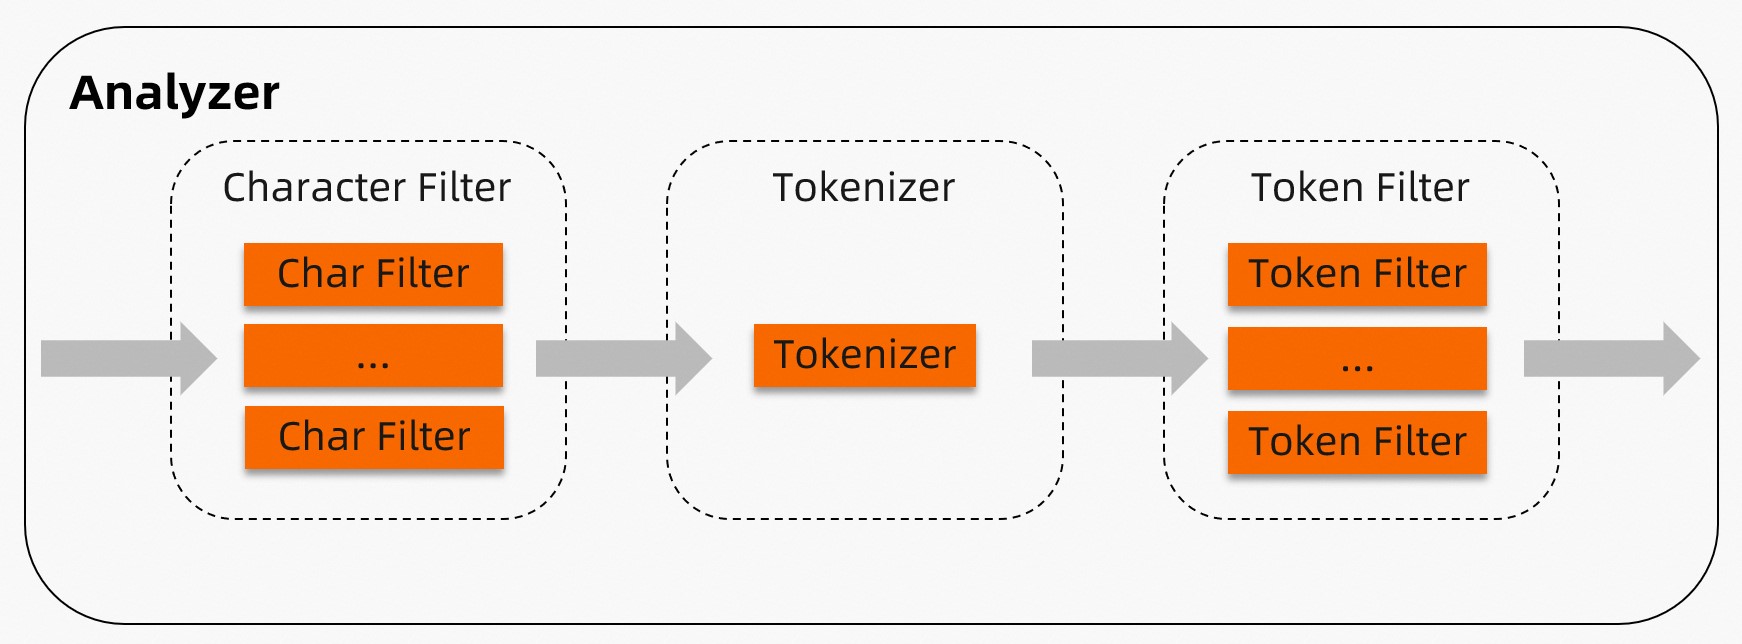
Los analizadores procesan y tokenizan campos de texto para que TairSearch pueda crear un índice y responder a consultas de texto completo. Cada analizador ejecuta tres etapas en orden: filtros de caracteres, un tokenizer y filtros de tokens. TairSearch incluye nueve analizadores integrados. Si tiene requisitos especializados, puede construir un analizador personalizado a partir de componentes individuales.
|
Etapa |
Propósito |
Cantidad por analizador |
|
Filtro de caracteres |
Preprocesa el texto sin formato antes de la tokenización (por ejemplo, reemplaza |
Cero o más, se ejecutan en orden |
|
Tokenizer |
Divide el texto preprocesado en tokens |
Exactamente uno |
|
Filtro de tokens |
Post-procesa cada token (por ejemplo, conversión a minúsculas, eliminación de palabras vacías, stemming) |
Cero o más, se ejecutan en orden |
Elegir un analizador
|
Analizador |
Ideal para |
Tokeniza por |
Convierte a minúsculas |
Filtra palabras vacías |
|
Standard |
La mayoría de los idiomas |
Límites de palabras Unicode |
Sí |
Sí |
|
Stop |
La mayoría de los idiomas (enfoque en palabras vacías) |
Caracteres no alfabéticos |
Sí |
Sí |
|
Jieba |
Texto en chino |
Diccionario entrenado |
Solo tokens en inglés |
Sí |
|
IK |
Texto en chino (compatible con Elasticsearch) |
Diccionario entrenado (dos modos) |
Sí (predeterminado) |
Opcional |
|
Pattern |
Lógica de delimitadores personalizados |
Patrón regex |
Opcional |
Opcional |
|
Whitespace |
Texto pre-tokenizado o estructurado |
Caracteres de espacio en blanco |
No |
No |
|
Simple |
Texto occidental, sin distinción entre mayúsculas y minúsculas |
Caracteres no alfabéticos |
Sí |
No |
|
Keyword |
Campos de coincidencia exacta |
Sin división (todo el campo = un token) |
No |
No |
|
Language |
Idiomas naturales específicos |
Reglas específicas del idioma |
Sí |
Sí |
Funcionamiento
Un analizador procesa un documento a través de tres etapas secuenciales.
Etapa 1 — Filtro de caracteres: Cero o más filtros de caracteres preprocesan el texto sin formato del documento. Los filtros se ejecutan en el orden en que aparecen. Por ejemplo, un filtro de caracteres de asignación puede reemplazar "(:" con "happy" antes de que comience la tokenización.
Etapa 2 — Tokenizer: Exactamente un tokenizer divide el texto (posiblemente filtrado) en tokens. Por ejemplo, el tokenizer de espacios en blanco divide "I am very happy" en ["I", "am", "very", "happy"].
Etapa 3 — Filtro de tokens: Cero o más filtros de tokens post-procesan los tokens generados por el tokenizer. Los filtros se ejecutan en el orden en que aparecen. Por ejemplo, el filtro de tokens de parada elimina palabras comunes como "the" y "is".
Analizadores integrados
Standard
El analizador estándar es la opción predeterminada para la mayoría de los idiomas. Divide el texto según los límites de palabras Unicode (de acuerdo con el Anexo #29 del Estándar Unicode), convierte todos los tokens a minúsculas y elimina las palabras vacías comunes.
Components: standard tokenizer → lowercase token filter → stop token filter
No se incluyen filtros de caracteres.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de palabras vacías para filtrar. Reemplaza la lista predeterminada en su totalidad. |
Consulte abajo |
|
|
Longitud máxima de caracteres por token. Los tokens que superen este límite se dividen. |
255 |
Palabras vacías predeterminadas:
["a", "an", "and", "are", "as", "at", "be", "but", "by", "for", "if", "in",
 "into", "is", "it", "no", "not", "of", "on", "or", "such", "that", "the",
 "their", "then", "there", "these", "they", "this", "to", "was", "will", "with"]
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "standard"
      }
    }
  }
}
// Custom stop words and token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "standard",
"max_token_length": 10,
"stopwords": ["memory", "disk", "is", "a"]
}
}
}
}
}Stop
El analizador stop divide el texto en cualquier carácter no alfabético, convierte todos los tokens a minúsculas y elimina las palabras vacías.
Components: lowercase tokenizer → stop token filter
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de palabras vacías para filtrar. Reemplaza la lista predeterminada en su totalidad. |
Igual que standard |
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "stop"
      }
    }
  }
}
// Custom stop words
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "stop",
"stopwords": ["memory", "disk", "is", "a"]
}
}
}
}
}Jieba
El analizador jieba se recomienda para texto en chino. Divide el texto mediante la segmentación basada en diccionarios de jieba, convierte los tokens en inglés a minúsculas y elimina las palabras vacías.
Components: jieba tokenizer → lowercase token filter → stop token filter
El analizador jieba carga un diccionario integrado de 20 MB en memoria. Solo se carga una copia de forma global. El primer uso de jieba puede provocar un breve aumento de latencia mientras se carga el diccionario.
Las palabras en un diccionario personalizado no pueden contener espacios ni ninguno de los siguientes caracteres:
\t,\n,,,。
Parámetros opcionales:
| Parámetro | Descripción | Valor predeterminado |
|---|---|---|
userwords |
Arreglo de cadenas que se agregan al diccionario predeterminado. Consulte el diccionario predeterminado de Jiebadiccionario predeterminado de jieba. | Vacío |
use_hmm |
Usa un modelo oculto de Markov (HMM) para manejar palabras fuera del vocabulario. | true |
stopwords |
Arreglo de palabras vacías para filtrar. Reemplaza la lista predeterminada en su totalidad. Consulte las palabras vacías predeterminadas de Jiebapalabras vacías predeterminadas de jieba. | Lista integrada |
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "jieba"
      }
    }
  }
}
// Custom dictionary, stop words, and HMM
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "jieba",
"stopwords": ["memory", "disk", "is", "a"],
"userwords": ["Redis", "open-source", "flexible"],
"use_hmm": true
}
}
}
}
}IK
El analizador IK divide texto en chino y es compatible con el complemento del analizador IK para Alibaba Cloud Elasticsearch. Admite dos modos:
ik_max_word: identifica todos los tokens posibles.ik_smart: filtra los resultados del modoik_max_wordpara identificar los tokens más probables.
Componentes: IK tokenizer (sin filtros de tokens de forma predeterminada)
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de palabras vacías para filtrar. Reemplaza la lista predeterminada en su totalidad. |
Igual que standard |
|
|
Arreglo de cadenas que se agregan al diccionario IK predeterminado. Consulte el diccionario IK predeterminado. |
Vacío |
|
|
Arreglo de cuantificadores que se agregan al diccionario de cuantificadores IK predeterminado. Consulte el diccionario de cuantificadores predeterminado. |
Vacío |
|
|
Convierte letras mayúsculas a minúsculas antes de la tokenización. |
|
Si su diccionario personalizado contiene letras mayúsculas, establezca enable_lowercase en false. La conversión a minúsculas ocurre antes de la división, por lo que las entradas en mayúsculas del diccionario nunca coincidirían.
Ejemplos de configuración:
// Default configuration: both IK modes
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "ik_smart"
      },
      "f1": {
        "type": "text",
        "analyzer": "ik_max_word"
      }
    }
  }
}
// Custom stop words, dictionary, and quantifiers
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_ik_smart_analyzer"
},
"f1": {
"type": "text",
"analyzer": "my_ik_max_word_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_ik_smart_analyzer": {
"type": "ik_smart",
"stopwords": ["memory", "disk", "is", "a"],
"userwords": ["Redis", "open-source", "flexible"],
"quantifiers": ["ns"],
"enable_lowercase": false
},
"my_ik_max_word_analyzer": {
"type": "ik_max_word",
"stopwords": ["memory", "disk", "is", "a"],
"userwords": ["Redis", "open-source", "flexible"],
"quantifiers": ["ns"],
"enable_lowercase": false
}
}
}
}
}Pattern
El analizador pattern divide el texto mediante una expresión regular. De forma predeterminada, el texto coincidente se trata como un delimitador (los tokens son el texto entre las coincidencias). También convierte los tokens a minúsculas y filtra las palabras vacías.
Components: pattern tokenizer → lowercase token filter → stop token filter
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Expresión regular. El texto que coincide con el patrón se usa como delimitador. Consulte la sintaxis RE2. |
|
|
|
Arreglo de palabras vacías. Reemplaza la lista predeterminada en su totalidad. |
Igual que standard |
|
|
Convierte los tokens a minúsculas. |
|
|
|
Establezca en |
Vacío (distingue mayúsculas y minúsculas) |
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "pattern"
      }
    }
  }
}
// Custom pattern with case-insensitive matching
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "pattern",
"pattern": "\\'([^\\']+)\\'",
"stopwords": ["aaa", "@"],
"lowercase": false,
"flags": "CASE_INSENSITIVE"
}
}
}
}
}Whitespace
El analizador whitespace divide el texto en los caracteres de espacio en blanco. No convierte los tokens a minúsculas ni elimina las palabras vacías.
Componentes: whitespace tokenizer
Parámetros opcionales: Ninguno
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "whitespace"
      }
    }
  }
}
Simple
El analizador simple divide el texto en cualquier carácter no alfabético y convierte todos los tokens a minúsculas. No filtra palabras vacías.
Componentes: lowercase tokenizer
Parámetros opcionales: Ninguno
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "simple"
      }
    }
  }
}
Keyword
El analizador keyword trata todo el valor del campo como un solo token sin ninguna división. Úselo para campos que requieren consultas de coincidencia exacta, como identificadores, códigos de estado o etiquetas.
Componentes: keyword tokenizer
Parámetros opcionales: Ninguno
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "keyword"
      }
    }
  }
}
Language
El analizador language admite tokenización específica del idioma y eliminación de palabras vacías para un conjunto fijo de idiomas: arabic, cjk, chinese, brazilian, czech, german, greek, persian, french, dutch y russian.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
Idiomas compatibles |
|
|
Arreglo de palabras vacías. Reemplaza la lista predeterminada. Consulte Appendix 4 para ver los valores predeterminados. |
Específico del idioma |
Todos excepto |
|
|
Arreglo de palabras cuyas raíces no se extraen. Por ejemplo, agregar |
Vacío |
|
Las palabras vacías del analizador chinese no se pueden modificar.
Ejemplos de configuración:
// Default configuration (Arabic)
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "arabic"
      }
    }
  }
}
// Custom stop words and stem exclusion (German)
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "german",
"stopwords": ["ein"],
"stem_exclusion": ["speicher"]
}
}
}
}
}Analizadores personalizados
Construya un analizador personalizado cuando ningún analizador integrado se ajuste a sus necesidades. Defina el analizador en settings y haga referencia a él por su nombre en mappings.
Parámetros:
|
Parámetro |
Obligatorio |
Descripción |
Valores válidos |
|
|
Sí |
Identifica esto como un analizador personalizado. |
|
|
|
Sí |
El tokenizer que se usará. Solo se permite uno. |
|
|
|
No |
Arreglo de filtros de caracteres para aplicar antes de la tokenización. |
|
|
|
No |
Arreglo de filtros de tokens para aplicar después de la tokenización. |
|
Ejemplo: analizador personalizado con reemplazo de emoticonos y eliminación de palabras vacías
// Character filters replace emoticons and expand "&" before tokenization.
// The whitespace tokenizer splits on spaces.
// Token filters lowercase and remove stop words.
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["lowercase", "stop"],
          "char_filter": ["emoticons", "conjunctions"]
        }
      },
      "char_filter": {
        "emoticons": {
          "type": "mapping",
          "mappings": [":) => _happy_", ":( => _sad_"]
        },
        "conjunctions": {
          "type": "mapping",
          "mappings": ["&=>and"]
        }
      }
    }
  }
}
Apéndice 1: Filtros de caracteres compatibles
Filtro de caracteres mapping
Reemplaza cadenas especificadas mediante pares clave-valor. Cuando la entrada contiene una clave, se reemplaza con el valor correspondiente. Se pueden usar varios filtros de caracteres de asignación en un solo analizador.
Parámetros:
|
Parámetro |
Obligatorio |
Descripción |
|
|
Sí |
Arreglo de reglas de reemplazo. Cada regla debe usar el formato |
Ejemplo de configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "standard",
          "char_filter": ["emoticons"]
        }
      },
      "char_filter": {
        "emoticons": {
          "type": "mapping",
          "mappings": [":) => _happy_", ":( => _sad_"]
        }
      }
    }
  }
}
Apéndice 2: Tokenizers compatibles
whitespace
Divide el texto en los caracteres de espacio en blanco. Los tokens que excedan max_token_length se dividen en el límite.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Longitud máxima de caracteres por token. Los tokens que superen este límite se dividen. |
255 |
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace"
        }
      }
    }
  }
}
// Custom max token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "whitespace",
"max_token_length": 2
}
}
}
}
}standard
Divide el texto mediante el algoritmo de segmentación de texto Unicode (Anexo #29 del Estándar Unicode). Adecuado para la mayoría de los idiomas.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Longitud máxima de caracteres por token. Los tokens que superen este límite se dividen. |
255 |
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "standard"
        }
      }
    }
  }
}
// Custom max token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "standard",
"max_token_length": 2
}
}
}
}
}classic
Divide el texto mediante reglas gramaticales del inglés y maneja patrones específicos de forma especial:
Divide en signos de puntuación y los elimina. Los puntos (
.) rodeados de caracteres que no son espacios en blanco se conservan; por ejemplo,red.appleno se divide, perored. appleproduceredyapple.Divide en guiones, a menos que el token contenga dígitos (se interpreta como un número de producto y se mantiene intacto).
Reconoce direcciones de correo electrónico y nombres de host como tokens únicos.
Los tokens que excedan max_token_length se omiten, no se dividen.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Longitud máxima de caracteres por token. Los tokens que superen este límite se omiten. |
255 |
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "classic"
        }
      }
    }
  }
}
// Custom max token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "classic",
"max_token_length": 2
}
}
}
}
}letter
Divide el texto en cualquier carácter no alfabético. Funciona bien para idiomas europeos.
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "letter"
        }
      }
    }
  }
}
lowercase
Divide el texto en cualquier carácter no alfabético y convierte todos los tokens a minúsculas. Equivale a combinar el tokenizer letter con el filtro de tokens lowercase, pero es más rápido porque recorre el documento solo una vez.
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "lowercase"
        }
      }
    }
  }
}
keyword
Trata toda la entrada como un solo token sin dividirla. Normalmente se combina con un filtro de tokens como lowercase.
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "keyword"
        }
      }
    }
  }
}
jieba
Divide texto en chino mediante un diccionario entrenado. Recomendado para campos en idioma chino.
Las palabras en un diccionario personalizado no pueden contener espacios ni ninguno de los siguientes caracteres: \t, \n, ,, 。
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de cadenas que se agregan al diccionario predeterminado. Consulte el diccionario predeterminado de jieba. |
Vacío |
|
|
Usa un modelo oculto de Markov (HMM) para manejar palabras fuera del vocabulario. |
|
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "jieba"
        }
      }
    }
  }
}
// Custom dictionary
{
"mappings": {
"properties": {
"f1": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "jieba",
"userwords": ["Redis", "open-source", "flexible"],
"use_hmm": true
}
}
}
}
}pattern
Divide el texto mediante una expresión regular. El texto coincidente se trata como un delimitador de forma predeterminada. Use el parámetro group para tratar el texto coincidente como tokens en su lugar.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Expresión regular. Consulte la sintaxis RE2. |
|
|
|
Controla cómo se usa el resultado de la expresión regular. |
|
|
|
Establezca en |
Vacío (distingue mayúsculas y minúsculas) |
Ejemplo del comportamiento de group:
Regex: "a(b+)c", entrada: "abbbcdefabc"
group: 0→ tokens:[ abbbc, abc ](coincidencias completas)group: 1→ tokens:[ bbb, b ](primer grupo de captura)
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "pattern"
        }
      }
    }
  }
}
// Custom pattern with capture group
{
"mappings": {
"properties": {
"f1": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "pattern_tokenizer"
}
},
"tokenizer": {
"pattern_tokenizer": {
"type": "pattern",
"pattern": "AB(A(\\w+)C)",
"flags": "CASE_INSENSITIVE",
"group": 2
}
}
}
}
}IK
Divide texto en chino. Admite dos modos:
ik_max_word: identifica todos los tokens posibles (granularidad máxima).ik_smart: identifica los tokens más probables (granularidad más gruesa).
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de palabras vacías. Reemplaza la lista predeterminada en su totalidad. |
Igual que standard |
|
|
Arreglo de cadenas que se agregan al diccionario IK predeterminado. Consulte el diccionario IK predeterminado. |
Vacío |
|
|
Arreglo de cuantificadores que se agregan al diccionario de cuantificadores predeterminado. Consulte el diccionario de cuantificadores predeterminado. |
Vacío |
|
|
Convierte letras mayúsculas a minúsculas antes de la tokenización. |
|
Si su diccionario personalizado contiene letras mayúsculas, establezca enable_lowercase en false. La conversión a minúsculas ocurre antes de la división.
Ejemplos de configuración:
// Default configuration: both IK modes
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_ik_smart_analyzer"
      },
      "f1": {
        "type": "text",
        "analyzer": "my_custom_ik_max_word_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_ik_smart_analyzer": {
          "type": "custom",
          "tokenizer": "ik_smart"
        },
        "my_custom_ik_max_word_analyzer": {
          "type": "custom",
          "tokenizer": "ik_max_word"
        }
      }
    }
  }
}
// Custom dictionary, stop words, and quantifiers
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_ik_smart_analyzer"
},
"f1": {
"type": "text",
"analyzer": "my_custom_ik_max_word_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_ik_smart_analyzer": {
"type": "custom",
"tokenizer": "my_ik_smart_tokenizer"
},
"my_custom_ik_max_word_analyzer": {
"type": "custom",
"tokenizer": "my_ik_max_word_tokenizer"
}
},
"tokenizer": {
"my_ik_smart_tokenizer": {
"type": "ik_smart",
"userwords": ["The tokenizer for the Chinese language", "The custom stop words"],
"stopwords": ["about", "test"],
"quantifiers": ["ns"],
"enable_lowercase": false
},
"my_ik_max_word_tokenizer": {
"type": "ik_max_word",
"userwords": ["The tokenizer for the Chinese language", "The custom stop words"],
"stopwords": ["about", "test"],
"quantifiers": ["ns"],
"enable_lowercase": false
}
}
}
}
}Apéndice 3: Filtros de tokens compatibles
classic
Elimina el posesivo 's del final de los tokens y quita los puntos de los acrónimos. Por ejemplo, Fig. se convierte en Fig.
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "classic",
          "filter": ["classic"]
        }
      }
    }
  }
}
elision
Elimina las elisiones especificadas al inicio de los tokens. Se utiliza principalmente para texto en francés (por ejemplo, l'avion → avion).
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de elisiones que se deben eliminar. Reemplaza por completo la lista predeterminada. |
|
|
|
Indica si la coincidencia de elisiones distingue entre mayúsculas y minúsculas. |
|
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["elision"]
        }
      }
    }
  }
}
// Custom elisions with case-sensitive matching
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["elision_filter"]
}
},
"filter": {
"elision_filter": {
"type": "elision",
"articles": ["l", "m", "t", "qu", "n", "s", "j"],
"articles_case": true
}
}
}
}
}lowercase
Convierte todos los tokens a minúsculas.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valores válidos |
|
|
Aplica reglas de conversión a minúsculas específicas del idioma. Si no se establece, se aplican las reglas estándar del inglés. |
|
Ejemplos de configuración:
// Default configuration (English)
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["lowercase"]
        }
      }
    }
  }
}
// Language-specific lowercasing (Greek and Russian)
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_greek_analyzer"
},
"f1": {
"type": "text",
"analyzer": "my_custom_russian_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_greek_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["greek_lowercase"]
},
"my_custom_russian_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["russian_lowercase"]
}
},
"filter": {
"greek_lowercase": {
"type": "lowercase",
"language": "greek"
},
"russian_lowercase": {
"type": "lowercase",
"language": "russian"
}
}
}
}
}snowball
Extrae la raíz de cada token. Por ejemplo, cats se convierte en cat y running se convierte en run.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
Valores válidos |
|
|
El idioma cuyas reglas de extracción de raíces se deben aplicar. |
|
|
Ejemplos de configuración:
// Default configuration (English)
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["snowball"]
        }
      }
    }
  }
}
// English stemming with standard tokenizer
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "standard",
"filter": ["my_filter"]
}
},
"filter": {
"my_filter": {
"type": "snowball",
"language": "english"
}
}
}
}
}stop
Elimina las palabras vacías del flujo de tokens.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Arreglo de palabras vacías. Reemplaza por completo la lista predeterminada. |
Igual que el estándar |
|
|
Indica si la coincidencia de palabras vacías no distingue entre mayúsculas y minúsculas. |
|
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["stop"]
        }
      }
    }
  }
}
// Custom stop words with case-insensitive matching
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "standard",
"filter": ["stop_filter"]
}
},
"filter": {
"stop_filter": {
"type": "stop",
"stopwords": ["the"],
"ignore_case": true
}
}
}
}
}asciifolding
Convierte caracteres alfabéticos, numéricos y simbólicos fuera del bloque Unicode Basic Latin a sus equivalentes ASCII. Por ejemplo, é se convierte en e y ü se convierte en u. Utilice este filtro para normalizar caracteres acentuados en texto europeo.
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "standard",
          "filter": ["asciifolding"]
        }
      }
    }
  }
}
length
Elimina los tokens cuya longitud es menor o mayor que los límites de caracteres especificados.
Parámetros opcionales:
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Número mínimo de caracteres que debe tener un token para conservarse. |
|
|
|
Número máximo de caracteres que puede tener un token para conservarse. |
|
Ejemplos de configuración:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["length"]
        }
      }
    }
  }
}
// Keep only tokens between 2 and 5 characters
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["length_filter"]
}
},
"filter": {
"length_filter": {
"type": "length",
"max": 5,
"min": 2
}
}
}
}
}Normalización
Normaliza caracteres específicos de un idioma. Utilice arabic_normalization para texto en árabe y persian_normalization para texto en persa. Combine este filtro con el tokenizer estándar para obtener mejores resultados.
Configuración:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_arabic_analyzer"
      },
      "f1": {
        "type": "text",
        "analyzer": "my_persian_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_arabic_analyzer": {
          "type": "custom",
          "tokenizer": "arabic",
          "filter": ["arabic_normalization"]
        },
        "my_persian_analyzer": {
          "type": "custom",
          "tokenizer": "arabic",
          "filter": ["persian_normalization"]
        }
      }
    }
  }
}
Apéndice 4: Palabras vacías predeterminadas para analizadores de idioma
arabic
["من","ومن","منها","منه","في","وفي","فيها","فيه","و","ف","ثم","او","أو","ب","بها","به","ا","أ","اى","اي","أي","أى","لا","ولا","الا","ألا","إلا","لكن","ما","وما","كما","فما","عن","مع","اذا","إذا","ان","أن","إن","انها","أنها","إنها","انه","أنه","إنه","بان","بأن","فان","فأن","وان","وأن","وإن","التى","التي","الذى","الذي","الذين","الى","الي","إلى","إلي","على","عليها","عليه","اما","أما","إما","ايضا","أيضا","كل","وكل","لم","ولم","لن","ولن","هى","هي","هو","وهى","وهي","وهو","فهى","فهي","فهو","انت","أنت","لك","لها","له","هذه","هذا","تلك","ذلك","هناك","كانت","كان","يكون","تكون","وكانت","وكان","غير","بعض","قد","نحو","بين","بينما","منذ","ضمن","حيث","الان","الآن","خلال","بعد","قبل","حتى","عند","عندما","لدى","جميع"]cjk
["with","will","to","this","there","then","the","t","that","such","s","on","not","no","it","www","was","is","","into","their","or","in","if","for","by","but","they","be","these","at","are","as","and","of","a"]brazilian
["uns","umas","uma","teu","tambem","tal","suas","sobre","sob","seu","sendo","seja","sem","se","quem","tua","que","qualquer","porque","por","perante","pelos","pelo","outros","outro","outras","outra","os","o","nesse","nas","na","mesmos","mesmas","mesma","um","neste","menos","quais","mediante","proprio","logo","isto","isso","ha","estes","este","propios","estas","esta","todas","esses","essas","toda","entre","nos","entao","em","eles","qual","elas","tuas","ela","tudo","do","mesmo","diversas","todos","diversa","seus","dispoem","ou","dispoe","teus","deste","quer","desta","diversos","desde","quanto","depois","demais","quando","essa","deles","todo","pois","dele","dela","dos","de","da","nem","cujos","das","cujo","durante","cujas","portanto","cuja","contudo","ele","contra","como","com","pelas","assim","as","aqueles","mais","esse","aquele","mas","apos","aos","aonde","sua","e","ao","antes","nao","ambos","ambas","alem","ainda","a"]czech
["a","s","k","o","i","u","v","z","dnes","cz","tímto","budeš","budem","byli","jseš","muj","svým","ta","tomto","tohle","tuto","tyto","jej","zda","proc","máte","tato","kam","tohoto","kdo","kterí","mi","nám","tom","tomuto","mít","nic","proto","kterou","byla","toho","protože","asi","ho","naši","napište","re","což","tím","takže","svých","její","svými","jste","aj","tu","tedy","teto","bylo","kde","ke","pravé","ji","nad","nejsou","ci","pod","téma","mezi","pres","ty","pak","vám","ani","když","však","neg","jsem","tento","clánku","clánky","aby","jsme","pred","pta","jejich","byl","ješte","až","bez","také","pouze","první","vaše","která","nás","nový","tipy","pokud","muže","strana","jeho","své","jiné","zprávy","nové","není","vás","jen","podle","zde","už","být","více","bude","již","než","který","by","které","co","nebo","ten","tak","má","pri","od","po","jsou","jak","další","ale","si","se","ve","to","jako","za","zpet","ze","do","pro","je","na","atd","atp","jakmile","pricemž","já","on","ona","ono","oni","ony","my","vy","jí","ji","me","mne","jemu","tomu","tem","temu","nemu","nemuž","jehož","jíž","jelikož","jež","jakož","nacež"]german
["wegen","mir","mich","dich","dir","ihre","wird","sein","auf","durch","ihres","ist","aus","von","im","war","mit","ohne","oder","kein","wie","was","es","sie","mein","er","du","daß","dass","die","als","ihr","wir","der","für","das","einen","wer","einem","am","und","eines","eine","in","einer"]greek
["ο","η","το","οι","τα","του","τησ","των","τον","την","και","κι","κ","ειμαι","εισαι","ειναι","ειμαστε","ειστε","στο","στον","στη","στην","μα","αλλα","απο","για","προσ","με","σε","ωσ","παρα","αντι","κατα","μετα","θα","να","δε","δεν","μη","μην","επι","ενω","εαν","αν","τοτε","που","πωσ","ποιοσ","ποια","ποιο","ποιοι","ποιεσ","ποιων","ποιουσ","αυτοσ","αυτη","αυτο","αυτοι","αυτων","αυτουσ","αυτεσ","αυτα","εκεινοσ","εκεινη","εκεινο","εκεινοι","εκεινεσ","εκεινα","εκεινων","εκεινουσ","οπωσ","ομωσ","ισωσ","οσο","οτι"]persian
["انان","نداشته","سراسر","خياه","ايشان","وي","تاكنون","بيشتري","دوم","پس","ناشي","وگو","يا","داشتند","سپس","هنگام","هرگز","پنج","نشان","امسال","ديگر","گروهي","شدند","چطور","ده","و","دو","نخستين","ولي","چرا","چه","وسط","ه","كدام","قابل","يك","رفت","هفت","همچنين","در","هزار","بله","بلي","شايد","اما","شناسي","گرفته","دهد","داشته","دانست","داشتن","خواهيم","ميليارد","وقتيكه","امد","خواهد","جز","اورده","شده","بلكه","خدمات","شدن","برخي","نبود","بسياري","جلوگيري","حق","كردند","نوعي","بعري","نكرده","نظير","نبايد","بوده","بودن","داد","اورد","هست","جايي","شود","دنبال","داده","بايد","سابق","هيچ","همان","انجا","كمتر","كجاست","گردد","كسي","تر","مردم","تان","دادن","بودند","سري","جدا","ندارند","مگر","يكديگر","دارد","دهند","بنابراين","هنگامي","سمت","جا","انچه","خود","دادند","زياد","دارند","اثر","بدون","بهترين","بيشتر","البته","به","براساس","بيرون","كرد","بعضي","گرفت","توي","اي","ميليون","او","جريان","تول","بر","مانند","برابر","باشيم","مدتي","گويند","اكنون","تا","تنها","جديد","چند","بي","نشده","كردن","كردم","گويد","كرده","كنيم","نمي","نزد","روي","قصد","فقط","بالاي","ديگران","اين","ديروز","توسط","سوم","ايم","دانند","سوي","استفاده","شما","كنار","داريم","ساخته","طور","امده","رفته","نخست","بيست","نزديك","طي","كنيد","از","انها","تمامي","داشت","يكي","طريق","اش","چيست","روب","نمايد","گفت","چندين","چيزي","تواند","ام","ايا","با","ان","ايد","ترين","اينكه","ديگري","راه","هايي","بروز","همچنان","پاعين","كس","حدود","مختلف","مقابل","چيز","گيرد","ندارد","ضد","همچون","سازي","شان","مورد","باره","مرسي","خويش","برخوردار","چون","خارج","شش","هنوز","تحت","ضمن","هستيم","گفته","فكر","بسيار","پيش","براي","روزهاي","انكه","نخواهد","بالا","كل","وقتي","كي","چنين","كه","گيري","نيست","است","كجا","كند","نيز","يابد","بندي","حتي","توانند","عقب","خواست","كنند","بين","تمام","همه","ما","باشند","مثل","شد","اري","باشد","اره","طبق","بعد","اگر","صورت","غير","جاي","بيش","ريزي","اند","زيرا","چگونه","بار","لطفا","مي","درباره","من","ديده","همين","گذاري","برداري","علت","گذاشته","هم","فوق","نه","ها","شوند","اباد","همواره","هر","اول","خواهند","چهار","نام","امروز","مان","هاي","قبل","كنم","سعي","تازه","را","هستند","زير","جلوي","عنوان","بود"]french
["ô","être","vu","vous","votre","un","tu","toute","tout","tous","toi","tiens","tes","suivant","soit","soi","sinon","siennes","si","se","sauf","s","quoi","vers","qui","quels","ton","quelle","quoique","quand","près","pourquoi","plus","à","pendant","partant","outre","on","nous","notre","nos","tienne","ses","non","qu","ni","ne","mêmes","même","moyennant","mon","moins","va","sur","moi","miens","proche","miennes","mienne","tien","mien","n","malgré","quelles","plein","mais","là","revoilà","lui","leurs","","toutes","le","où","la","l","jusque","jusqu","ils","hélas","ou","hormis","laquelle","il","eu","nôtre","etc","est","environ","une","entre","en","son","elles","elle","dès","durant","duquel","été","du","voici","par","dont","donc","voilà","hors","doit","plusieurs","diverses","diverse","divers","devra","devers","tiennes","dessus","etre","dessous","desquels","desquelles","ès","et","désormais","des","te","pas","derrière","depuis","delà","hui","dehors","sans","dedans","debout","vôtre","de","dans","nôtres","mes","d","y","vos","je","concernant","comme","comment","combien","lorsque","ci","ta","nບnmoins","lequel","chez","contre","ceux","cette","j","cet","seront","que","ces","leur","certains","certaines","puisque","certaine","certain","passé","cependant","celui","lesquelles","celles","quel","celle","devant","cela","revoici","eux","ceci","sienne","merci","ce","c","siens","les","avoir","sous","avec","pour","parmi","avant","car","avait","sont","me","auxquels","sien","sa","excepté","auxquelles","aux","ma","autres","autre","aussi","auquel","aujourd","au","attendu","selon","après","ont","ainsi","ai","afin","vôtres","lesquels","a"]dutch
["andere","uw","niets","wil","na","tegen","ons","wordt","werd","hier","eens","onder","alles","zelf","hun","dus","kan","ben","meer","iets","me","veel","omdat","zal","nog","altijd","ja","want","u","zonder","deze","hebben","wie","zij","heeft","hoe","nu","heb","naar","worden","haar","daar","der","je","doch","moet","tot","uit","bij","geweest","kon","ge","zich","wezen","ze","al","zo","dit","waren","men","mijn","kunnen","wat","zou","dan","hem","om","maar","ook","er","had","voor","of","als","reeds","door","met","over","aan","mij","was","is","geen","zijn","niet","iemand","het","hij","een","toen","in","toch","die","dat","te","doen","ik","van","op","en","de"]russian
["а","без","более","бы","был","была","были","было","быть","в","вам","вас","весь","во","вот","все","всего","всех","вы","где","да","даже","для","до","его","ее","ей","ею","если","есть","еще","же","за","здесь","и","из","или","им","их","к","как","ко","когда","кто","ли","либо","мне","может","мы","на","надо","наш","не","него","нее","нет","ни","них","но","ну","о","об","однако","он","она","они","оно","от","очень","по","под","при","с","со","так","также","такой","там","те","тем","то","того","тоже","той","только","том","ты","у","уже","хотя","чего","чей","чем","что","чтобы","чье","чья","эта","эти","это","я"]