Este tema describe cómo consultar el uso de memoria y proporciona las causas y soluciones para los problemas de memoria más comunes.
Contexto
El uso de memoria y la tasa de aciertos del buffer pool son métricas clave para una instancia de ApsaraDB RDS for MySQL. Un uso elevado de memoria puede provocar su agotamiento. Una tasa baja de aciertos en el buffer pool indica que muchas páginas de datos no se encuentran en este y deben leerse desde el disco. Esto incrementa el throughput de E/S y la latencia.
Consultar el uso de memoria
Puede consultar los hilos activos en la RDS Management Console de varias formas:
-
Monitoring and Alerts
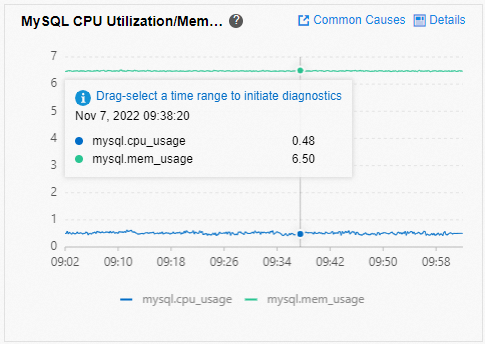
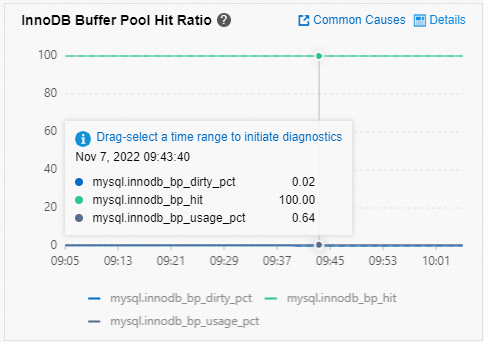
En la consola, vaya a la página Monitoring and Alerts. En la pestaña Standard Monitoring, puede consultar el MySQL CPU/Memory Usage y la InnoDB Buffer Pool Hit Rate de la instancia.
-
Database Autonomy Service (DAS)
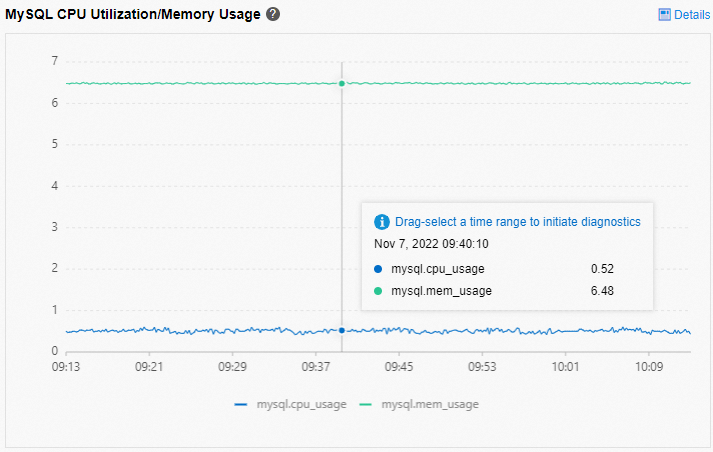
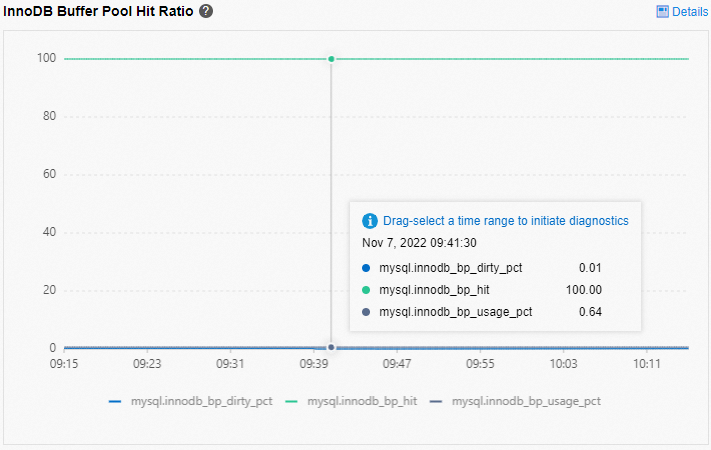
En la consola, vaya a la página . Haga clic en la pestaña Performance Trend para consultar el MySQL CPU/Memory Usage y la InnoDB Buffer Pool Hit Rate.
También puede usar performance_schema para configurar los instrumentos de memoria. Esto le permite consultar estadísticas de uso de memoria en las tablas de resumen de memoria. Para obtener más información, consulte la documentación oficial de MySQL.
Para habilitar el monitoreo de memoria al inicio de la instancia, modifique el parámetro performance_schema en la consola. Establézcalo en ON para RDS for MySQL 5.6. Establézcalo en 1 para RDS for MySQL 5.7 y 8.0. Para obtener más información, consulte View instance parameters. Reinicie la instancia para que los cambios surtan efecto.
-
Para habilitar el monitoreo de memoria durante la ejecución de la instancia, ejecute el siguiente comando:
update performance_schema.setup_instruments set enabled = 'yes' where name like 'memory%';
A continuación, se presentan tablas que resumen el consumo de memoria desde diversas dimensiones:
memory_summary_by_account_by_event_name: Resume eventos por cuenta (una combinación de usuario y host) y nombre de evento.
memory_summary_by_host_by_event_name: Resume eventos por host y nombre de evento.
memory_summary_by_thread_by_event_name: Resume eventos por hilo y nombre de evento.
memory_summary_by_user_by_event_name: Resume eventos por usuario y nombre de evento.
memory_summary_global_by_event_name: Resume eventos por nombre de evento.
Causas comunes de alto uso de memoria en RDS for MySQL
El InnoDB Buffer Pool suele consumir la mayor cantidad de memoria. El uso máximo de memoria del buffer pool está limitado por sus parámetros de configuración. Sin embargo, también se asigna y ajusta dinámicamente una cantidad significativa de memoria durante la ejecución de solicitudes. Esto incluye memoria para tablas temporales en memoria, caché de prelectura, caché de tablas, índices hash y objetos de bloqueo de filas. Para obtener más información sobre el uso de memoria y los límites de parámetros, consulte la documentación oficial de MySQL.
Consultas de múltiples instrucciones
MySQL admite el envío de varias instrucciones SQL juntas, separadas por punto y coma (;). MySQL procesa cada instrucción SQL secuencialmente. No obstante, parte de la memoria asignada se libera solo después de que todas las instrucciones SQL han terminado de ejecutarse.
Si envía muchas consultas de múltiples instrucciones a la vez, por ejemplo, varios cientos de megabytes, la memoria acumulada consumida por diversos objetos durante la ejecución puede volverse muy grande. Esto puede provocar fácilmente el agotamiento de la memoria del proceso de MySQL.
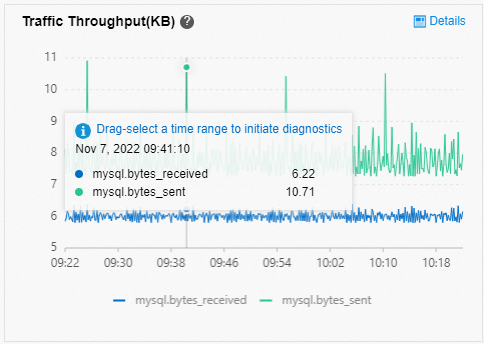
Por lo general, un lote grande de consultas de múltiples instrucciones causa un pico repentino en el tráfico de red. Puede comprobar este patrón mediante el monitoreo de tráfico de red y SQL Explorer. Evite usar consultas de múltiples instrucciones en la lógica de su aplicación.
Problemas del buffer pool
Todas las páginas de datos de las tablas se almacenan en el buffer pool. Cuando se ejecuta una consulta, si las páginas de datos requeridas se encuentran en el buffer pool, no se produce E/S física. Esto hace que la ejecución de SQL sea eficiente. El buffer pool utiliza un algoritmo de uso menos reciente (LRU) para gestionar las páginas de datos. Todas las páginas sucias se colocan en la lista de vaciado.
De forma predeterminada, el tamaño del InnoDB Buffer Pool para RDS for MySQL se establece en el 75 % de la memoria de la instancia. Esta suele ser la mayor parte de la memoria que consume la instancia.
Problemas comunes relacionados con el buffer pool:
Un precalentamiento insuficiente de las páginas de datos puede causar alta latencia en las consultas. Este problema suele ocurrir después de reiniciar la instancia, al leer datos fríos o cuando la tasa de aciertos del buffer pool es baja. Para resolverlo, puede actualizar el tipo de instancia o precalentar los datos antes de promociones de ventas.
Acumulación excesiva de páginas sucias. Cuando la distancia entre el número de secuencia de registro (LSN) más antiguo de una página sucia no vaciada y el LSN actual supera el 76 %, se activan hilos de usuario para sincronizar y vaciar las páginas sucias. Esto degrada severamente el rendimiento de la instancia. Para optimizarlo, equilibre la carga de escritura, evite un throughput de escritura excesivamente alto, ajuste los parámetros de vaciado de páginas sucias o actualice el tipo de instancia.
El parámetro innodb_buffer_pool_instances está configurado demasiado bajo para una instancia con mucha memoria. Bajo cargas altas de consultas por segundo (QPS), la contención de bloqueos en el buffer pool puede volverse intensa. Para instancias con mucha memoria, establezca el parámetro innodb_buffer_pool_instances en 8, 16 o superior.
Tablas temporales
El tamaño de las tablas temporales en memoria está limitado por los parámetros tmp_table_size y max_heap_table_size. Si una tabla supera estos límites, se convierte en una tabla temporal en disco. Si muchas conexiones crean tablas temporales grandes al mismo tiempo, puede producirse un pico repentino de memoria. MySQL 8.0 introdujo un nuevo motor temptable. El tamaño total de todas las tablas temporales en memoria asignadas por todos los hilos no puede superar el valor del parámetro temptable_max_ram. El valor predeterminado para temptable_max_ram es 1 GB. Si se supera este límite, las tablas se convierten en tablas temporales en disco.
Otras razones
Si una instancia tiene muchas tablas o un QPS alto, la caché de tablas también puede consumir una cantidad significativa de memoria. Evite crear demasiadas tablas en una instancia o establecer el parámetro table_open_cache demasiado alto.
La memoria utilizada por el índice hash adaptativo es 1/64 del tamaño del buffer pool de forma predeterminada. Si consulta o escribe campos de objeto binario grande (BLOB) muy grandes, se asigna memoria dinámicamente para estos objetos grandes, lo que aumenta el uso general de memoria.
Muchos otros problemas pueden causar un aumento en el uso de memoria. Si el uso de memoria aumenta de manera anormal o la instancia se queda sin memoria, consulte la documentación oficial de MySQL para identificar la causa.