RDS for MySQL optimiza la replicación paralela para eliminar el retraso de replicación durante el procesamiento de datos por lotes. Esta función resulta especialmente útil cuando se ejecutan operaciones masivas de eliminación, organización o importación en horarios de baja demanda.
Aplicabilidad
Su instancia de base de datos debe cumplir con uno de los siguientes requisitos de versión:
RDS for MySQL 8.4
RDS for MySQL 8.0 con una versión menor del motor 20251130 o posterior
Habilitación
Para habilitar esta función, establezca a continuación el parámetro global en la instancia principal o en una instancia de solo lectura.
Nombre del parámetro:
loose_optimize_replica_parallelismValor:
ONVigencia: La configuración surte efecto de inmediato. No es necesario reiniciar la instancia.
Contexto
Muchas aplicaciones ejecutan operaciones de datos, como eliminaciones, reorganizaciones e importaciones, durante los horarios de baja demanda mediante lotes pequeños y de alta concurrencia. Este enfoque es rápido y permite ajustar el tamaño del lote y la concurrencia para controlar el impacto en la base de datos.
Durante el procesamiento de datos por lotes coexisten dos tipos principales de transacciones en la instancia: transacciones medianas provenientes de trabajos por lotes, que suelen procesar miles de filas por transacción, y transacciones pequeñas generadas por las operaciones comerciales habituales. Incluso en horarios de baja demanda persiste cierto tráfico comercial normal. Estos dos tipos de transacciones se intercalan en el archivo binlog. Si varias transacciones pequeñas que modifican la misma fila quedan entre dos transacciones medianas, estas últimas no pueden ejecutarse de forma concurrente.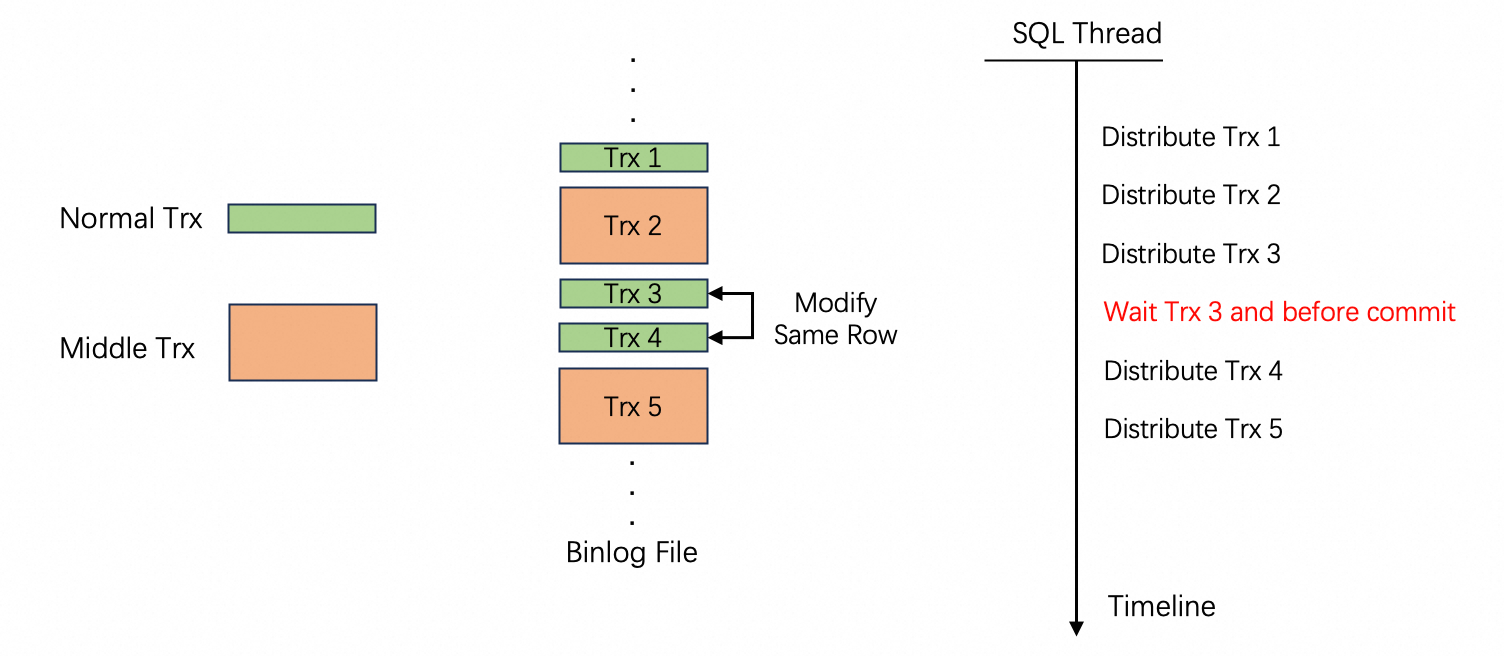
Como se muestra en la figura anterior, Trx2 y Trx5 son transacciones medianas de un proceso por lotes. Trx3 y Trx4 son transacciones pequeñas de operaciones comerciales habituales que modifican la misma fila. Cuando el hilo SQL distribuye estas transacciones, Trx2 y Trx3 se asignan con normalidad. Sin embargo, Trx4 debe esperar a que Trx3 y todas las transacciones anteriores confirmen sus cambios antes de que el hilo SQL pueda distribuirla. Esto retrasa la distribución de Trx5 hasta que Trx2 confirme, lo que impide que Trx2 y Trx5 se apliquen en paralelo.
Como consecuencia, la concurrencia de la réplica es muy baja durante el procesamiento de datos por lotes. En ocasiones, solo un hilo de trabajo permanece activo, lo que reduce la replicación al rendimiento de un solo hilo y provoca un retraso significativo.
Resultados
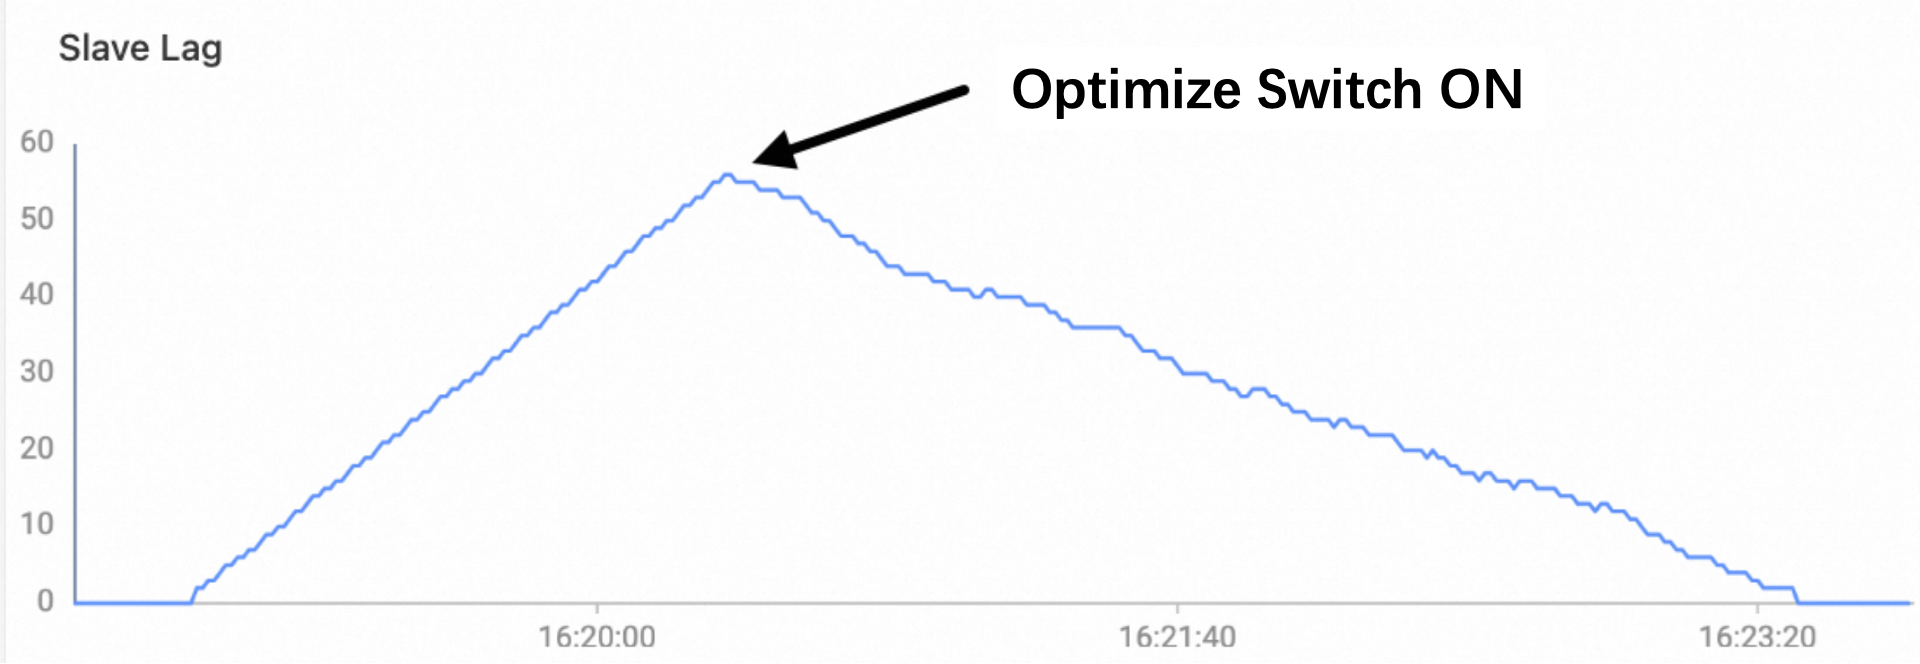
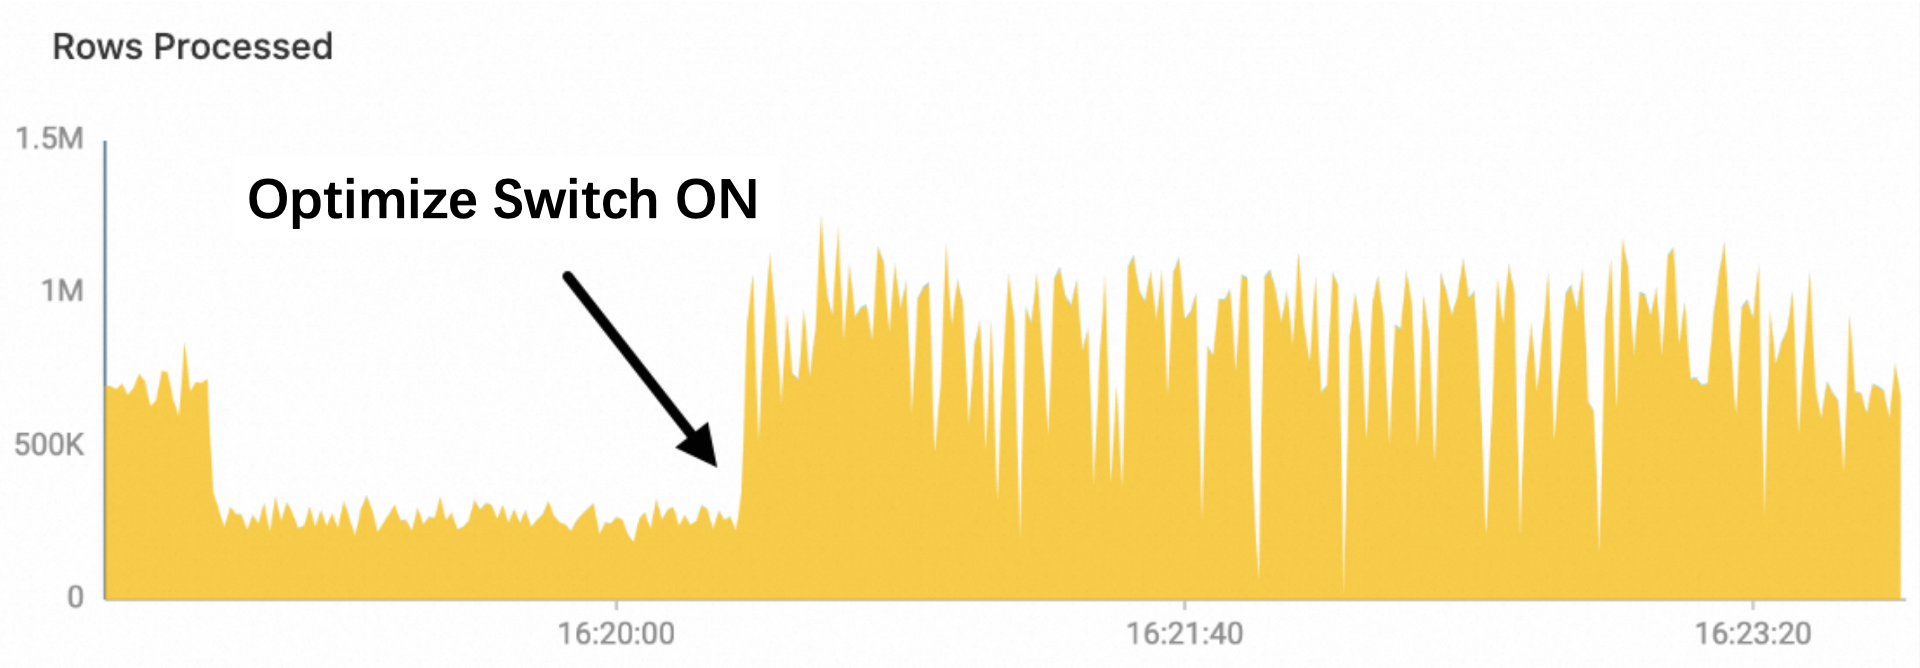
La siguiente prueba utiliza la eliminación masiva de datos para demostrar la mejora. Un script sysbench de solo escritura y un solo hilo simuló transacciones pequeñas en segundo plano, mientras que ocho hilos concurrentes eliminaron datos en lotes de 5,000 filas. Las figuras anteriores muestran el retraso de replicación en una instancia de solo lectura. Antes de habilitar la función, el rendimiento de la réplica era bajo y el retraso de replicación aumentaba de manera constante. Después de habilitarla, el rendimiento mejoró significativamente y el retraso disminuyó hasta que la réplica se sincronizó por completo.
Funcionamiento
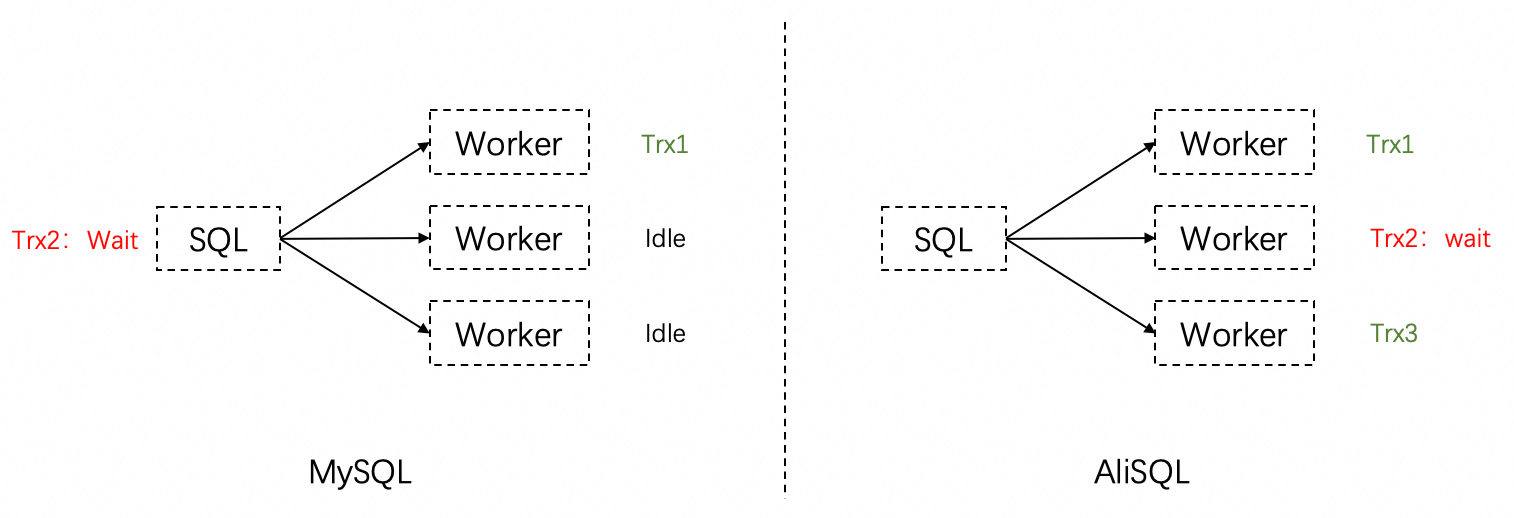
Con esta optimización, las transacciones pequeñas en conflicto que aparecen entre transacciones medianas esperan en sus propios hilos de trabajo a que se confirmen las dependencias, en lugar de hacerlo en el hilo SQL. Esto evita que el hilo SQL bloquee la distribución de otras transacciones, por lo que las transacciones medianas sin conflictos pueden ejecutarse en paralelo.