Durante las horas pico, muchas cargas de trabajo actualizan bases de datos con alta concurrencia. Si el throughput de transacciones (TPS) en la instancia principal supera el throughput de los hilos de E/S y SQL en una instancia réplica, puede producirse latencia de replicación. Para resolver este problema, ApsaraDB RDS for MySQL optimiza la lógica de espera de bloqueos entre los hilos de E/S, SQL y worker, lo que reduce la cantidad de esperas de bloqueo. Esta optimización elimina la latencia de replicación en cargas de trabajo con transacciones pequeñas y alta concurrencia.
Descripción general
Latencia de replicación
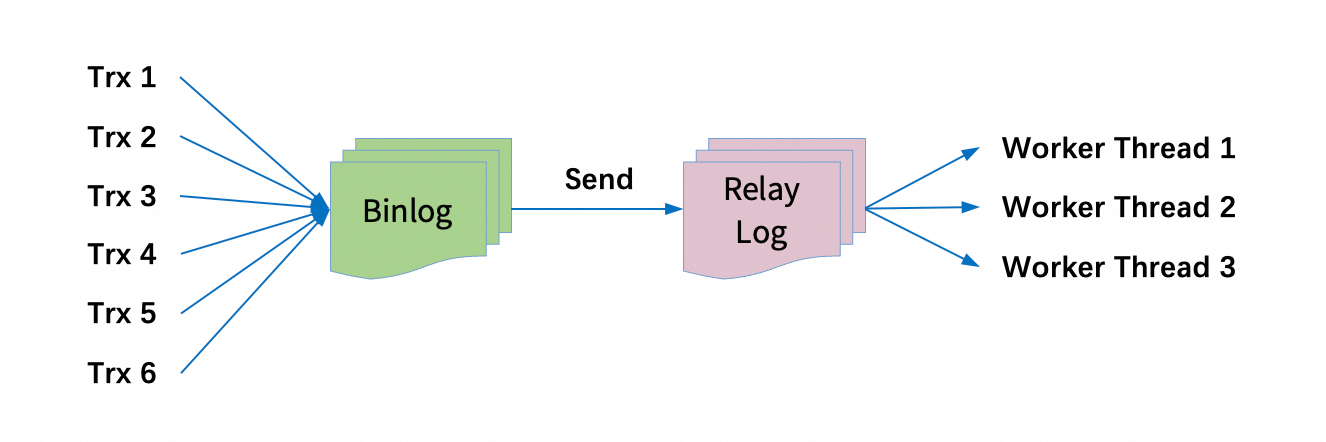
Latencia de replicación: Durante las horas pico, muchas cargas de trabajo actualizan bases de datos con alta concurrencia. Si la instancia principal aplica transacciones con mayor concurrencia que la instancia réplica, el throughput de transacciones de la réplica puede quedar rezagado y provocar latencia de replicación. Incluso si aumenta el número de hilos worker o habilita la Writeset feature, la concurrencia de aplicación de la réplica podría seguir siendo insuficiente porque su hilo de E/S o SQL alcanza un cuello de botella de throughput.
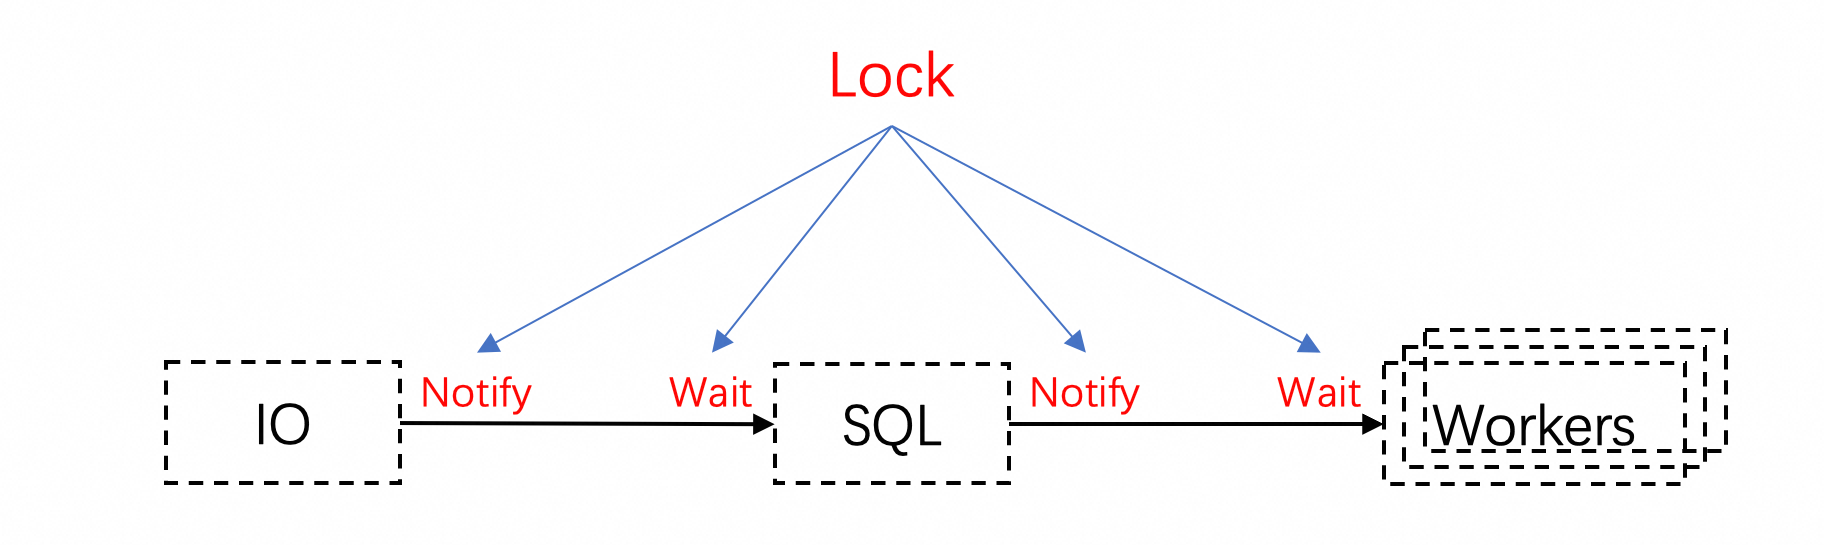
Cuellos de botella de throughput en los hilos de E/S y SQL: La replicación multihilo de MySQL utiliza tres tipos de hilos: el hilo de E/S, el hilo SQL y varios hilos worker. El hilo de E/S recupera eventos binlog de la instancia principal. El hilo SQL distribuye estos eventos binlog a los hilos worker. Posteriormente, los hilos worker aplican las transacciones en paralelo.
La coordinación entre los hilos de E/S y SQL, así como entre los hilos SQL y worker, depende de operaciones de espera y notificación protegidas por bloqueos. Cada evento binlog requiere uno de estos ciclos de bloqueo y notificación. Una sola transacción consta de varios eventos binlog. Por ejemplo, en el script de prueba común sysbench write_only, una transacción implica actualizar dos filas, insertar una fila y eliminar una fila, lo que genera 11 eventos binlog. Bajo alta concurrencia, estos bloqueos se convierten frecuentemente en un cuello de botella de rendimiento que limita el throughput de los hilos de E/S y SQL.
Cuando el hilo de E/S o SQL alcanza un cuello de botella de throughput, los hilos worker no reciben las transacciones para aplicarlas a tiempo. Si la concurrencia de aplicación de los hilos worker en la instancia réplica es menor que la concurrencia de la carga de trabajo en la instancia principal, se produce latencia de replicación.
Optimización por lotes de transacciones pequeñas
Para optimizar la latencia de replicación en transacciones pequeñas con alta concurrencia, AliSQL introduce una optimización de agrupamiento de transacciones pequeñas. Esta optimización agrupa los múltiples eventos binlog de una transacción pequeña en un solo ciclo de bloqueo y notificación para los hilos de E/S y SQL. Este enfoque reduce significativamente la cantidad de operaciones de bloqueo y, en consecuencia, aumenta el throughput tanto de los hilos de E/S como de los hilos SQL.
Requisitos previos
Para usar esta optimización, su instancia debe cumplir con el siguiente requisito:
Versión del motor de base de datos: Su instancia debe ejecutar ApsaraDB RDS for MySQL 8.0 con una versión secundaria del motor 20260228 o posterior. Si su instancia no cumple con este requisito, puede Upgrade minor engine version o Upgrade DB engine version.
Procedimiento
Habilite esta función mediante la configuración de un parámetro global en sus instancias principales o de solo lectura:
Vaya a la página Instances. En la barra de navegación superior, seleccione la región donde reside la instancia RDS. A continuación, localice la instancia RDS y haga clic en el ID de la instancia.
En el panel de navegación izquierdo, haga clic en Parameter settings.
-
En la pestaña Modifiable parameters, busque el parámetro
loose_replica_package_transaction_limit_sizey configure su valor.Descripción del parámetro: Un valor de 0 deshabilita esta función. Cuando el valor es mayor que 0, las transacciones con un tamaño de binlog inferior a este valor son elegibles para esta optimización.
Valores válidos: De 0 a 1 MB.
Valor recomendado: 1 MB.
Haga clic en OK y luego en Submit parameters. En el cuadro de diálogo, seleccione un Effective period. El cambio de parámetro surte efecto inmediatamente y no requiere reiniciar la instancia.
Resultados de la optimización
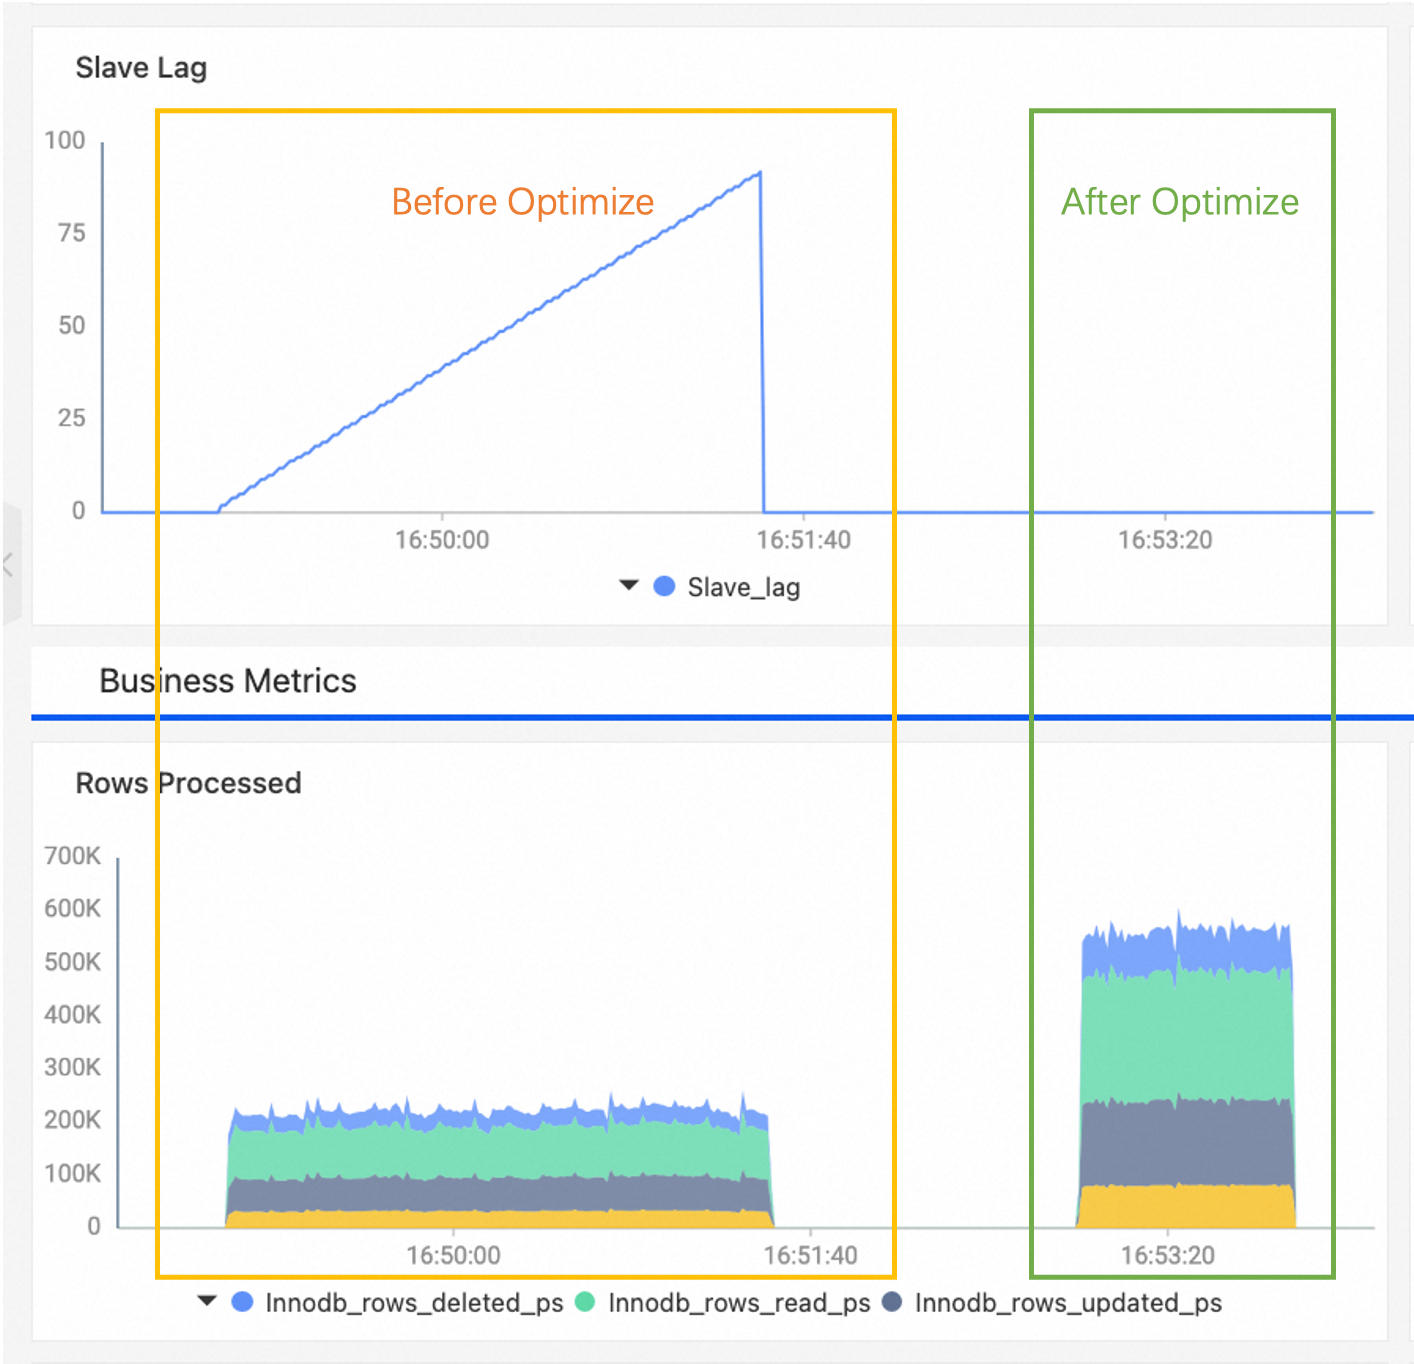
Ejecutamos el script sysbench write_only en la instancia principal con 128 hilos concurrentes (80,000 transacciones por segundo o TPS) para simular una carga de escritura pico de 60 segundos. La prueba arrojó los siguientes resultados:
Antes de la optimización: La latencia de replicación en la instancia réplica aumentaba continuamente y el throughput era muy bajo.
Después de la optimización: La instancia réplica no experimentó latencia de replicación y su throughput casi se duplicó.