Este tema describe la función de índice columnar agrupado (CCI).
Las soluciones de procesamiento de transacciones en línea (OLTP) y de procesamiento analítico en línea (OLAP) se desarrollan con base en la separación de lecturas y escrituras o en el modelo de extracción, transformación y carga (ETL). Estas soluciones extraen datos de las bases de datos en línea y los cargan en un almacén de datos para analizarlos mediante T+1. Sin embargo, presentan varias desventajas, como un alto costo de almacenamiento, capacidades limitadas en tiempo real y costos elevados de mantenimiento y conectividad.
Para hacer frente al crecimiento explosivo de los datos, PolarDB-X ofrece la función CCI basada en Object Storage Service (OSS). Esta función le permite sincronizar datos orientados a filas con datos orientados a columnas en tiempo real y admite las siguientes capacidades:
La función CCI admite OLTP integrado y análisis de datos en tiempo real para cumplir con los requisitos de escenarios donde intervienen OLTP y OLAP.
La función CCI de PolarDB-X admite el enrutamiento inteligente y el procesamiento masivamente paralelo (MPP). La capa de cómputo identifica con precisión el tráfico de procesamiento transaccional (TP) y el de procesamiento analítico (AP), y enruta cada uno a distintos medios de almacenamiento. De forma predeterminada, esta capa también garantiza que MPP esté habilitado en las trazas de AP para examinar los CCI. Esto mejora significativamente las capacidades de análisis de consultas.
La función CCI utiliza el modelo Delta+Main para implementar actualizaciones en tiempo real en cuestión de segundos. Además, se integra con el control de concurrencia multiversión (MVCC) para garantizar que se puedan leer datos de instantáneas consistentes en cualquier momento.
Usage notes
- The CCI feature is supported only by Enterprise Edition instances whose version is 5.4.19-16989811 or later.
-
Solo las bases de datos en modo AUTO admiten creating CCIs.
NotaPara obtener información sobre el control de versiones de instancias, consulte Kernel release notes.
Para conocer cómo consultar la versión de una instancia de PolarDB-X, consulte View and update the engine version of a PolarDB for Xscale instance.
Architecture
Almacenamiento híbrido de filas y columnas

Componentes clave
Compute nodes (CNs) are the entrance of the system. These nodes use the stateless design, and include models such as the SQL parser, optimizer, and executor. CNs are responsible for distributed data routing, computation, dynamic scheduling, distributed transaction coordination based on the Two-Phase Commit (2PC) protocol, and global secondary index maintenance. CNs provide enterprise-level features such as SQL throttling and the three-role mode.
Data nodes (DNs) are responsible for persistent row-oriented data. DNs ensure data durability and provide strong consistency guarantees based on the multi-majority Paxos protocol. DNs use MVCC to maintain the visibility of distributed transactions. DNs can also meet the requirements of operations that need to push down computing tasks in distributed architectures, such as Project, Filter, Join, and Aggregation.
Global Meta Service (GMS) is responsible for maintaining globally consistent system metadata such as table metadata, schema metadata, and statistics metadata. GMS manages security-related information such as user accounts and permissions. GMS provides the Timestamp Oracle (TSO) service.
Change Data Capture (CDC) provides incremental subscription capabilities fully compatibility with the formats and protocols of MySQL binary logs. CDC also provides primary/secondary replication capabilities compatible with MySQL replication protocols.
- Columnar provides persistent CCIs, consumes the binary logs of distributed transactions in real time, and builds CCIs based on OSS to meet the requirements of real-time updates. When combined with CNs, columnar can provide snapshot-consistent query capabilities for CCIs.
Almacenamiento orientado a columnas

Concepto de arquitectura
Con la creciente popularidad de las tecnologías nativas de la nube, los almacenes de datos de nueva generación como Snowflake y la arquitectura HTAP impulsan la innovación de manera continua. Es evidente que, en un futuro cercano, el almacenamiento híbrido de filas y columnas con capacidades HTAP será un requisito estándar para las bases de datos. Por lo tanto, es importante enfocarse en aspectos orientados al futuro, como la rentabilidad, la facilidad de uso y el alto rendimiento en los diseños actuales de almacenamiento orientado a columnas.
PolarDB-X ofrece la función CCI. De forma predeterminada, una tabla orientada a filas en PolarDB-X cuenta con índices de clave primaria e índices secundarios. Un CCI es un índice secundario construido sobre una estructura orientada a columnas y es válido para todas las columnas de una tabla orientada a filas. Una tabla puede contener datos orientados a filas y datos orientados a columnas.
Características de la arquitectura
-
Arquitectura nativa de la nube (almacenamiento y cómputo desacoplados, además de rentabilidad)
La función CCI de PolarDB-X utiliza OSS como almacenamiento principal de datos, lo cual genera entre una sexta y una décima parte del costo de un almacenamiento basado en discos locales. También implementa una alta relación de compresión para los datos orientados a columnas, de tres a cinco veces mayor que la de otros tipos de datos. Esto otorga a la función CCI una ventaja competitiva en cuanto a menores costos. En escenarios HTAP donde interviene el almacenamiento híbrido de filas y columnas, los costos adicionales del almacenamiento orientado a columnas se pueden mantener entre el 5 % y el 10 % del costo del almacenamiento orientado a filas.
La función CCI de PolarDB-X aprovecha el modelo de dos niveles Delta+Main, similar a la estructura LSM, junto con tecnologías de eliminación por etiquetas en su capa de almacenamiento. Esto garantiza altas capacidades de actualización concurrente cuando se usa OSS. También emplea múltiples capas de caché de datos local y un mecanismo de estadísticas multinivel en las trazas donde lee datos de OSS, con el fin de minimizar el acceso remoto innecesario a los datos almacenados en este servicio.
-
Sistema de base de datos distribuida (escalabilidad lineal)
En las bases de datos distribuidas tradicionales, los CCI se construyen comúnmente mediante mecanismos de múltiples réplicas basados en los protocolos Paxos o Raft. Sin embargo, OLTP y OLAP tienen distintos requisitos de consulta y diferentes grados de dependencia de recursos. Las políticas de particionamiento de coherencia fuerte y los mecanismos de escalabilidad entre distintas réplicas pueden limitar la escalabilidad lineal de TP y AP, lo cual degrada el rendimiento de la base de datos.
La función CCI de PolarDB-X implementa una transformación heterogénea de datos orientados a filas a datos orientados a columnas (M:N) con base en la sincronización en tiempo real de los registros binarios de transacciones distribuidas. Esta función define las claves de partición distribuidas y las claves de ordenamiento para los CCI. PolarDB-X aprovecha técnicas de procesamiento paralelo distribuido para ofrecer escalabilidad lineal en las consultas basadas en CCI. Los medios de almacenamiento orientados a filas y a columnas están aislados entre sí, por lo que los recursos de almacenamiento y cómputo se escalan con facilidad. En un entorno distribuido, las consultas basadas en CCI se benefician de una escalabilidad lineal extrema.
-
Separación de lecturas y escrituras (arquitectura serverless con precios pay-as-you-go para lecturas)
La función CCI de PolarDB-X adopta una arquitectura de separación de lecturas y escrituras basada en componentes, formada por nodos de almacenamiento de columnas y nodos de cómputo. Los nodos de almacenamiento de columnas no tienen estado y no gestionan directamente las solicitudes de escritura de clientes externos; en su lugar, utilizan la tecnología Group Commit para actualizar los datos CCI por lotes. Los nodos de cómputo tampoco tienen estado: recuperan metadatos columnares de los nodos GMS y acceden directamente a los datos CCI almacenados en OSS.
Si desea crear una instancia de PolarDB-X, el sistema proporciona automáticamente nodos de almacenamiento de columnas. Estos nodos se ejecutan de forma continua y sincronizan los CCI. Puede crear fácilmente un CCI al ejecutar una instrucción DDL. Una vez construido, los datos del CCI se generan automáticamente y se actualizan en tiempo real. Para acceder a los índices de almacenamiento de filas y a los CCI, utilice una instancia principal o adquiera una instancia de solo lectura adicional. El modo serverless también es adecuado para los CN sin estado, ya que solo se le cobra por el uso de estos nodos.
-
Combinación de almacenamiento orientado a filas y a columnas (facilidad de uso y motor SQL vectorizado integrado)
PolarDB-X reutiliza el motor SQL de los CN para ofrecer todas sus capacidades. Se diseñó un optimizador de costos específico para escenarios híbridos de filas y columnas. Este optimizador identifica rutas de manera inteligente según los costos de ejecución y dirige las consultas OLTP a las trazas de almacenamiento de filas, mientras envía las consultas OLAP a las trazas basadas en CCI. Permite acceder a distintos datos orientados a filas y a columnas a nivel de operador SQL, lo cual implementa por completo las capacidades híbridas HTAP. Además, facilita el acceso unificado a un conjunto de motores SQL.
PolarDB-X es totalmente compatible con la vectorización. El operador TableScan utiliza la estructura de datos de fragmentos columnares para leer datos orientados a columnas. Los cálculos posteriores de los operadores también heredan por completo la estructura columnar en memoria de dichos fragmentos. Esto mejora el rendimiento de las consultas gracias a la vectorización de extremo a extremo. Asimismo, el operador TableScan para almacenamiento orientado a filas se convierte dinámicamente en fragmentos columnares, lo que permite ejecutar consultas híbridas de filas y columnas con una estructura de datos unificada.
-
Almacén integral (Zero-ETL)
Los almacenes de datos tradicionales usan ETL para sincronizar información y aprovechan arquitecturas de cómputo paralelo, como MPP y Bulk Synchronous Parallel (BSP), para procesar consultas OLAP complejas. No obstante, en consultas en línea de alta concurrencia (escenarios Serving), estos almacenes presentan un cuello de botella en la concurrencia de recursos. En tales casos, devuelven los datos a las bases de datos OLTP para atender las consultas en línea.
PolarDB-X se integra con AnalyticDB for MySQL para ofrecer un almacén integral. Este aprovecha datos CCI compartidos bajo el concepto Zero-ETL. También permite que varias partes ejecuten agregación de datos y consultas de correlación, y proporciona análisis tradicional de almacén y lago de datos mediante las capacidades de AnalyticDB for MySQL. La arquitectura híbrida de filas y columnas con capacidades HTAP de PolarDB-X sirve igualmente para consultas concurrentes sobre datos en línea, lo que elimina la necesidad del ETL tradicional.
How CCIs work
Construcción de CCI
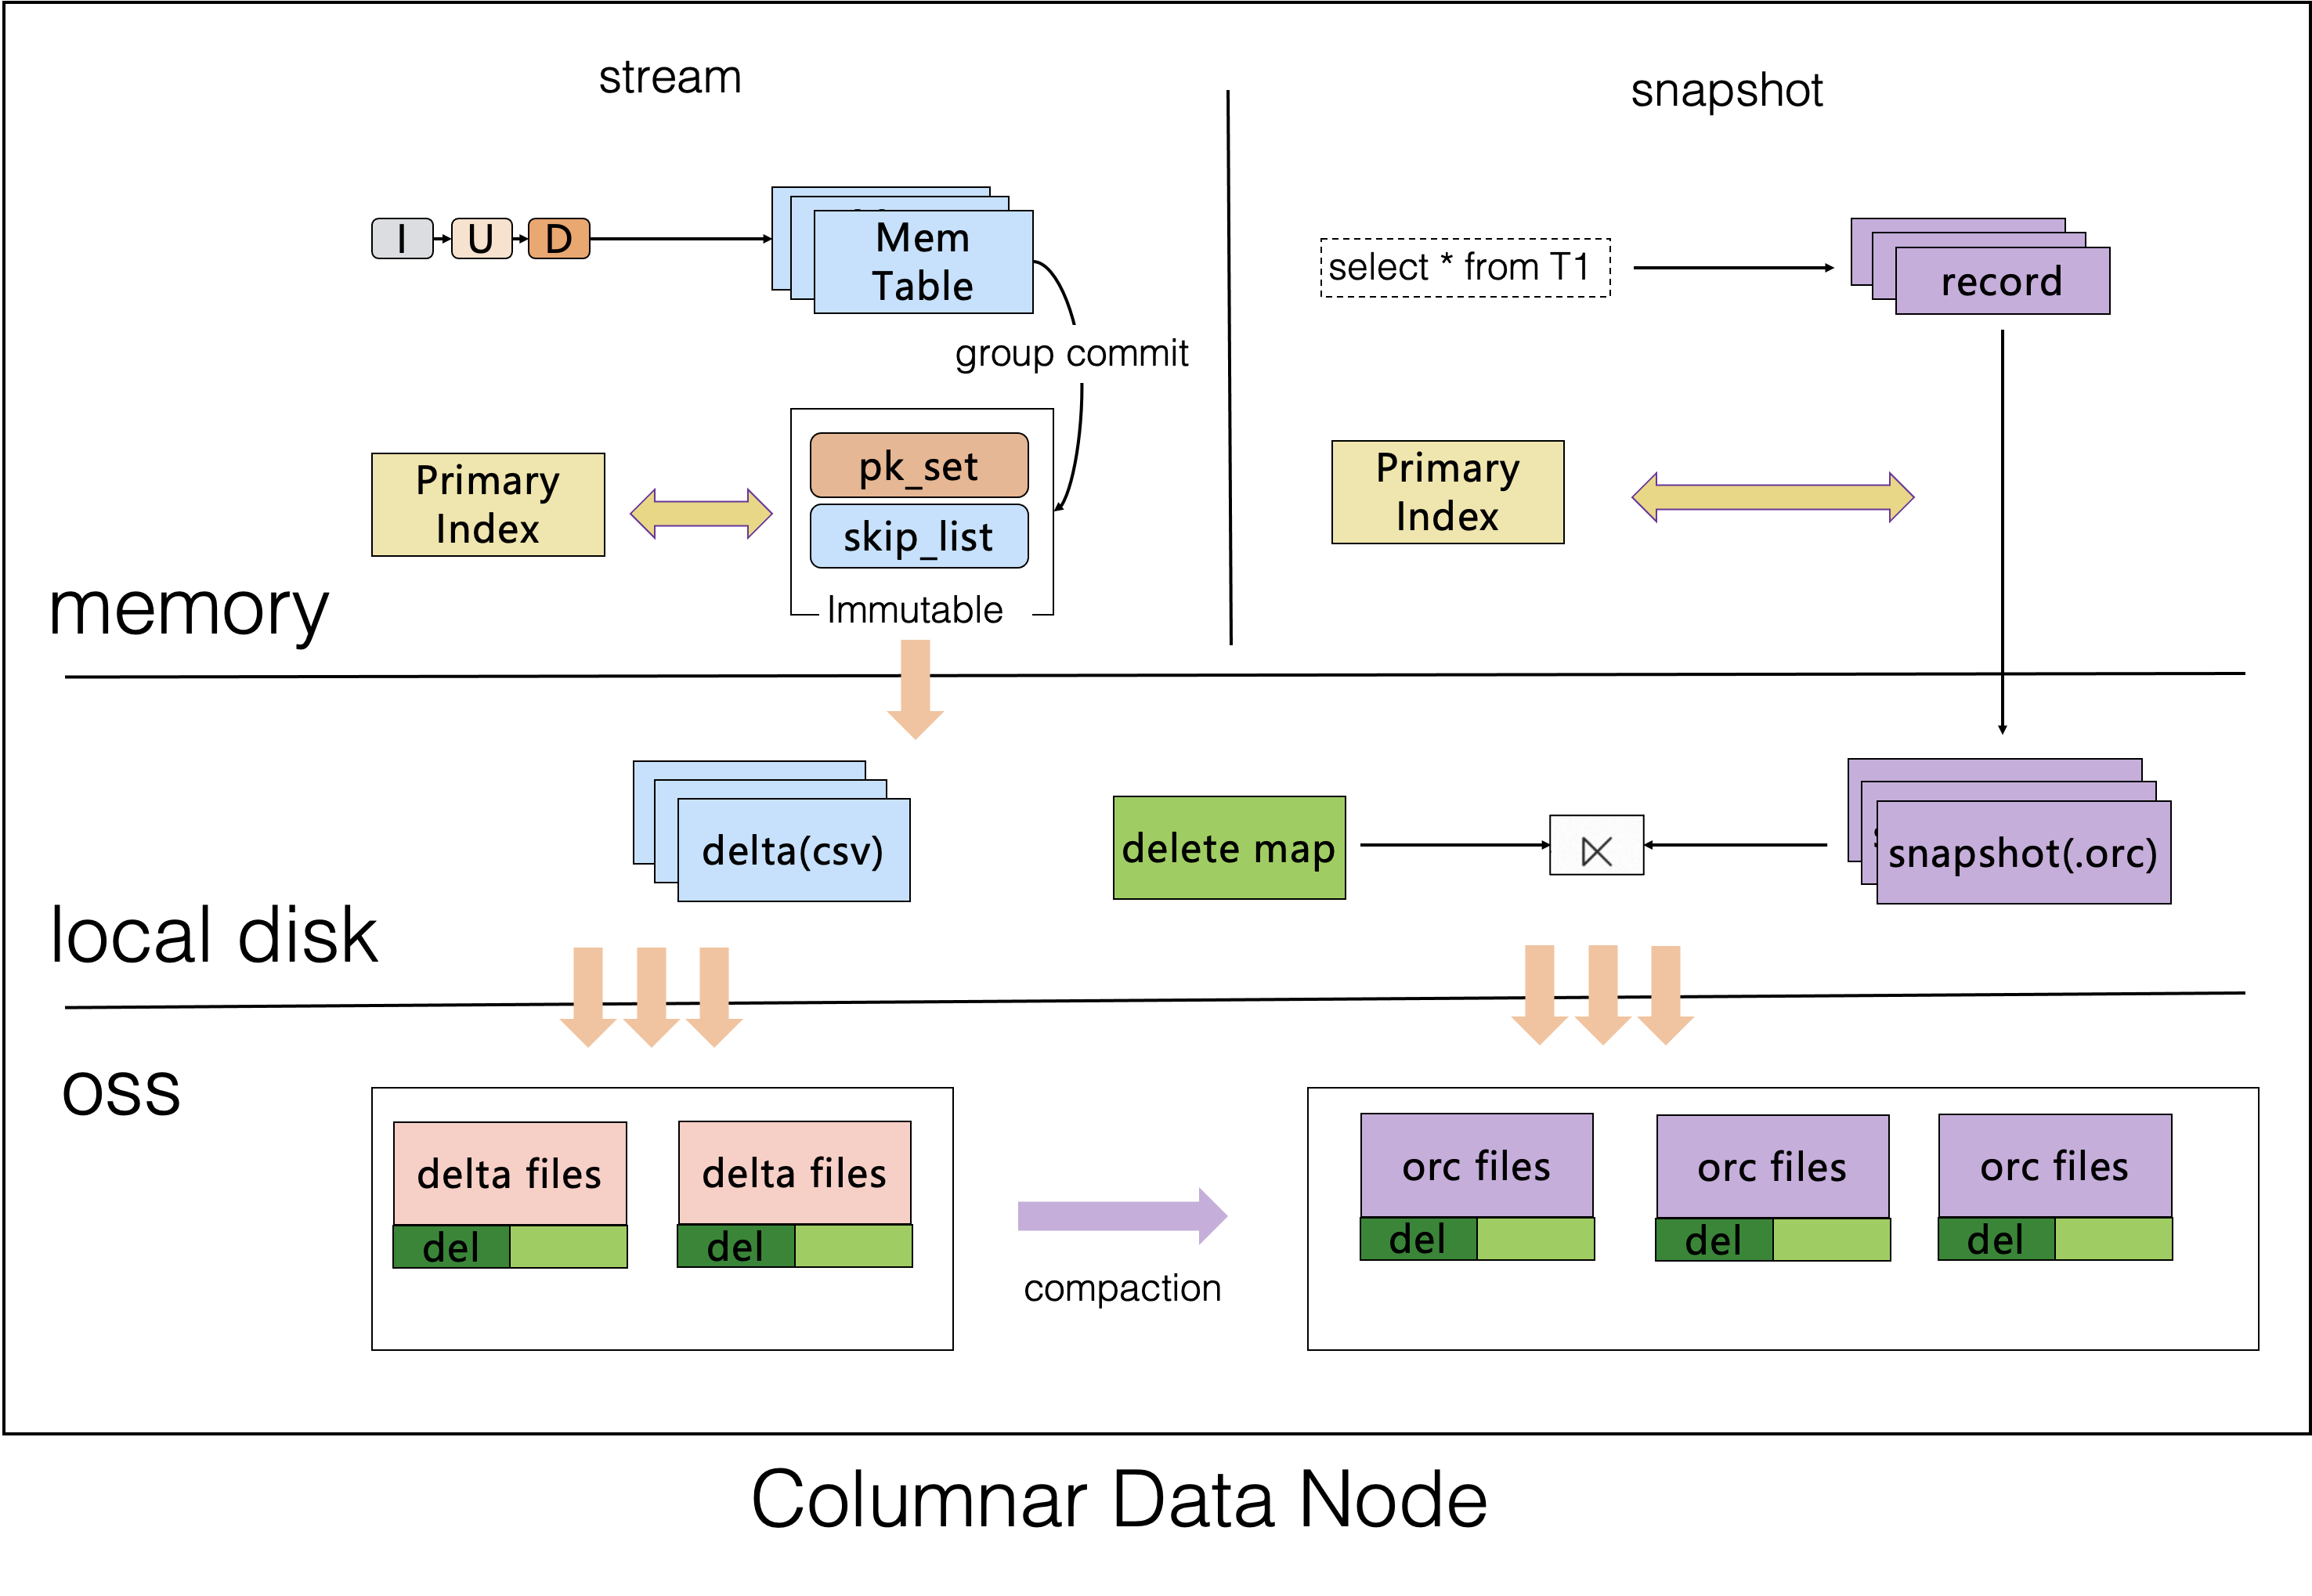
Los nodos de almacenamiento de columnas construyen los CCI. Los datos relacionados con los CCI construidos se almacenan en objetos de fragmento con formato CSV y ORC. El formato CSV guarda los datos incrementales en tiempo real. Cuando los datos incrementales son excesivos, se compactan oportunamente y se vuelcan al formato ORC. PolarDB-X optimizó ambos formatos, los cuales conservan las características de código abierto de los formatos nativos y garantizan que puedan expresar por completo los protocolos de datos de MySQL.
Desde la perspectiva de la sincronización de datos, la construcción de CCI involucra dos trazas paralelas: lectura de instantáneas completas y sincronización de datos incrementales. En escenarios donde primero se construyen los CCI y luego se importan los datos, solo se sincronizan los datos incrementales, y los nodos de almacenamiento de columnas consumen simultáneamente los registros binarios para construir los CCI. En escenarios donde se importa una parte de los datos, después se construyen los CCI y finalmente se importa el resto, se sincronizan los datos incrementales y los nodos consumen al mismo tiempo los datos incrementales y completos existentes para mejorar la eficiencia de creación.
Desde una perspectiva jerárquica, los nodos de almacenamiento de columnas usan el modelo de dos niveles Delta+Main, similar a la estructura LSM, junto con tecnologías de eliminación por etiquetas. Esto garantiza una sincronización de datos de baja latencia entre el almacenamiento orientado a filas y el orientado a columnas, así como actualizaciones en tiempo real en cuestión de segundos. Los datos se escriben en MemTable en tiempo real, se almacenan en un archivo CSV local y se anexan al archivo CSV correspondiente en OSS dentro de un ciclo de confirmación de grupo. Al archivo local se le denomina archivo delta. El archivo CSV en OSS no se almacena de forma permanente, sino que la compactación lo convierte periódicamente en un archivo ORC.
MPP

En PolarDB-X, los CN se encargan de gestionar el tráfico de consultas y análisis. La figura anterior muestra que toda la cadena de aceleración de consultas consta de tres niveles: el optimizador, el ejecutor y el motor de almacenamiento.
PolarDB-X ofrece un optimizador de costos diseñado para escenarios híbridos de filas y columnas. Este optimizador identifica rutas de manera inteligente según los costos de ejecución y dirige las consultas TP a las trazas de almacenamiento de filas, mientras envía las consultas AP a las trazas basadas en CCI.
PolarDB-X incluye un ejecutor integrado adecuado para escenarios híbridos de filas y columnas. Dispone de un conjunto de ejecutores para entornos HTAP. La capa de operadores también está vectorizada y admite MPP. En escenarios de consultas complejas, se pueden utilizar recursos de varios nodos para el cómputo paralelo y así satisfacer los requisitos de consultas complejas con alto rendimiento. Para eliminar la latencia de red causada por la arquitectura con recursos de cómputo y almacenamiento desacoplados, la capa de ejecutor introduce tecnología de caché local que carga datos frecuentes en discos locales en tiempo real. De este modo, se garantiza el cumplimiento de los requisitos de consultas de baja latencia.
A nivel del motor de almacenamiento, la construcción de CCI habilita la atomicidad de las transacciones confirmadas y garantiza que se puedan consultar datos consistentes a nivel de transacción.
Tipos de servicio

Con la introducción del almacenamiento columnar, PolarDB-X ofrece un tipo de servicio adicional aparte de las instancias principales y de solo lectura. Este nuevo tipo de servicio se conoce como instancia de almacenamiento de columnas de solo lectura.
Instancia principal: de forma predeterminada, la instancia principal solo permite consultar datos orientados a filas. Sin embargo, al combinarse con instancias de solo lectura, su endpoint habilita una separación de lecturas y escrituras transparente y fuertemente consistente. La instancia principal conserva la capacidad de consultar directamente datos orientados a columnas. Las funciones de enrutamiento inteligente y de consultas híbridas de filas y columnas estarán disponibles en el futuro.
Instancia de solo lectura: estas instancias permiten consultar datos de solo lectura orientados a filas y datos CCI. Cuentan con endpoints de solo lectura dedicados. Las aplicaciones pueden establecer conexiones independientes a dichos endpoints para ejecutar operaciones de lectura. Al conectarse a ellos, las aplicaciones gestionan de forma independiente las operaciones de lectura y escritura.
Instancia de almacenamiento de columnas de solo lectura: este tipo de instancia permite consultar únicamente datos CCI. Cuenta con endpoints de solo lectura dedicados. Las aplicaciones pueden establecer conexiones independientes a dichos endpoints para ejecutar operaciones de lectura. Estas instancias constan solo de CN, por lo que resultan más rentables.
Scenario
The CCI feature of PolarDB-X provides a one-stop HTAP solution and can be used in various business scenarios.- Scenarios that require the real-time analysis of online data within seconds, such as real-time report business.
- Data warehousing scenarios that depend on the large volume data storage capacity of PolarDB-X to aggregate multiple upstream data sources and use PolarDB-X as the dedicated data warehouse.
- ETL-faced computing scenarios that depend on the powerful and flexible computing capabilities of CCIs of PolarDB-X.
La función CCI de PolarDB-X cumple con los requisitos de escenarios que involucran TP y AP, y ofrece una solución HTAP transparente y rentable basada en OSS y tecnología de enrutamiento inteligente.
Pruebas de rendimiento
Para obtener información sobre la prueba TPC Benchmark-H (TPC-H) de PolarDB-X para PolarDB-X Clustered Columnar Indexes (CCIs), see TPC-H test for clustered columnar index (100 GB).