Elastic Parallel Query distribuye las consultas analíticas en varios nodos de solo lectura de forma paralela. Esto permite habilitar capacidades de procesamiento transaccional y analítico híbrido (HTAP) en PolarDB for PostgreSQL (Compatible with Oracle). Este tema explica cómo funciona esta función, cómo configurarla y cómo controlar el paralelismo a nivel de sistema, sesión y consulta.
Funcionamiento
Elastic Parallel Query utiliza dos tipos de nodos:
Nodo coordinador de consultas (QC): recibe la solicitud de consulta, divide el plan de ejecución en shards, enruta los shards a los nodos de ejecución paralela (PX) y agrega los resultados.
Nodos PX: cada uno ejecuta un shard asignado, lee bloques de datos del sistema de almacenamiento compartido Polar File System (PolarFS) y devuelve los resultados al nodo QC.
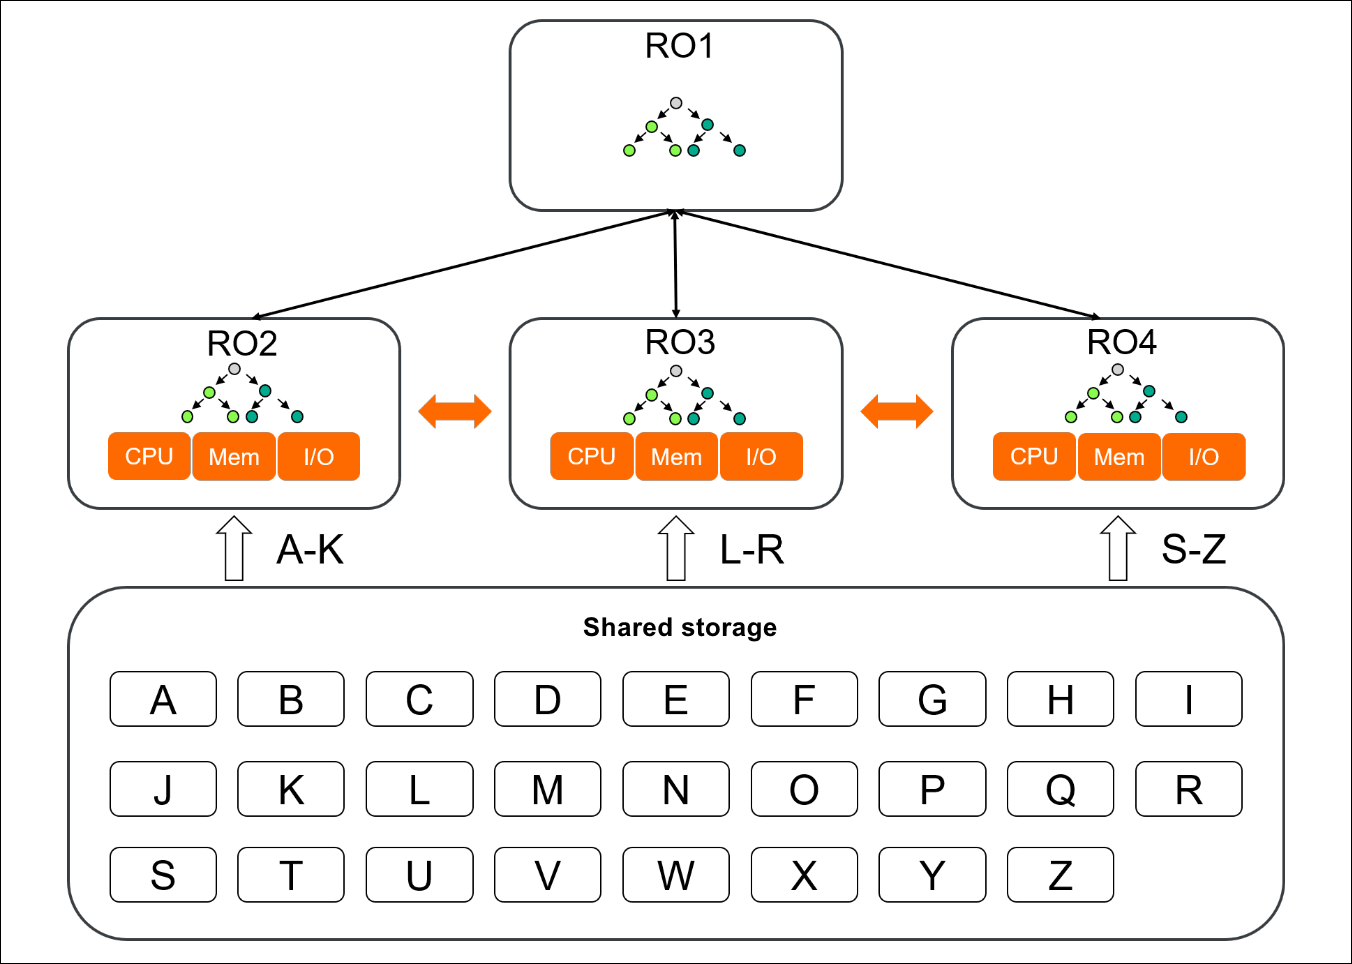
En la figura anterior, RO1 es el nodo QC, mientras que RO2, RO3 y RO4 son nodos PX. RO1 divide el plan de ejecución en tres shards y los enruta. Cada nodo PX lee desde PolarFS y envía los resultados de vuelta a RO1, que los combina para formar el resultado final.
Notas de uso
Elastic Parallel Query está deshabilitado de forma predeterminada y requiere varios nodos de solo lectura. Esta función es adecuada únicamente para consultas analíticas que se ejecutan con poca frecuencia.
Parámetros
Configure a continuación los parámetros para habilitar y ajustar Elastic Parallel Query.
|
Parámetro |
Descripción |
Valor predeterminado |
|
|
Habilita o deshabilita Elastic Parallel Query. Establezca este valor en |
|
|
|
Grado de paralelismo (DoP) por sesión y por nodo. Cada nodo utiliza esta cantidad de procesos de trabajo PX para una consulta. Para obtener el throughput máximo, establezca este valor con la cantidad de núcleos de CPU de sus nodos. |
|
|
|
Cantidad máxima de procesos de trabajo por nodo en todas las sesiones. Limita el paralelismo total sin importar la configuración de DoP. |
|
|
|
Lista separada por comas de los nodos de solo lectura que se usarán para la ejecución paralela. Deje este campo vacío para utilizar todos los nodos de solo lectura disponibles. |
(todos los nodos) |
|
|
Habilita la consistencia fuerte. Cuando se establece en |
|
|
|
Parámetro a nivel de tabla que controla si Elastic Parallel Query se aplica a una tabla específica. Establezca este valor en |
|
|
|
Parámetro de solo lectura que enumera los nombres de todos los nodos de solo lectura del clúster. Se actualiza automáticamente cuando se agregan nodos. Solo está disponible para clústeres que ejecutan la versión secundaria del kernel 1.1.20 (publicada en enero de 2022) o anteriores. |
N/D |
|
|
Controla si una transacción espera a que los registros WAL se escriban en el disco antes de devolver un mensaje de éxito. Valores válidos: |
|
Consideraciones clave:
polar_enable_px: debe establecerse enonantes de que cualquier otra configuración surta efecto. Configure este valor a nivel de sistema para habilitar la función de forma global, o a nivel de sesión para limitarla a cargas de trabajo específicas.`polar_px_dop_per_node`: si establece un valor demasiado alto en nodos que ejecutan sesiones simultáneas, se multiplica el uso de procesos de trabajo. Cada sesión puede consumir hasta
polar_px_dop_per_nodeprocesos de trabajo por nodo, por lo que el uso total equivale al DoP multiplicado por la cantidad de sesiones activas. Compruebe que el total no superepolar_px_max_workers_number.polar_px_enable_replay_wait: establézcalo enonúnicamente cuando su carga de trabajo incluya cambios DDL recientes (comoCREATE TABLE) que los nodos de solo lectura aún no hayan reproducido. Para cargas de trabajo analíticas con muchas lecturas y sin actividad DDL reciente, mantenga este valor enoffpara evitar la sobrecarga de reproducción.px_workers: utilice este parámetro para limitar Elastic Parallel Query a tablas específicas de alto valor, en lugar de habilitarlo de forma global. Así se reduce el consumo innecesario de recursos en tablas que no se benefician del paralelismo.
Control del paralelismo a nivel de sistema, sesión y consulta
Elastic Parallel Query se puede habilitar y ajustar en tres niveles. El nivel que elija depende de su caso de uso:
System level: aplique Elastic Parallel Query de forma global para todas las consultas y sesiones. Utilice este nivel cuando su clúster esté dedicado a cargas de trabajo analíticas.
Session level: habilite, deshabilite o fuerce Elastic Parallel Query para la conexión actual. Más indicado para consultas analíticas ad hoc en un clúster con cargas de trabajo mixtas.
Query level: anule el paralelismo de una sola consulta mediante hints. Recomendado cuando necesita optimizar consultas específicas sin modificar los valores predeterminados de la sesión o del sistema.
Nivel de sistema
Configure los parámetros globales Grand Unified Configuration (GUC) para habilitar Elastic Parallel Query en todas las sesiones.
postgres=# alter system set polar_enable_px=1;
ALTER SYSTEM
postgres=# alter system set polar_px_dop_per_node=1;
ALTER SYSTEM
postgres=# select pg_reload_conf();
 pg_reload_conf
----------------
 t
(1 row)
postgres=# \c postgres
You are now connected to database "postgres" as user "postgres".

postgres=# drop table if exists t1;
DROP TABLE
postgres=# select id into t1 from generate_series(1, 1000) as id order by id desc;
SELECT 1000
postgres=# alter table t1 set (px_workers=1);
ALTER TABLE
postgres=# explain (verbose, costs off)   select * from t1 where id < 10;
                QUERY PLAN
-------------------------------------------
 PX Coordinator 2:1  (slice1; segments: 2)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)
El nodo PX Coordinator en la salida del plan confirma que Elastic Parallel Query está activo. El valor segments: 2 refleja el DoP multiplicado por la cantidad de nodos PX en uso.
Nivel de sesión
Controle Elastic Parallel Query para la sesión actual mediante la instrucción ALTER SESSION o los parámetros GUC. Los cambios se aplican únicamente a la conexión actual.
Sintaxis de ALTER SESSION
ALTER SESSION ENABLE PARALLEL QUERY
ALTER SESSION DISABLE PARALLEL QUERY
ALTER SESSION FORCE PARALLEL QUERY [PARALLEL integer]
ENABLE PARALLEL QUERY: permite usar hints y sintaxis para habilitar Elastic Parallel Query en esta sesión.DISABLE PARALLEL QUERY: bloquea Elastic Parallel Query en esta sesión, incluso si los hints lo especifican.FORCE PARALLEL QUERY [PARALLEL integer]: fuerza Elastic Parallel Query sin importar otras configuraciones. Si omitePARALLEL integer, el DoP toma de forma predeterminada el valor depolar_px_dop_per_node.
Priority order cuando hay conflictos entre varias configuraciones: hint a nivel de consulta (el más alto) > FORCE PARALLEL > polar_px_dop_per_node (el más bajo).
Después de reconectar la sesión actual, Elastic Parallel Query se habilita de forma predeterminada para dicha sesión.
Ejemplo: habilitación para una sesión:
--enable
postgres=# set polar_enable_px = false;
SET
postgres=# set polar_px_enable_hint = true;
SET
postgres=# alter session enable parallel query;
ALTER SESSION

postgres=# explain (verbose, costs off)   select /*+ PARALLEL(4)*/ * from t1 where id < 10;
INFO:  [HINTS] PX PARALLEL(4) accepted.
                QUERY PLAN
-------------------------------------------
 PX Coordinator 8:1  (slice1; segments: 8)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)

--disable
postgres=# set polar_enable_px = false;
SET
postgres=# set polar_px_enable_hint = true;
SET
postgres=# alter session disable parallel query;
ALTER SESSION

postgres=# explain (verbose, costs off)   select /*+ PARALLEL(4)*/ * from t1 where id < 10;
       QUERY PLAN
------------------------
 Seq Scan on public.t1
   Output: id
   Filter: (t1.id < 10)
(3 rows)

--force
postgres=# set polar_enable_px = false;
SET
postgres=# set polar_px_enable_hint = false;
SET
postgres=# alter session force parallel query;
ALTER SESSION

postgres=# explain (verbose, costs off)   select * from t1 where id < 10;
           QUERY PLAN
-------------------------------------------
 PX Coordinator 2:1  (slice1; segments: 2)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)

postgres=# alter session force parallel query parallel 2;
ALTER SESSION
postgres=# explain (verbose, costs off)   select * from t1 where id < 10;
                QUERY PLAN
-------------------------------------------
 PX Coordinator 4:1  (slice1; segments: 4)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)
Parámetros GUC
Establezca los parámetros GUC a nivel de sesión para habilitar o deshabilitar Elastic Parallel Query en la conexión actual.
postgres=# set polar_enable_px = true;
SET
postgres=# set polar_px_dop_per_node = 1;
SET
postgres=# explain (verbose, costs off)   select * from t1 where id < 10;
                QUERY PLAN
-------------------------------------------
 PX Coordinator 2:1  (slice1; segments: 2)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)
Nivel de consulta
Anule el paralelismo de una sola consulta mediante hints de SQL. Primero, habilite la compatibilidad con hints:
set polar_px_enable_hint = true; -- default: falseSintaxis de hints compatible:
/*+ PARALLEL(DEFAULT) */   -- use the DoP from polar_px_dop_per_node
/*+ PARALLEL(integer) */   -- use the specified DoP
/*+ NO_PARALLEL(tablename) */  -- disable Elastic Parallel Query for the specified table
Estos hints son compatibles con la sintaxis de hints de Oracle. Elastic Parallel Query solo admite los hints PARALLEL y NO_PARALLEL. Al usar varios hints:
Solo el primer bloque de hints surte efecto cuando se encadenan varios bloques (por ejemplo, /*+A*/ /*+B*/ ).
Si aparecen varios hints PARALLEL en un mismo bloque con el mismo DoP, solo uno surte efecto. Si especifican valores de DoP distintos, ninguno surte efecto.
Si un hintPARALLELy un hintNO_PARALLELaparecen en el mismo bloque, el hintNO_PARALLELno surte efecto.
Example:
postgres=# set polar_enable_px = false;
SET
postgres=# set polar_px_dop_per_node = 1;
SET
postgres=# set polar_px_enable_hint = true;
SET
postgres=# explain (verbose, costs off)   select * from t1 where id < 10;
       QUERY PLAN
------------------------
 Seq Scan on public.t1
   Output: id
   Filter: (t1.id < 10)
(3 rows)

postgres=# explain (verbose, costs off)   select /*+ PARALLEL(DEFAULT) */ * from t1 where id < 10;
                QUERY PLAN
-------------------------------------------
 PX Coordinator 2:1  (slice1; segments: 2)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)

postgres=# explain (verbose, costs off)   select /*+ PARALLEL(4) */ * from t1 where id < 10;
                QUERY PLAN
-------------------------------------------
 PX Coordinator 8:1  (slice1; segments: 8)
   Output: id
   ->  Partial Seq Scan on public.t1
         Output: id
         Filter: (t1.id < 10)
 Optimizer: PolarDB PX Optimizer
(6 rows)

postgres=# explain (verbose, costs off)   select /*+ PARALLEL(0) */ * from t1 where id < 10;
       QUERY PLAN
------------------------
 Seq Scan on public.t1
   Output: id
   Filter: (t1.id < 10)
(3 rows)

postgres=# explain (verbose, costs off)   select /*+ NO_PARALLEL(t1) */ * from t1 where id < 10;
       QUERY PLAN
------------------------
 Seq Scan on public.t1
   Output: id
   Filter: (t1.id < 10)
(3 rows)
Comportamiento combinado: configuraciones de sistema, sesión y consulta
La siguiente tabla muestra cómo se determinan los resultados cuando interactúan las configuraciones de sistema, sesión y consulta.
|
**Sistema ( |
Sesión |
Consulta |
Resultado |
|
|
|
Ningún hint |
Paralelo, DoP=X |
|
|
|
|
Paralelo, DoP=Y |
|
|
|
|
Serial |
|
|
|
Ningún hint |
Serial |
|
|
|
|
Serial |
|
|
|
|
Serial |
|
|
|
Ningún hint |
Paralelo, DoP=Z |
|
|
|
|
Paralelo, DoP=Y |
|
|
|
|
Serial |
|
|
|
Ningún hint |
Serial |
|
|
|
|
Paralelo, DoP=Y |
|
|
|
|
Serial |
|
|
|
Ningún hint |
Serial |
|
|
|
|
Serial |
|
|
|
|
Serial |
|
|
|
Ningún hint |
Paralelo, DoP=Z |
|
|
|
|
Paralelo, DoP=Y |
|
|
|
|
Serial |
Ejemplo: habilitar Elastic Parallel Query para una tabla
El siguiente ejemplo demuestra el efecto de Elastic Parallel Query en una consulta de una sola tabla.
Cree una tabla de prueba con un millón de filas:
CREATE TABLE test(id int);
INSERT INTO test SELECT generate_series(1,1000000);
EXPLAIN SELECT * FROM test;
De forma predeterminada, Elastic Parallel Query está deshabilitado y el planificador utiliza un escaneo secuencial:
                       QUERY PLAN
--------------------------------------------------------
 Seq Scan on test  (cost=0.00..35.50 rows=2550 width=4)
(1 row)
Habilite Elastic Parallel Query para la tabla y vuelva a ejecutar la consulta:
ALTER TABLE test SET (px_workers=1);
SET polar_enable_px=on;
EXPLAIN SELECT * FROM test;
Ahora el plan utiliza un PX Coordinator, lo cual confirma que la ejecución paralela está activa:
QUERY PLAN
-------------------------------------------------------------------------------
 PX Coordinator 2:1  (slice1; segments: 2)  (cost=0.00..431.00 rows=1 width=4)
   ->  Seq Scan on test (scan partial)  (cost=0.00..431.00 rows=1 width=4)
 Optimizer: PolarDB PX Optimizer
(3 rows)
Para consultar los nodos de solo lectura disponibles y asignar nodos específicos a Elastic Parallel Query:
-- List all read-only nodes
SHOW polar_cluster_map;
 polar_cluster_map
-------------------
  node1,node2,node3
(1 row)

-- Use only node1 and node2
SET polar_px_nodes='node1,node2';

SHOW polar_px_nodes;
 polar_px_nodes
----------------
  node1,node2
(1 row)
Datos de rendimiento
Los siguientes resultados provienen de una prueba realizada con cinco nodos de solo lectura:
Escaneo completo de tabla (
SELECT COUNT(*)): Elastic Parallel Query es 60 veces más rápido que la ejecución paralela en un solo nodo.Consultas TPC-H: Elastic Parallel Query es 30 veces más rápido que la ejecución paralela en un solo nodo.
Esta prueba se basa en el benchmark TPC-H, pero no cumple con todos sus requisitos. Por lo tanto, es posible que los resultados no sean directamente comparables con los benchmarks TPC-H publicados.