Un clúster de PolarDB for MySQL HTAP puede atender cargas de trabajo OLTP y OLAP. Si ambos tipos de tráfico usan el mismo endpoint de clúster, las consultas de almacenamiento por filas pueden competir por recursos con las consultas analíticas. Para aislar el tráfico, configure endpoints de clúster separados. Restrinja uno a nodos de almacenamiento por filas para OLTP. Restrinja el otro a nodos de almacenamiento por columnas para OLAP. Dirija cada aplicación a su endpoint designado.
Cómo funciona el enrutamiento
PolarDB enruta las solicitudes a través de tres capas. Comprender el orden ayuda a decidir dónde intervenir cuando el enrutamiento no funciona como se espera.
|
Capa |
Mecanismo |
Alcance |
|
1. Endpoint de clúster |
Restringe los nodos a los que puede llegar un endpoint |
Nivel de conexión |
|
2. Optimización basada en costos |
Selecciona un plan de ejecución de almacenamiento por filas o por columnas según el costo estimado |
Nivel de sentencia (automático) |
|
3. Hint de SQL |
Fuerza un plan de ejecución específico y sobrescribe la optimización basada en costos |
Nivel de sentencia (manual) |
En condiciones normales, la capa 1 separa el tráfico OLTP del OLAP. La capa 2 selecciona el plan automáticamente. Use la capa 3 solo cuando la selección automática produzca resultados inesperados para una sentencia específica.
Las reglas de enrutamiento predeterminadas son:
Solicitudes de escritura OLTP: siempre se enrutan al nodo principal.
Solicitudes de lectura OLTP: se enrutan a nodos de almacenamiento por filas de solo lectura o al nodo principal.
Solicitudes de lectura OLAP: se enrutan a nodos de almacenamiento por columnas de solo lectura.
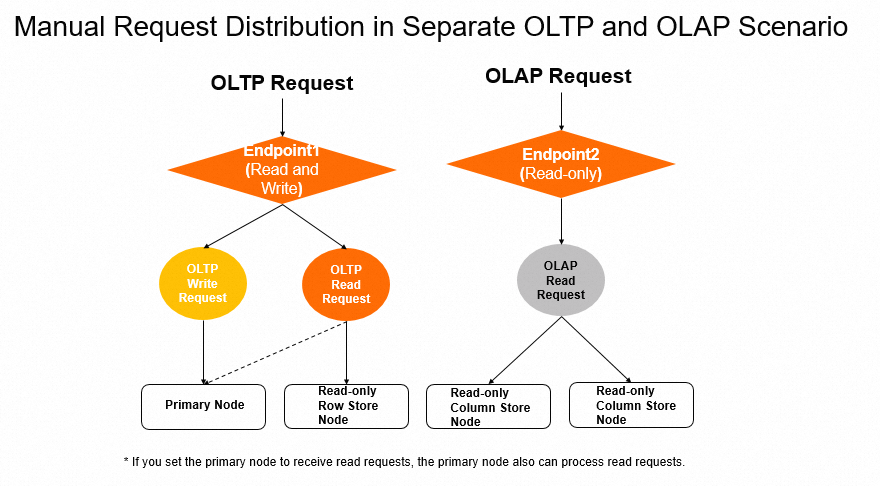
Configure los endpoints de clúster
Configure dos endpoints de clúster. Uno será para el tráfico OLTP. El otro será para el tráfico OLAP. Para obtener instrucciones sobre cómo crear y gestionar endpoints de clúster, consulte Manage the endpoints of a cluster.
Endpoint OLTP
Elija uno de los modos que se muestran a continuación:
|
Modo |
Configuración de nodos |
|
Read-only |
Agregue únicamente nodos de almacenamiento por filas de solo lectura a la lista de nodos seleccionada. |
|
Read/Write (Automatic Read/Write Splitting) |
Agregue como mínimo un nodo de almacenamiento por filas de solo lectura. Si Primary Node Accepts Read Requests está establecido en Yes, las solicitudes de lectura también se distribuyen al nodo principal. |
En el modo Read/Write (Automatic Read/Write Splitting), todas las solicitudes de escritura van al nodo principal. Esto ocurre independientemente de si el nodo principal está en la lista de nodos seleccionada.
Endpoint OLAP
Las cargas de trabajo OLAP solo incluyen solicitudes de lectura. Use el modo Read-only y agregue como mínimo un nodo de almacenamiento por columnas de solo lectura a la lista de nodos seleccionada.
Sobrescriba el enrutamiento con hints de SQL
Cuando una sentencia llega a un nodo de almacenamiento por columnas de solo lectura, PolarDB decide el plan de ejecución. Para ello, compara el costo de ejecución estimado con el parámetro loose_cost_threshold_for_imci. Si el costo supera el umbral, PolarDB usa el plan de almacenamiento por columnas. Este plan se basa en In-Memory Column Index (IMCI). De lo contrario, usa el plan de almacenamiento por filas.
Para sobrescribir esta selección automática en una sentencia específica, agregue un hint de SQL. Un hint de SQL se aplica solo a la sentencia a la que está asociado. No tiene efecto sobre otras sentencias de la misma conexión ni de otras conexiones.
Para MySQL 5.7.7 y versiones anteriores, agregue la opción --comments al conectarse al motor de la base de datos. De lo contrario, el cliente elimina los hints antes de enviar la sentencia. Ejecute mysql --version para comprobar la versión del cliente.
Fuerce un plan de ejecución de almacenamiento por columnas
Establezca el umbral de costo en 0 agregando /*+ SET_VAR(cost_threshold_for_imci=0) */. Esto fuerza el plan de almacenamiento por columnas, independientemente del costo estimado real.
/*FORCE_IMCI_NODES*/EXPLAIN SELECT /*+ SET_VAR(cost_threshold_for_imci=0) */ COUNT(*) FROM t1 WHERE t1.a > 1;Dentro de /*+SET_VAR()*/, omita el prefijo loose_ del nombre del parámetro. Si usa loose_cost_threshold_for_imci en el hint, este no surte efecto. Use cost_threshold_for_imci en su lugar.
Fuerce un plan de ejecución de almacenamiento por filas
Agregue /*+ SET_VAR(USE_IMCI_ENGINE=OFF) */ para omitir por completo el motor de almacenamiento por columnas.
EXPLAIN SELECT /*+ SET_VAR(USE_IMCI_ENGINE=OFF) */ COUNT(*) FROM t1 WHERE t1.a > 1;