PolarDB for MySQL ofrece una búsqueda de texto completo nativa en columnstore basada en In-Memory Column Index (IMCI). Puede crear índices de texto completo directamente sobre tablas existentes y lograr consultas difusas en milisegundos mediante la función MATCH y la capacidad optimizada de aceleración de LIKE. En comparación con soluciones externas como Elasticsearch, IMCI garantiza consistencia transaccional entre los datos y los índices. Además, evita la latencia de sincronización de datos y reduce la complejidad de la arquitectura general.
Conceptos clave
Para comprender la búsqueda de texto completo en PolarDB IMCI, es necesario conocer a continuación los conceptos clave:
|
Concepto |
Descripción |
|
Documento |
Unidad de datos sin procesar que se va a indexar. En PolarDB IMCI, un documento corresponde específicamente a una fila de datos en el column store. |
|
Término |
Unidad lingüística básica extraída de un documento tras el procesamiento del tokenizer. Es la unidad mínima para indexar y consultar. |
|
Tokenizer |
Componente que divide el texto sin procesar en una secuencia de términos. PolarDB IMCI proporciona varios tokenizers (como |
|
Índice invertido |
Estructura de datos central de la búsqueda de texto completo que registra la correspondencia entre cada término y la lista de documentos que lo contienen. Está formado por un diccionario de términos y posting lists, y acelera las consultas de texto. |
|
Diccionario de términos |
Almacena la colección de todos los términos y permite búsquedas rápidas. PolarDB IMCI utiliza el algoritmo FST (Finite State Transducer) para construir el diccionario. La complejidad temporal de la consulta es O(len(term)), con un bajo consumo de espacio. |
|
Posting list |
Registra la lista de todos los identificadores de documento (números de fila de 64 bits en IMCI) que contienen un término específico. PolarDB IMCI usa el algoritmo RBM (Roaring Bitmap) para comprimir y calcular las posting lists, lo cual ofrece un buen rendimiento tanto en escenarios de datos dispersos como densos. |
A continuación se comparan la solución integrada de PolarDB IMCI y la solución externa "base de datos + Elasticsearch":
|
Dimensión de comparación |
Búsqueda de texto completo de PolarDB IMCI |
Solución "base de datos + Elasticsearch" |
|
Consistencia de datos |
Consistencia fuerte. Las actualizaciones de índice y las escrituras de datos se completan dentro de la misma transacción y siguen los principios ACID, por lo que no existe latencia de datos ni riesgo de inconsistencia. |
Consistencia eventual. Los datos deben sincronizarse desde la base de datos hacia Elasticsearch, lo que introduce latencia de sincronización. No se puede garantizar la actualización oportuna de los datos ni la atomicidad transaccional. |
|
Complejidad de la arquitectura |
Baja. La función está integrada en la base de datos. No se requieren componentes nuevos y la arquitectura permanece clara. |
Alta. Debe desplegar y mantener un clúster de Elasticsearch independiente y una canalización de sincronización de datos, lo que aumenta la heterogeneidad del sistema. |
|
Método de consulta |
Unificado. Todos los datos, estructurados y no estructurados, se consultan con SQL estándar. |
Fragmentado. Debe usar tanto SQL como el DSL de Elasticsearch para las consultas. Esto suele derivar en consultas de dos etapas, donde primero se consulta Elasticsearch y luego la base de datos, lo que añade latencia y complejidad al código. |
|
Costo de operación y mantenimiento |
Bajo. Reutiliza los sistemas de operación y mantenimiento y de alta disponibilidad de PolarDB. No requiere habilidades especializadas de operación y mantenimiento ni recursos de servidor adicionales. |
Alto. Requiere recursos de servidor dedicados y capacidades profesionales de operación y mantenimiento de Elasticsearch. Almacenar dos copias de los datos también incrementa el costo de almacenamiento. |
Funcionamiento
La búsqueda de texto completo en PolarDB IMCI se basa en la tecnología de índices invertidos. Convierte datos de texto no estructurados en un índice estructurado, lo que mejora significativamente el rendimiento de las consultas por palabra clave. El proceso principal se muestra en la siguiente figura:
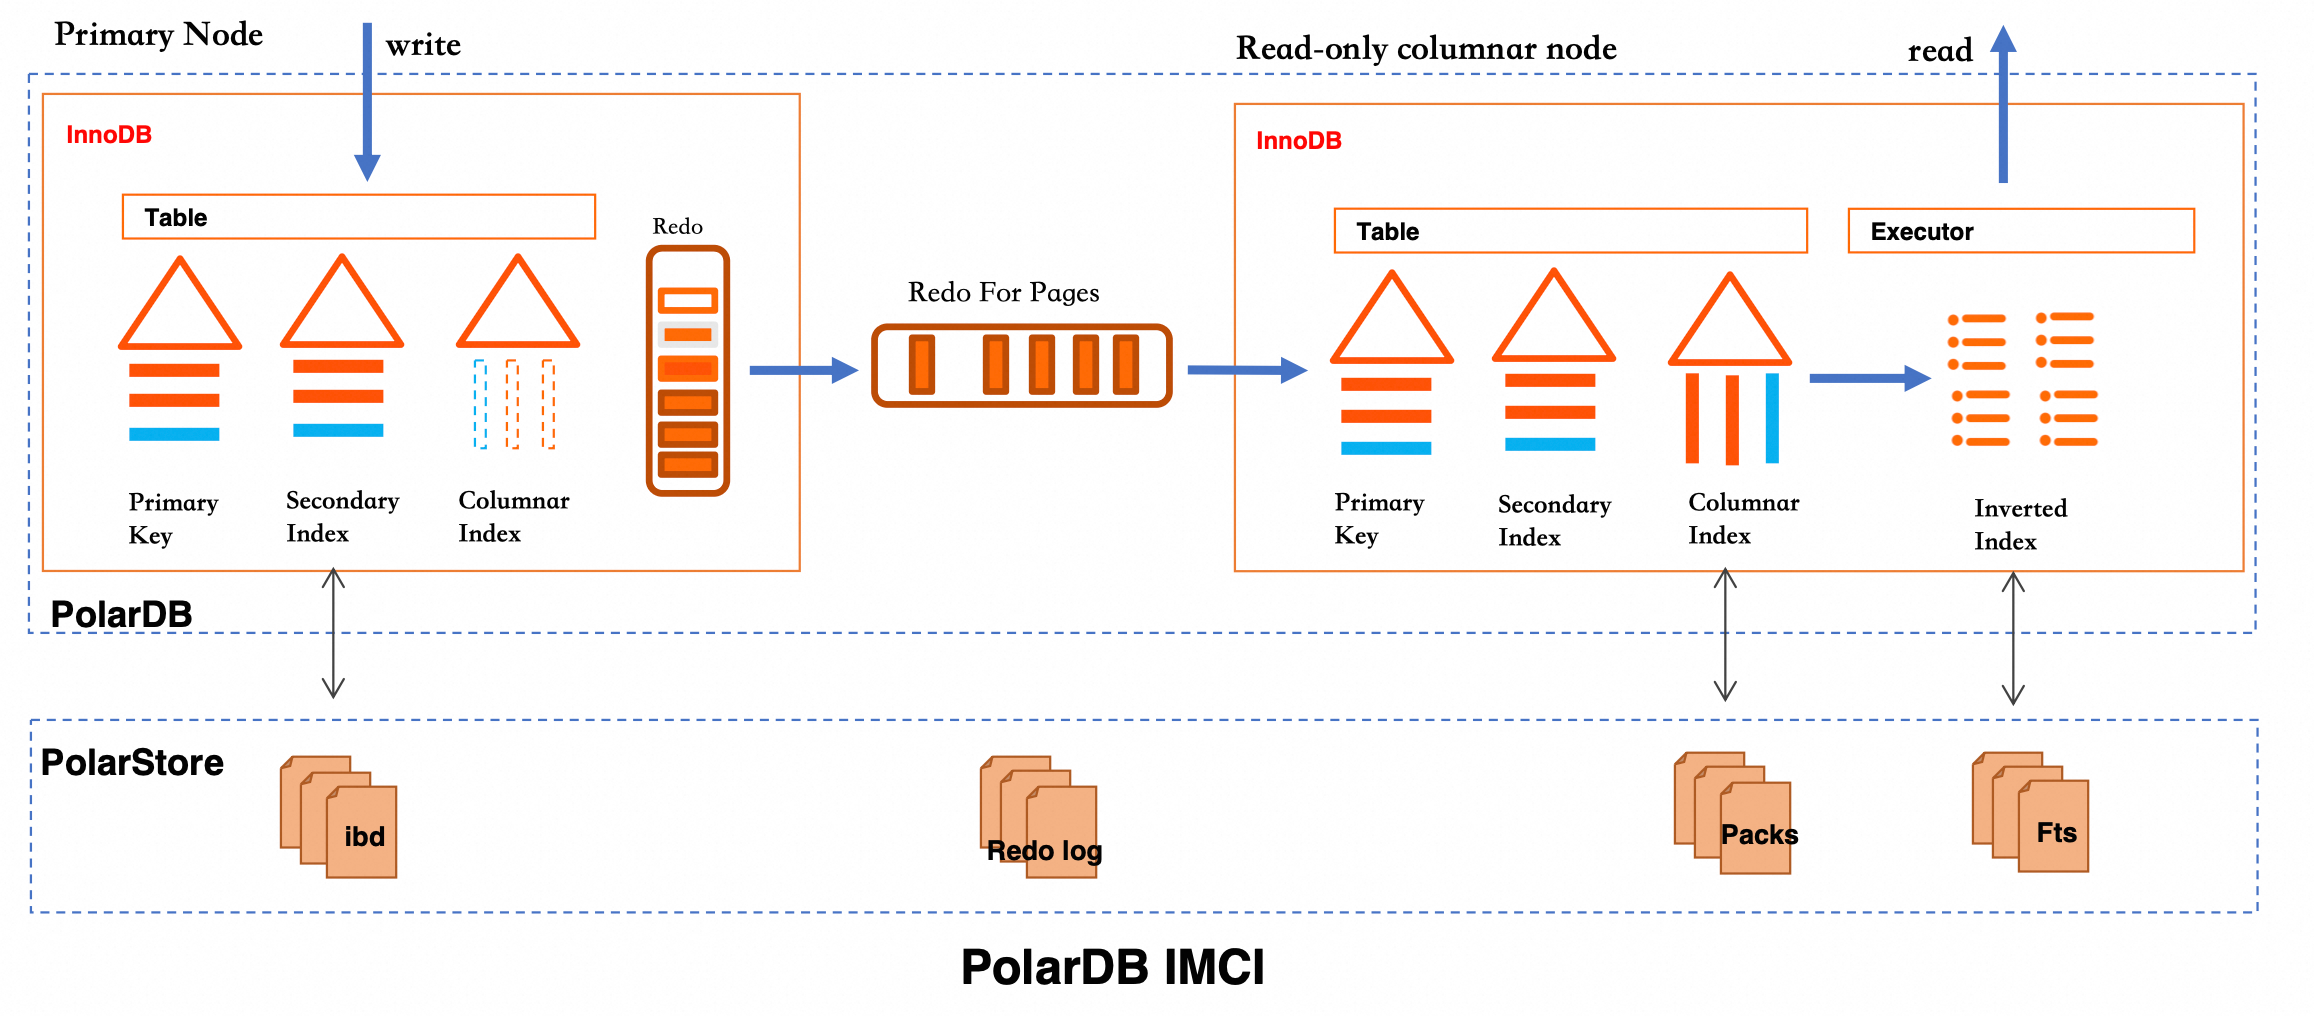
Cuando se escriben datos, el contenido de la tabla InnoDB se sincroniza con los archivos Pack en PolarStore mediante el índice de columnstore. Durante la fase de consulta, el ejecutor construye el índice invertido sobre los datos del column store y utiliza archivos Fts para completar la coincidencia de texto completo de manera eficiente. Esta arquitectura permite que el row store y el column store trabajen en conjunto, lo que equilibra el rendimiento de escritura y las capacidades de consulta compleja.
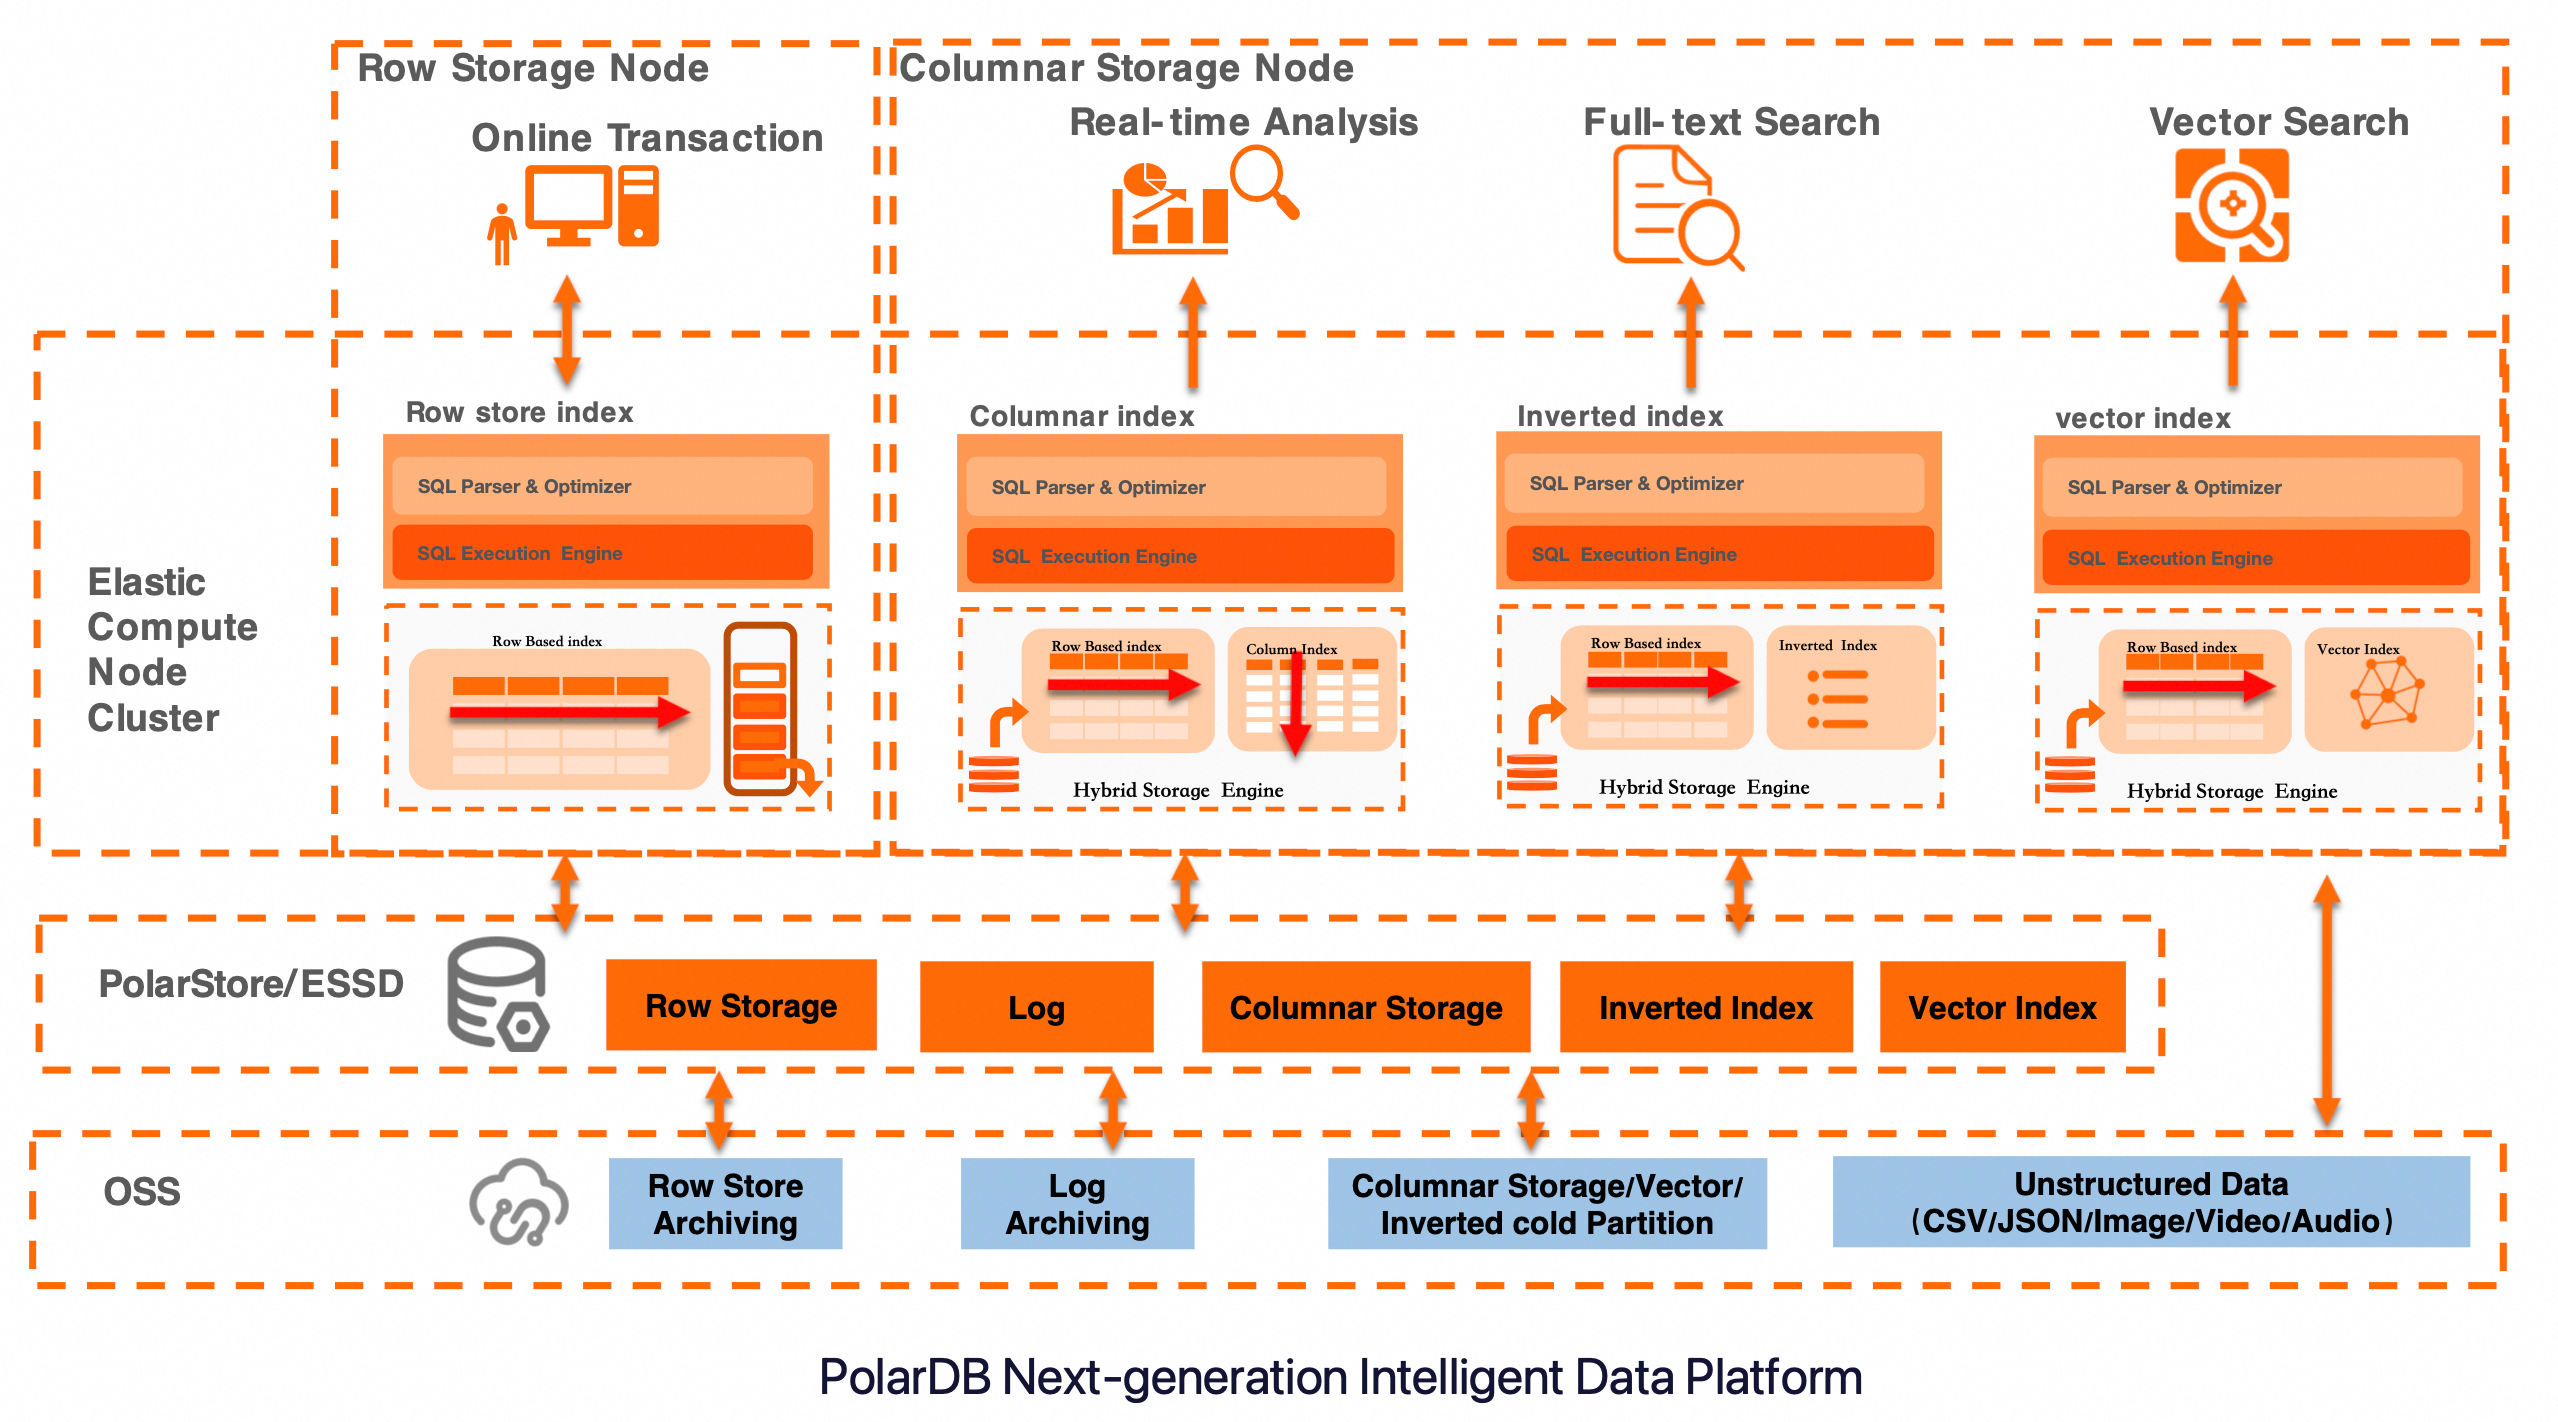
PolarDB IMCI utiliza una arquitectura de almacenamiento híbrido unificada compatible con varios modos de consulta. Como se observa en la figura, la búsqueda de texto completo depende del Hybrid Storage Engine para construir y mantener índices invertidos que permitan búsquedas de texto eficientes. También combina nodos de cómputo elástico con almacenamiento escalonado para equilibrar escrituras de alto rendimiento y consultas de baja latencia. Sobre esta base, la capacidad integrada de índices vectoriales admite además la recuperación multimodal combinada de texto y vectores. Esta arquitectura es adecuada para escenarios como la búsqueda de productos en comercio electrónico, el análisis de registros y la recuperación en bases de conocimiento. Asimismo, ofrece a los usuarios una plataforma de servicios de datos integral que integra OLTP, análisis en tiempo real, búsqueda de texto completo y búsqueda vectorial.
Tokenizers
La tokenización es el proceso de dividir el texto en términos y constituye la base de la búsqueda de texto completo. Elegir un tokenizer adecuado es fundamental para la precisión y el rendimiento de la recuperación. IMCI admite los siguientes tokenizers:
|
Tokenizer |
Descripción |
|
token |
Divide el texto en caracteres no alfanuméricos, como espacios y signos de puntuación. Recomendado para inglés y otros idiomas que usan espacios como separadores. |
|
ngram |
Divide el texto en términos continuos con una longitud de caracteres predefinida (n). |
|
jieba |
Basado en la biblioteca de tokenización de chino |
|
ik |
Basado en |
|
json |
Extrae valores de clave específicos o elementos de matriz de un objeto JSON como términos mediante expresiones JSONPath. Se utiliza para la recuperación profunda de datos JSON. |
Además, PolarDB IMCI proporciona la función de utilidad de tokenización dbms_imci.fts_tokenize para probar los resultados de tokenización. Esta función es compatible con todos los tokenizers y sus propiedades correspondientes. Distintos resultados de tokenización pueden provocar que las consultas del índice de texto completo difieran de lo esperado, o que MATCH y LIKE devuelvan resultados inconsistentes. En estos casos, utilice esta función de utilidad para comprobar los resultados de tokenización.
Posting lists
En términos sencillos, una posting list (Postings List) es un conjunto de identificadores de documento. Sus aspectos técnicos clave radican en un almacenamiento comprimido altamente eficiente y en cálculos de alto rendimiento (como la intersección).
En un índice de texto completo de PolarDB IMCI, una posting list almacena el conjunto de números de fila de todas las filas del índice de columnstore que contienen un término específico, junto con la frecuencia del término correspondiente (opcional) y la frecuencia del documento (opcional). Cada término corresponde a una posting list.
IMCI utiliza el algoritmo RBM (Roaring Bitmaps) para comprimir y calcular las posting lists (es decir, los conjuntos de identificadores de documento).
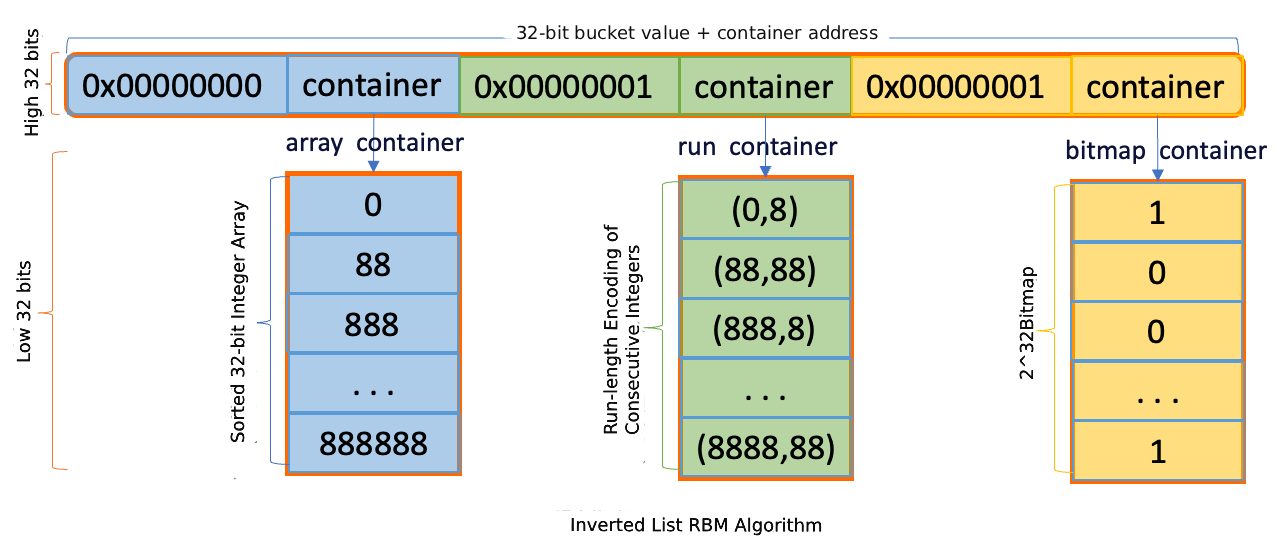
La implementación de RBM se basa en la biblioteca CRoaring y selecciona dinámicamente una estrategia de almacenamiento según la densidad de los datos:
Si la cantidad de identificadores de documento en la posting list es menor que un umbral predefinido, se utiliza
std::arraypara el almacenamiento.Si la cantidad supera el umbral, el almacenamiento cambia al tipo
roaring::Roaring64Mappara manejar datos dispersos o densos a gran escala y mantener una alta relación de compresión.
Características de rendimiento:
Admite búsquedas con complejidad O(logN) durante la construcción del índice.
Admite aceleración mediante instrucciones SIMD para operaciones de conjuntos como intersección y unión.
Permite reorganizar el espacio cuando los datos se escriben en disco para reducir la fragmentación.
Permite usar valores
minimum/maximumpara filtrar rápidamente y optimizar iteradores durante las consultas.
Diccionario de términos
La idea central de un índice invertido consiste en usar un diccionario para encontrar rápidamente la posting list a la que se asigna un término. Por ello, el diseño del diccionario que relaciona términos con posting lists resulta especialmente importante. Entre los diseños comunes se encuentran el trie, el árbol B+ y el FST.
IMCI utiliza el algoritmo FST (Finite State Transducer) para construir el diccionario de términos y equilibrar la eficiencia temporal con la eficiencia espacial.
Eficiencia espacial: al compartir los prefijos y sufijos comunes de los términos, el espacio de almacenamiento se comprime de manera efectiva.
Eficiencia temporal: la complejidad temporal de la búsqueda de un término es O(L), donde L es la longitud del término.
Por ejemplo, suponga que los términos China, Chinese y love se insertan en orden, y que los desplazamientos de dirección de sus posting lists son 5, 10 y 15. El diccionario que se construye se muestra en la siguiente figura. La figura indica que el FST no solo comparte prefijos y sufijos comunes para ahorrar espacio, sino que también garantiza que cada transición tenga un valor asociado único. Una consulta comienza en el estado inicial 0 y revisa cada carácter del término para buscar una arista saliente con ese carácter. Si la arista existe, la consulta acumula el valor asociado. De lo contrario, comprueba si el estado actual es un estado final. Por ejemplo, Chinese acumula un valor asociado de 15 y su último carácter es un estado final, lo que significa que el término existe en el diccionario. Además, el cálculo de prefijos del FST se basa en bytes y no en caracteres, por lo que también admite codificaciones como UTF-8. 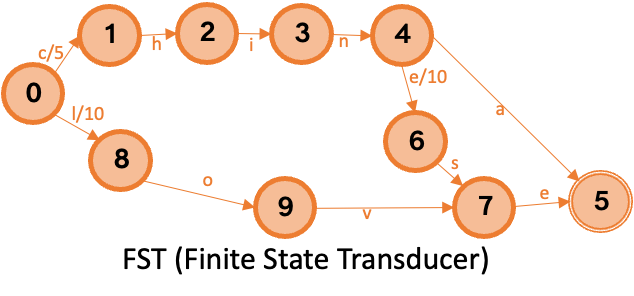
Construcción del índice invertido
PolarDB IMCI utiliza el algoritmo SPIMI para construir índices invertidos. Mediante un único escaneo, la tokenización y la generación por lotes del diccionario y las posting lists, admite la construcción eficiente de índices locales con un uso de memoria controlado.
Cuando el índice de texto completo de PolarDB IMCI se construye con SPIMI, IMCI lee continuamente los datos de columnstore de la columna de destino y tokeniza cada fila para obtener un conjunto de términos. Luego, agrega cada término y su número de fila correspondiente a una tabla hash mientras acumula un valor de uso de memoria. Cuando el uso de memoria supera el umbral de tamaño de segmento, IMCI construye un diccionario a partir de los términos y las posting lists de la tabla hash, restablece la memoria y continúa con la siguiente fila hasta procesar todos los datos de columnstore. El proceso principal para construir un diccionario (FST) a partir de la tabla hash (std::unordered_map) es el siguiente: primero se ordena la tabla hash por término (clave); después se serializan todas las posting lists de la tabla hash en el disco en orden y se registran sus direcciones de desplazamiento relativas en el disco; a continuación, se agrega cada término y la dirección de desplazamiento de su posting list al algoritmo FST en orden para construir el diccionario; por último, se comprime el diccionario, se escribe en el disco y se registra la información del segmento actual en los metadatos (incluido el tamaño del diccionario, la dirección de inicio del diccionario, la dirección de inicio de la posting list y el rango de números de fila). PolarDB no construye un diccionario global para evitar la ordenación externa (un diccionario global también tendría que dividirse por prefijo para poder construir un índice de términos sobre él). En cambio, dado que el almacenamiento de columnstore usa un modelo de escritura de solo anexado, PolarDB emplea un método de construcción ligero que genera varios diccionarios locales según el umbral de memoria, como se muestra en la siguiente figura. Cuando hay memoria suficiente, aumente el umbral de memoria tanto como sea posible. De este modo, más instancias del mismo término quedarán en el mismo segmento invertido, lo que ahorra espacio y mejora el rendimiento de las consultas. 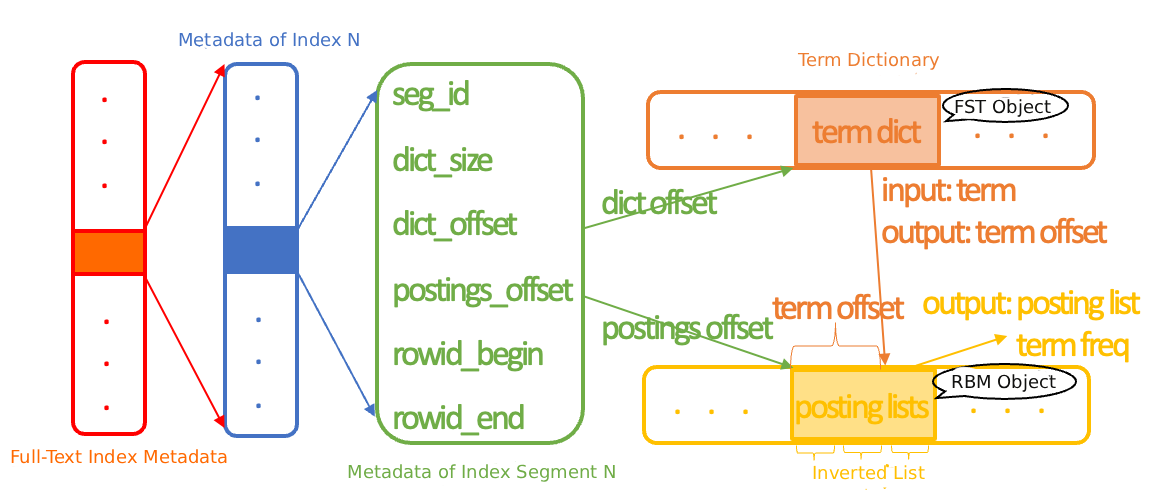
Además de la construcción normal del índice invertido descrita anteriormente, el índice de texto completo de PolarDB IMCI también admite la fusión asíncrona de índices invertidos cuando el sistema está inactivo en segundo plano. El índice de columnstore de PolarDB IMCI es un índice secundario de una tabla normal. En INSERT, los datos siempre se anexan al motor de almacenamiento de columnstore por columna en el orden de inserción. DELETE utiliza marcado para eliminación, y UPDATE se convierte en DELETE más INSERT. IMCI usa la matriz InsertMask para marcar la versión de inserción de cada fila en los datos de columnstore para las comprobaciones de visibilidad, y emplea lsm DeleteMask para marcar una fila existente como eliminada. Al mismo tiempo, las operaciones en segundo plano como Compaction y Recycle asíncronos reorganizan los datos y recuperan espacio. Como parte del motor de columnstore, el índice de texto completo de PolarDB IMCI también utiliza una tarea de Compaction asíncrona de índice invertido en segundo plano para limpiar periódicamente los datos marcados como eliminados, lo que ahorra espacio y mejora el rendimiento de las consultas. La fusión de índices invertidos toma como unidad el segmento invertido: varios segmentos invertidos se fusionan en uno nuevo, y los segmentos originales no se modifican. Esto evita que los objetos de instantánea de índice invertido que utilizan las consultas queden invalidados. Cuando finaliza la fusión, se genera una nueva instantánea de índice invertido y las nuevas consultas usan esa instantánea. Gracias al método de construcción local y al diseño de marcado para eliminación, una inserción masiva no desencadena una reconstrucción global en el índice de texto completo de PolarDB IMCI, ya que solo se construye la parte incremental. El costo de actualización también es muy bajo porque solo se requiere una marca de eliminación, por lo que el rendimiento de escritura no se ve afectado incluso en escenarios de actualización frecuente. Además, la fusión asíncrona periódica en segundo plano produce índices invertidos más compactos para mejorar el rendimiento de las consultas. Combinado con la capacidad de consulta concurrente del column store, esto cumple los requisitos de respuesta en milisegundos incluso en escenarios de datos masivos.
Recuperación con índice invertido
El índice de texto completo de PolarDB IMCI admite la función oficial de MySQL MATCH y el operador LIKE.
-
Función
MATCHPolarDB IMCI admite el uso de la función
MATCHpara búsquedas de texto completo, independientemente de si existe un índice de texto completo en el row store. Si no existe un índice de row store, la consulta se enruta directamente al nodo de column store. Si existe un índice de row store, la consulta se distribuye de forma inteligente según la evaluación de costos. Para evitar que las operaciones que consumen mucho tiempo y que desencadena un índice de texto completo nativo de MySQL durante la fase de optimización (como la sincronización de tablas auxiliares y la carga de caché) afecten el rendimiento del column store, PolarDB omite estas operaciones al inicio de la distribución de consultas.Durante la fase de ejecución, IMCI proporciona dos métodos de recuperación: el operador
FtsTableScany la expresiónMATCH. El primero obtiene las filas coincidentes directamente del índice invertido y es adecuado para escenarios con una alta proporción de filtrado. El segundo busca el índice por número de fila y conviene en escenarios donde las condiciones previas ya han filtrado la mayor parte de los datos. La eficiencia de ejecución de ambos métodos depende de qué tan bien filtren los datos los demás predicados. Por ello, el optimizador de column store estima la proporción de filtrado a partir de las estadísticas y selecciona dinámicamente la estrategia óptima. Cuando se elige el método de operador, el sistema reescribe automáticamente la funciónMATCHen los operadoresFtsTableScan + Filter.El índice de texto completo se construye de forma asíncrona, lo que puede retrasar brevemente la visibilidad de los datos nuevos. De manera predeterminada, el ejecutor de column store completa los resultados de la consulta con un escaneo de tabla completa sobre los datos no indexados para garantizar la integridad de los resultados. Un parámetro controla si se omite ese paso, de modo que pueda equilibrar de forma flexible el rendimiento y la consistencia en escenarios de alta concurrencia y grandes volúmenes de datos. También puede ajustar los parámetros de construcción del índice para aumentar la frecuencia de sincronización de datos y reducir el alcance del escaneo de tabla completa, lo que mejora aún más la eficiencia de las consultas.
-
Aceleración de
LIKEBajo condiciones específicas, PolarDB IMCI admite la conversión mutua entre
LIKEyMATCH. ConvertirLIKEaMATCHse usa principalmente para acelerar consultas y reducir la sobrecarga de comparar cadenas fila por fila en grandes cantidades durante los escaneos de tabla completa.Actualmente, esta conversión solo surte efecto cuando el índice de texto completo de columnstore utiliza el tokenizer
ngramy la longitud del tokenngrames menor o igual que la longitud de la cadena de patrón deLIKE. Bajo esta condición, el optimizador puede reescribir un predicado comoLIKE '%abc%'en los operadoresFtsTableScan + Filter, y usar el índice invertido para filtrar rápidamente las filas candidatas.Sin embargo, dado que el mecanismo de coincidencia de la tokenización
ngramdifiere de la semántica deLIKE(por ejemplo,"abbc"se tokeniza enab,bbybc, que se superponen conabybcde"abc"y podrían evaluarse falsamente como una coincidencia), la expresiónLIKEoriginal se conserva como condición de filtro posterior para la verificación exacta y garantizar la corrección de los resultados.Este mecanismo mejora significativamente el rendimiento de las consultas y equilibra de manera efectiva la precisión semántica con la eficiencia de ejecución.
El índice invertido de PolarDB IMCI consta de varios segmentos invertidos. Cada segmento invertido contiene sus propios metadatos, un diccionario de términos y una serie de posting lists, donde cada término corresponde de forma única a una posting list. Los metadatos registran información como las direcciones de inicio del diccionario y de las posting lists. Los metadatos ocupan poco espacio y residen en memoria de manera predeterminada para acelerar el acceso al índice.
La recuperación con índice invertido se realiza por segmento invertido. El proceso principal incluye leer los datos del diccionario, construir el objeto de diccionario FST (Finite State Transducer), buscar el término de destino en el diccionario y leer la posting list correspondiente para construir el objeto de posting list RBM (Roaring Bitmap).
Específicamente, las consultas se dividen en dos modos:
Consulta por operador: recorre los metadatos de todos los segmentos invertidos, obtiene la dirección de inicio del diccionario, carga los datos del diccionario, construye el objeto de diccionario y busca el término de destino. Si encuentra el término, combina la dirección de desplazamiento de la posting list del término con la dirección de inicio en el segmento para leer el objeto completo de la posting list.
Consulta por expresión: determina el conjunto de segmentos invertidos según el número de fila, filtra adicionalmente por el rango de números de fila en los metadatos y luego realiza una búsqueda en el diccionario y una lectura de la posting list similar a la consulta por operador en los segmentos invertidos coincidentes.
Para mejorar el rendimiento, IMCI admite el almacenamiento en caché del diccionario de términos. Utiliza un mecanismo de caché LRU (Least Recently Used) independiente, y el módulo de programación ajusta dinámicamente la cuota de memoria de dicha caché. Una sola posting list suele ser pequeña (la mayoría requiere solo una operación de E/S de 4 KB) y existen muchas posting lists, por lo que la tasa de aciertos de la caché y la ventaja de almacenarlas en caché son limitadas. Por ello, el almacenamiento en caché de posting lists está deshabilitado de manera predeterminada para evitar desperdiciar recursos de memoria.
Este diseño equilibra el uso de memoria y la sobrecarga de E/S, al tiempo que garantiza la eficiencia de las consultas.
Casos de uso
La función de búsqueda de texto completo de PolarDB IMCI es adecuada para muchos escenarios de negocio que requieren búsquedas rápidas sobre contenido de texto.
-
Búsqueda de productos y consultas en sitios de comercio electrónico
En una plataforma de comercio electrónico, los usuarios suelen buscar productos por palabra clave. La coincidencia difusa tradicional basada en
LIKEtiene un rendimiento deficiente y no cumple los requisitos de respuesta bajo alta concurrencia. Una solución externa con Elasticsearch acelera la búsqueda, pero su latencia de sincronización suele hacer que los resultados incluyan productos retirados, con precios modificados o sin existencias, lo que degrada la experiencia del usuario.PolarDB IMCI proporciona búsqueda de texto completo nativa y construye índices invertidos eficientes en campos de texto como títulos, descripciones y atributos de productos. Las consultas completan la coincidencia de palabras clave dentro de la base de datos, lo que evita la latencia entre sistemas y mantiene los resultados de búsqueda fuertemente consistentes con el estado en tiempo real de cada producto, como su precio e inventario. Lo que el usuario encuentra es exactamente lo que puede comprar.
-
Análisis de registros y observability
Durante la operación y el mantenimiento, así como en la resolución de problemas, los desarrolladores y los ingenieros de operación y mantenimiento deben localizar rápidamente pilas de errores, rastrear cadenas de solicitudes o analizar comportamientos anómalos en volúmenes masivos de registros. La arquitectura ELK tradicional es potente, pero tiene muchos componentes, su despliegue es complejo y su mantenimiento es costoso. Además, introduce un retraso notable entre el momento en que se escriben los datos y el momento en que se pueden consultar.
Con PolarDB IMCI, puede crear un índice de texto completo directamente en el campo
messageocontentde una tabla de registros y usar SQL estándar para recuperar registros en milisegundos. Puede ejecutar consultas interactivas y rastrear el contexto sin construir una plataforma de análisis de registros independiente. Esto simplifica significativamente la pila tecnológica, reduce los costos de almacenamiento y de operación y mantenimiento, y hace que la localización de problemas sea más eficiente. -
Recuperación en documentos y bases de conocimiento
Para una base de conocimiento interna, un manual de producto, una sección de preguntas frecuentes o un centro de ayuda, el requisito principal es permitir que los usuarios encuentren rápidamente la información que necesitan. Depender de un motor de búsqueda externo implica mantener una lógica de doble escritura, y el contenido puede perder fácilmente la sincronización después de una actualización.
Construya un índice de texto completo sobre el cuerpo del documento con PolarDB IMCI y use un tokenizer de chino como
jiebaoikpara mejorar la precisión de la tokenización. Así podrá almacenar y recuperar contenido en la misma base de datos. El contenido se puede buscar inmediatamente después de actualizarlo, el modelo de permisos reutiliza su sistema existente y no se requiere ningún mecanismo de sincronización adicional. El contenido publicado es visible de inmediato y cualquier edición surte efecto al instante. -
Creación de perfiles de usuario y análisis de comportamiento
Las operaciones precisas con usuarios dependen de la minería profunda de texto no estructurado, como extraer intereses y preferencias de comentarios, etiquetas y publicaciones de los usuarios. El enfoque tradicional exporta los datos a un almacén de datos o a un sistema de análisis, lo cual es un proceso complejo y con poca actualización oportuna.
PolarDB IMCI admite la construcción de índices con el tokenizer
jsonen campos JSON o con el tokenizerjiebaen campos de texto largo. Después, una sola instrucción SQL puede combinar atributos estructurados, como edad y región, con semántica de texto, como "disfruta de los deportes al aire libre" o "busca buena relación calidad-precio", para realizar un análisis conjunto. La segmentación de usuarios y la obtención de información sobre su comportamiento se completan en tiempo real sin migración de datos, lo que respalda operaciones detalladas y recomendaciones personalizadas.
Pruebas de rendimiento
ESRally es la herramienta oficial de pruebas de rendimiento de Elasticsearch de Elastic. Este tema utiliza su conjunto de datos integrado http_logs para evaluar el rendimiento de recuperación del índice de texto completo de columnstore de PolarDB IMCI.
Preparar el conjunto de datos
-
Obtenga el conjunto de datos:
Para obtener detalles sobre el conjunto de datos, consulte Elasticsearch Rally Hub. Puede obtener el conjunto de datos de la siguiente manera. El paquete comprimido rally-track-data-http_logs.tar pesa aproximadamente 1.7 GB. Tras descomprimirlo, el conjunto de datos ocupa unos 32 GB y contiene 247 millones de filas en total.
git clone https://github.com/elastic/rally-tracks.git cd rally-tracks ./download.sh http_logs -
Cree una tabla:
Dado que un pequeño número de filas del conjunto de datos contiene datos JSON incompatibles con el tipo JSON de MySQL, se utiliza varchar(512) para almacenarlos. Después de importar los datos, se emplea una columna virtual para extraer el campo request del JSON.
CREATE TABLE http_logs( logs varchar(4096) ); -
Importe los datos:
Utilice LOAD DATA para importar el conjunto de datos a la base de datos.
LOAD DATA INFILE '/home/xxx/http_logs/documents-181998.json' INTO TABLE http_logs COLUMNS TERMINATED BY '\n'; ... ... -
Agregue una columna:
Utilice una columna virtual para extraer el campo request del JSON y probar el índice de texto completo.
ALTER TABLE http_logs ADD COLUMN request varchar(1024) AS (CASE WHEN json_valid(logs) THEN (json_unquote(json_extract(logs, '$.request'))) ELSE NULL END); -
Cree un índice de columnstore:
El índice invertido de columnstore forma parte del índice de columnstore, por lo que debe crear primero el índice de columnstore.
ALTER TABLE http_logs comment 'columnar=1'; -
Cree un índice invertido:
El índice invertido de columnstore se crea al modificar el comentario de la columna mediante DDL. La instrucción DDL se completa en segundos y el índice invertido se construye de forma asíncrona en segundo plano.
ALTER TABLE http_logs modify COLUMN request varchar(1024) AS (CASE WHEN json_valid(logs) THEN (json_unquote(json_extract(logs, '$.request'))) ELSE NULL END) comment 'imci_fts(type=2 mode=1)'; -
Consulte el índice invertido:
Una vez creado el índice, ejecute las siguientes instrucciones para consultar NUM_PACKS y NEXT_PACK_ID, respectivamente. NUM_PACKS indica la cantidad de bloques de datos de columnstore, y NEXT_PACK_ID indica el número del bloque de datos hasta el cual se ha construido el índice invertido. Cuando ambos valores son cercanos, el índice invertido ya está construido.
SHOW imci indexes;
SHOW imci indexes fulltext;
Pruebas de rendimiento
Una vez construido el índice invertido, utilice la función MATCH para probar el rendimiento de recuperación de términos desde alta hasta baja frecuencia. La siguiente figura muestra la comparación de rendimiento de consulta entre LIKE, MATCH y MATCH_ANY de Doris sobre el mismo conjunto de datos.
Los resultados de las pruebas de un solo hilo con datos en caliente son los siguientes:
|
Consulta |
Término de alta frecuencia |
Término de frecuencia relativamente alta |
Término de frecuencia relativamente baja |
Término de baja frecuencia |
|
LIKE |
1 min 21.96 sec |
1 min 18.44 sec |
1 min 24.59 sec |
1 min 31.19 sec |
|
SIMD LIKE |
25.46 sec |
22.80 sec |
21.98 sec |
21.60 sec |
|
MATCH (biblioteca FTS propietaria) |
2.43 sec |
0.25 sec |
0.01 sec |
0.00 sec |
|
Doris MATCH_ANY (biblioteca CLucene) |
3.49 sec |
0.24 sec |
0.03 sec |
0.03 sec |
Como se muestra en la tabla anterior, MATCH ofrece una mejora de rendimiento significativa respecto a LIKE y prácticamente no se ve afectado por si los datos están en caliente o en frío.
Preguntas frecuentes
P1: ¿Qué ventajas tiene la búsqueda de texto completo de PolarDB IMCI frente al índice de texto completo integrado de una base de datos tradicional como MySQL InnoDB?
PolarDB IMCI presenta ventajas en rendimiento, funciones y escalabilidad:
Rendimiento: al basarse en almacenamiento por columnas y en un motor de ejecución vectorizado, y combinarse con algoritmos como FST y RBM, el rendimiento de las consultas supera al de los índices tradicionales de row store. Esto permite respuestas rápidas en escenarios de alta concurrencia y volúmenes masivos de datos.
Funciones: los tokenizers de chino integrados, como
jiebayik, así como el tokenizerjson, satisfacen los requisitos de escenarios de negocio complejos.Impacto en el rendimiento de escritura: los mecanismos optimizados de construcción y actualización de índices tienen un impacto de rendimiento mucho menor en escenarios de escritura de alta frecuencia (INSERT/UPDATE) que los índices de texto completo de las bases de datos tradicionales.
Escalabilidad horizontal: aprovecha la arquitectura de almacenamiento y cómputo desacoplados de PolarDB, lo que le otorga una buena escalabilidad horizontal.
P2: ¿Cómo elijo un tokenizer adecuado para mis datos de negocio?
Elija un tokenizer según su tipo de datos y sus requisitos de consulta:
Para texto en chino: utilice el tokenizer
jiebaoik. Ambos realizan una tokenización semántica que mejora la precisión de la recuperación en chino.Para texto en inglés o delimitado por símbolos: utilice el tokenizer
token. Divide el texto en espacios y signos de puntuación.Para coincidencias difusas o búsqueda de subcadenas arbitrarias: utilice el tokenizer
ngram. Divide el texto en frases de longitud fija (como bigramas y trigramas), lo que lo convierte en un buen reemplazo para las consultas ineficientes de tipoLIKE '%keyword%'.Para contenido específico en campos JSON: utilice el tokenizer
json. Actualmente admite la construcción de índices invertidos sobre los valores de una matriz JSON o las claves de un objeto JSON.
Si no sabe qué tokenizer es el más adecuado, utilice la función dbms_imci.fts_tokenize para previsualizar cómo procesan distintos tokenizers un texto de muestra y, después, elija la estrategia de tokenización que mejor se ajuste a las expectativas de su negocio.