Los datos de un índice columnstore se escriben físicamente en el orden de la clave primaria. En el caso de las filas actualizadas, se escriben al final del archivo. Por lo tanto, los datos suelen estar desordenados. Sin un orden definido, el pruner de In-Memory Column Index (IMCI) lee más bloques de datos de columna de los necesarios para resolver una consulta. Las claves de ordenamiento le permiten controlar el orden físico de estos bloques. Así, el pruner omite los bloques irrelevantes y reduce las operaciones de E/S.
Cómo funciona
Los datos de un índice columnstore se organizan en grupos de 64,000 filas cada uno. Dentro de cada grupo, las columnas se empaquetan en bloques de datos de columna. Cada bloque almacena los valores mínimo y máximo de sus datos como metadatos, que funcionan como un índice aproximado. Cuando se ejecuta una consulta, el pruner de IMCI clasifica todos los bloques de datos de columna en tres categorías según el predicado de la consulta y estos metadatos:
Relevantes: deben leerse.
Posiblemente relevantes: se leen como candidatos.
Irrelevantes: se omiten por completo.
El orden físico de los bloques de datos de columna determina la eficacia de esta eliminación. Para una consulta como SELECT * FROM t WHERE c >= 8, un conjunto de bloques desordenado obliga a cargarlos todos. Un conjunto ordenado permite que el pruner omita cualquier bloque cuyo valor máximo sea menor que 8.
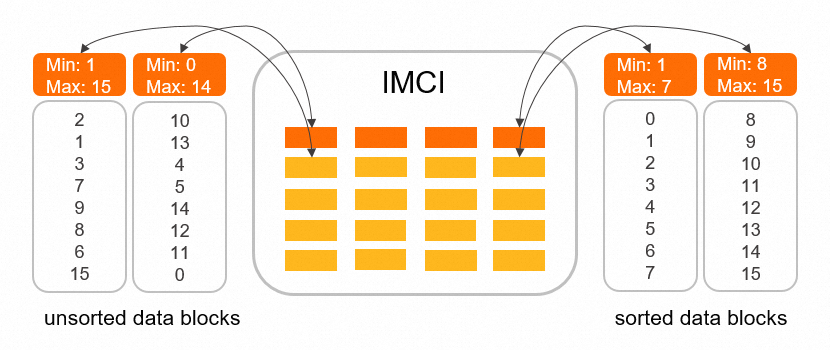
Cuándo usar claves de ordenamiento
Las claves de ordenamiento son más eficaces cuando:
La tabla es grande (cientos de gigabytes o más).
Las consultas son selectivas, es decir, filtran un subconjunto pequeño de filas en lugar de examinar toda la tabla.
Un porcentaje alto de las consultas utiliza las mismas columnas de filtro.
Las claves de ordenamiento resultan menos útiles cuando:
Las consultas examinan la mayor parte de la tabla sin filtros selectivos.
El throughput de escritura es más importante que el rendimiento de lectura. El ordenamiento incremental se ralentiza cuando la carga de trabajo de escritura es alta para liberar recursos destinados a dichas operaciones.
El tiempo de compilación está limitado. El ordenamiento aumenta significativamente el tiempo de compilación del índice (consulte Referencia de rendimiento).
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
-
Un clúster de PolarDB for MySQL Enterprise Edition en una de las siguientes versiones:
Ordenamiento de datos al crear un nuevo índice columnstore:
Versión
Revisión mínima
PolarDB for MySQL 8.0.1
8.0.1.1.32
PolarDB for MySQL 8.0.2
8.0.2.2.12
Ordenamiento incremental:
Versión
Revisión mínima
PolarDB for MySQL 8.0.1
8.0.1.1.39.1
PolarDB for MySQL 8.0.2
8.0.2.2.20.1
Para comprobar la versión de su clúster, consulte Query the version number.
Limitaciones
Las columnas BLOB, JSON y GEOMETRY no se pueden usar como claves de ordenamiento.
El ordenamiento incremental no admite columnas de enteros sin signo ni Decimal como claves de ordenamiento.
El ordenamiento incremental mantiene el orden únicamente con base en la primera columna de la clave de ordenamiento. Las columnas adicionales de la clave no se mantienen de forma incremental.
Cuando la carga de trabajo de escritura es alta, el ordenamiento incremental se ralentiza para liberar recursos destinados a las operaciones de escritura.
Elegir las columnas de la clave de ordenamiento
Elegir las columnas adecuadas determina qué tanta ventaja obtendrá del pruning. Siga estas recomendaciones:
Dé prioridad a las columnas que se usan en filtros de rango o de igualdad. Estas aprovechan mejor el pruning de mínimos y máximos. Para consultas de rango de fechas (por ejemplo,
WHERE order_date BETWEEN ... AND ...), la columna de fecha es una excelente candidata.Prefiera columnas de baja cardinalidad como clave principal. El pruner omite bloques de manera más eficaz cuando la primera columna de la clave de ordenamiento tiene una cardinalidad relativamente baja. Una columna con una cardinalidad muy alta (por ejemplo, un ID de usuario único) genera bloques con rangos de mínimos y máximos amplios, lo que reduce la eficacia de la omisión.
Agregue columnas de predicados de unión como claves secundarias si aún cuenta con capacidad disponible.
Limite la cantidad de columnas en la clave de ordenamiento. Agregar más columnas incrementa el tiempo de compilación, mientras que la ventaja del pruning disminuye progresivamente.
Configurar claves de ordenamiento
Paso 1: Habilitar el ordenamiento de datos
Establezca el parámetro imci_enable_pack_order_key en ON.
Este parámetro tiene el valor ON de forma predeterminada. Si no lo ha modificado, el ordenamiento ya está activo para los nuevos índices columnstore que se creen.
Para conocer las diferencias en los nombres de los parámetros entre la consola de PolarDB y una sesión de base de datos, consulte Parámetros.
Paso 2: Agregar claves de ordenamiento a la tabla
Ejecute la siguiente instrucción para especificar las columnas de la clave de ordenamiento:
ALTER TABLE table_name COMMENT 'columnar=1 order_key=column_name[,column_name]';|
Parámetro |
Descripción |
|
|
El nombre de la tabla. |
|
|
La columna que se usará como clave de ordenamiento. Separe varias columnas con comas. |
Ejemplo: ordene la tabla lineitem por fecha de recepción y modo de envío:
ALTER TABLE lineitem COMMENT='columnar=1 order_key=l_receiptdate,l_shipmode';Paso 3: Supervisar el progreso de compilación
Consulte INFORMATION_SCHEMA.IMCI_ASYNC_DDL_STATS para dar seguimiento al progreso de compilación:
SELECT * FROM INFORMATION_SCHEMA.IMCI_ASYNC_DDL_STATS;Para consultar la descripción de las columnas, vea View DDL execution speed and build progress for IMCIs.
Parámetros
Para habilitar o deshabilitar el ordenamiento y configurar el paralelismo, establezca los siguientes parámetros en su clúster.
Los nombres de los parámetros difieren entre la consola de PolarDB y una sesión de base de datos.
PolarDB console: Utilice los nombres de los parámetros con el prefijoloose_(por ejemplo,loose_imci_enable_pack_order_key). La consola agrega este prefijo para mantener la compatibilidad con el archivo de configuración de MySQL.
Sesión de base de datos (cliente SQL o línea de comandos): Quite el prefijoloose_y utilice el nombre base del parámetro (por ejemplo,imci_enable_pack_order_key).
| Parámetro | Descripción | Predeterminado |
|---|---|---|
loose_imci_enable_pack_order_key | Controla si se ordenan los datos al crear un nuevo índice columnstore. Establézcalo en ON para habilitarlo o en OFF para deshabilitarlo. | ON |
loose_imci_enable_pack_order_key_changed_rebuild | Controla si se recompila la tabla cuando cambia el orden de clasificación. Establézcalo en ON para exigir la recompilación o en OFF para omitirla. | OFF |
loose_imci_parallel_build_threads_per_table | Número de hilos utilizados para compilar el índice columnstore de una sola tabla. Valores válidos: de 1 a 128. | 8 |
Cómo se implementa el ordenamiento
Ordenamiento al crear un nuevo índice columnstore
El proceso de ordenamiento replica el algoritmo de ordenamiento DDL (Data Definition Language) de los índices secundarios. Se admiten los modos de un solo hilo y de varios hilos:
Un solo hilo: ordenamiento por mezcla bidireccional estándar.
Varios hilos: ordenamiento por mezcla externo de k vías con árbol perdedor (loser tree) y ordenamiento por muestreo opcional.
El proceso se ejecuta en cuatro pasadas:
Recorra los datos en el orden de la clave primaria, escriba las filas completas en los archivos de datos y agregue las columnas de la clave de ordenamiento al búfer de ordenamiento. Cada hilo escribe en su propio archivo de datos.
Cuando el búfer de ordenamiento se llena, ordene su contenido según la combinación de la clave de ordenamiento y vacíelo en los archivos de mezcla.
Ordene por mezcla los archivos de mezcla en pares y escriba el resultado ordenado en archivos temporales. Después, reemplace los archivos de mezcla con los archivos temporales.
Repita la pasada 3 hasta que todos los archivos de mezcla estén ordenados. Luego, lea cada registro de los archivos de mezcla, recupere la fila completa de los archivos de datos mediante el desplazamiento y añádala al índice columnstore.
Ordenamiento incremental
El ordenamiento incremental es progresivo. Mejora el orden de los bloques de datos con el tiempo, pero no garantiza un orden total. El proceso es el siguiente:
Agrupe todos los bloques de datos en pares y seleccione los grupos con mayor superposición en sus rangos de marcas de tiempo.
Ordene por mezcla cada par para generar dos nuevos bloques de datos ordenados.
Repita el proceso hasta que todos los bloques de datos estén ordenados.
El ordenamiento incremental mantiene el orden únicamente con base en la primera columna de la clave de ordenamiento.
Referencia de rendimiento
Tiempo de compilación frente a tiempo de consulta (TPC-H de 100 GB, tabla lineitem, 16 hilos)
El ordenamiento incrementa el tiempo de compilación, pero reduce significativamente el tiempo de consulta.
|
Conjunto de datos |
Tiempo de compilación |
Tiempo de consulta (TPC-H Q12) |
|
Desordenado |
6 minutos |
7.47 s |
|
Ordenado |
35 minutos |
1.25 s |
Condiciones de la prueba: caché LRU = 10 GB, memoria del ejecutor = 10 GB. Consulta TPC-H Q12:
SELECT
    l_shipmode,
    SUM(CASE
        WHEN o_orderpriority = '1-URGENT' OR o_orderpriority = '2-HIGH'
        THEN 1
        ELSE 0
        END) AS high_line_count,
    SUM(CASE
        WHEN o_orderpriority <> '1-URGENT' AND o_orderpriority <> '2-HIGH'
        THEN 1
        ELSE 0
        END) AS low_line_count
    FROM
        orders,
        lineitem
    WHERE
        o_orderkey = l_orderkey
        AND l_shipmode in ('MAIL', 'SHIP')
        AND l_commitdate < l_receiptdate
        AND l_shipdate < l_commitdate
        AND l_receiptdate >= date '1994-01-01'
        AND l_receiptdate < date '1994-01-01' + interval '1' year
    GROUP BY
        l_shipmode
    ORDER BY
        l_shipmode;
Claves de ordenamiento combinadas con particionamiento (TPC-H de 1 TB, 32 núcleos, 256 GB de memoria)
A continuación se comparan los resultados de los índices columnstore desordenados con los índices columnstore que incluyen particiones y claves de ordenamiento. Definiciones de tablas utilizadas:
CREATE TABLE region ( r_regionkey  BIGINT NOT NULL,
                      r_name       CHAR(25) NOT NULL,
                      r_comment    VARCHAR(152)) COMMENT 'COLUMNAR=1';

CREATE TABLE nation ( n_nationkey  BIGINT NOT NULL,
                      n_name       CHAR(25) NOT NULL,
                      n_regionkey  BIGINT NOT NULL,
                      n_comment    VARCHAR(152)) COMMENT 'COLUMNAR=1';

CREATE TABLE part ( p_partkey     BIGINT NOT NULL,
                    p_name        VARCHAR(55) NOT NULL,
                    p_mfgr        CHAR(25) NOT NULL,
                    p_brand       CHAR(10) NOT NULL,
                    p_type        VARCHAR(25) NOT NULL,
                    p_size        BIGINT NOT NULL,
                    p_container   CHAR(10) NOT NULL,
                    p_retailprice DECIMAL(15,2) NOT NULL,
                    p_comment     VARCHAR(23) NOT NULL) COMMENT 'COLUMNAR=1';

CREATE TABLE supplier ( s_suppkey     BIGINT NOT NULL,
                        s_name        CHAR(25) NOT NULL,
                        s_address     VARCHAR(40) NOT NULL,
                        s_nationkey   BIGINT NOT NULL,
                        s_phone       CHAR(15) NOT NULL,
                        s_acctbal     DECIMAL(15,2) NOT NULL,
                        s_comment     VARCHAR(101) NOT NULL) COMMENT 'COLUMNAR=1';

CREATE TABLE partsupp ( ps_partkey     BIGINT NOT NULL,
                        ps_suppkey     BIGINT NOT NULL,
                        ps_availqty    BIGINT NOT NULL,
                        ps_supplycost  DECIMAL(15,2)  NOT NULL,
                        ps_comment     VARCHAR(199) NOT NULL) COMMENT 'COLUMNAR=1';

CREATE TABLE customer ( c_custkey     BIGINT NOT NULL,
                        c_name        VARCHAR(25) NOT NULL,
                        c_address     VARCHAR(40) NOT NULL,
                        c_nationkey   BIGINT NOT NULL,
                        c_phone       CHAR(15) NOT NULL,
                        c_acctbal     DECIMAL(15,2)   NOT NULL,
                        c_mktsegment  CHAR(10) NOT NULL,
                        c_comment     VARCHAR(117) NOT NULL) COMMENT 'COLUMNAR=1';

CREATE TABLE orders ( o_orderkey       BIGINT NOT NULL,
                      o_custkey        BIGINT NOT NULL,
                      o_orderstatus    CHAR(1) NOT NULL,
                      o_totalprice     DECIMAL(15,2) NOT NULL,
                      o_orderdate      DATE NOT NULL,
                      o_orderpriority  CHAR(15) NOT NULL,
                      o_clerk          CHAR(15) NOT NULL,
                      o_shippriority   BIGINT NOT NULL,
                      o_comment        VARCHAR(79) NOT NULL) COMMENT 'COLUMNAR=1'
                      PARTITION BY RANGE (year(`o_orderdate`))
                      (PARTITION p0 VALUES LESS THAN (1992) ENGINE = InnoDB,
                       PARTITION p1 VALUES LESS THAN (1993) ENGINE = InnoDB,
                       PARTITION p2 VALUES LESS THAN (1994) ENGINE = InnoDB,
                       PARTITION p3 VALUES LESS THAN (1995) ENGINE = InnoDB,
                       PARTITION p4 VALUES LESS THAN (1996) ENGINE = InnoDB,
                       PARTITION p5 VALUES LESS THAN (1997) ENGINE = InnoDB,
                       PARTITION p6 VALUES LESS THAN (1998) ENGINE = InnoDB,
                       PARTITION p7 VALUES LESS THAN (1999) ENGINE = InnoDB);

CREATE TABLE lineitem ( l_orderkey       BIGINT NOT NULL,
                        l_partkey        BIGINT NOT NULL,
                        l_suppkey        BIGINT NOT NULL,
                        l_linenumber     BIGINT NOT NULL,
                        l_quantity       DECIMAL(15,2) NOT NULL,
                        l_extendedprice  DECIMAL(15,2) NOT NULL,
                        l_discount       DECIMAL(15,2) NOT NULL,
                        l_tax            DECIMAL(15,2) NOT NULL,
                        l_returnflag     CHAR(1) NOT NULL,
                        l_linestatus     CHAR(1) NOT NULL,
                        l_shipdate       DATE NOT NULL,
                        l_commitdate     DATE NOT NULL,
                        l_receiptdate    DATE NOT NULL,
                        l_shipinstruct   CHAR(25) NOT NULL,
                        l_shipmode       CHAR(10) NOT NULL,
                        l_comment        VARCHAR(44) NOT NULL) COMMENT 'COLUMNAR=1'
                        PARTITION BY RANGE (year(`l_shipdate`))
                        (PARTITION p0 VALUES LESS THAN (1992) ENGINE = InnoDB,
                         PARTITION p1 VALUES LESS THAN (1993) ENGINE = InnoDB,
                         PARTITION p2 VALUES LESS THAN (1994) ENGINE = InnoDB,
                         PARTITION p3 VALUES LESS THAN (1995) ENGINE = InnoDB,
                         PARTITION p4 VALUES LESS THAN (1996) ENGINE = InnoDB,
                         PARTITION p5 VALUES LESS THAN (1997) ENGINE = InnoDB,
                         PARTITION p6 VALUES LESS THAN (1998) ENGINE = InnoDB,
                         PARTITION p7 VALUES LESS THAN (1999) ENGINE = InnoDB);
Después de importar los datos, aplique las claves de ordenamiento mediante la sintaxis ALTER TABLE anterior:
ALTER TABLE customer COMMENT='COLUMNAR=1 order_key=c_mktsegment';
ALTER TABLE nation COMMENT='COLUMNAR=1 order_key=n_name';
ALTER TABLE part COMMENT='COLUMNAR=1 order_key=p_brand,p_container,p_type';
ALTER TABLE region COMMENT='COLUMNAR=1 order_key=r_name';
ALTER TABLE orders COMMENT='COLUMNAR=1 order_key=o_orderkey,o_custkey,o_orderdate';
ALTER TABLE lineitem COMMENT='COLUMNAR=1 order_key=l_orderkey,l_linenumber,l_receiptdate,l_shipdate,l_partkey';
Resultados del tiempo de consulta (en segundos):
|
Consulta |
Desordenado |
Ordenado con particiones y claves de ordenamiento |
|
Q3 |
71,951 |
36,566 |
|
Q4 |
46,679 |
32,015 |
|
Q6 |
34,652 |
4.4 |
|
Q7 |
74,749 |
34,166 |
|
Q12 |
86,742 |
28,586 |
|
Q14 |
50,248 |
12.56 |
|
Q15 |
79.22 |
21,113 |
|
Q20 |
51,746 |
10,178 |
|
Q21 |
216,942 |
148,459 |
Diferencias con el ordenamiento DDL de índices secundarios
El ordenamiento de índices columnstore difiere del ordenamiento DDL de índices secundarios en dos aspectos:
Flexibilidad de la clave de ordenamiento: el DDL de índices secundarios usa las columnas del índice como claves de ordenamiento. El ordenamiento de índices columnstore le permite especificar cualquier combinación de columnas como claves de ordenamiento, independientemente de la definición del índice.
Alcance de los datos: después de ordenar un índice columnstore, es necesario leer los datos completos de la fila. El DDL de índices secundarios solo almacena la porción correspondiente al índice (por ejemplo, únicamente el prefijo de una columna VARCHAR).