PolarDB for MySQL integra profundamente el kernel de la base de datos con la red RDMA para ofrecer la consistencia global (modo de alto rendimiento), también conocida como PolarDB-SCC (PolarDB-StronglyConsistentCluster). Esta función proporciona lecturas y escrituras de datos de alto rendimiento y, al mismo tiempo, garantiza la consistencia global de los datos. En comparación con las soluciones de consistencia eventual, la sobrecarga de rendimiento del clúster se mantiene por debajo del 10 % después de habilitar la consistencia global (modo de alto rendimiento). Este tema describe los límites de uso, los principios técnicos, el procedimiento para habilitarla y las comparativas de rendimiento de la consistencia global (modo de alto rendimiento).
Ámbito de aplicación
Para habilitar la consistencia global (modo de alto rendimiento), los clústeres de Enterprise Edition de PolarDB for MySQL deben tener una de a continuación versiones:
8.0.2 con una versión secundaria del kernel 8.0.2.2.19 o posterior.
8.0.1 con una versión secundaria del kernel 8.0.1.1.29 o posterior.
5.7 con una versión secundaria del kernel 5.7.1.0.26 o posterior.
Para obtener más información sobre cómo comprobar la versión del clúster, consulte Query the engine version.
Precauciones
La consistencia global (modo de alto rendimiento) se habilita de forma predeterminada en todos los nodos de solo lectura de Serverless clusters.
Los nodos de solo lectura de los clústeres secundarios en un Global Database Network (GDN) no son compatibles con la consistencia global (modo de alto rendimiento).
La consistencia global (modo de alto rendimiento) es compatible con Fast Query Cache. Si anteriormente se habilitó la optimización de seguimiento de modificaciones jerárquico de grano fino (MTT) de la consistencia global (modo de alto rendimiento) y usted habilita Fast Query Cache junto con esta función al mismo tiempo, la optimización MTT deja de ser válida.
Solución técnica de la consistencia global (modo de alto rendimiento)
PolarDB for MySQL La consistencia global (modo de alto rendimiento) se basa en PolarTrans, un sistema de transacciones basado en marcas de tiempo de nuevo diseño que reconstruye el enfoque tradicional de gestión de transacciones de MySQL nativo, el cual utiliza matrices de transacciones activas. Este sistema admite el escalado de transacciones distribuidas y mejora significativamente el rendimiento de un solo nodo.
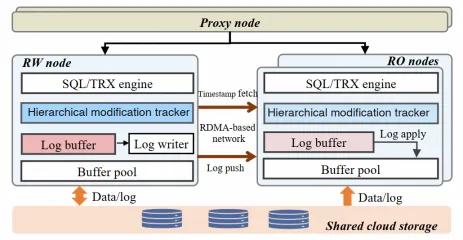
PolarDB A continuación se muestra cómo se implementa la consistencia global (modo de alto rendimiento). Esta función utiliza una red RDMA de alta velocidad para construir un mecanismo interactivo y multidimensional de sincronización de información entre nodos primario y secundario, que reemplaza la arquitectura tradicional de replicación de registros. El algoritmo de marca de tiempo lineal de Lamport reduce la cantidad de veces que un nodo de solo lectura (RO) obtiene marcas de tiempo y evita esperas innecesarias durante la reproducción de registros.
Marca de tiempo lineal de Lamport: para mejorar la eficiencia con la que un nodo RO obtiene la marca de tiempo de modificación más reciente, el sistema introduce el mecanismo de marca de tiempo lineal de Lamport. En el enfoque tradicional, un nodo RO debe obtener una marca de tiempo del nodo de lectura/escritura (RW) cada vez que procesa una solicitud. Incluso con una red rápida, esto genera una sobrecarga significativa bajo cargas altas. Con la marca de tiempo lineal de Lamport, un nodo RO puede almacenar localmente la marca de tiempo obtenida del nodo RW. Para una solicitud anterior a la marca de tiempo almacenada localmente, el nodo RO puede usar directamente la marca local sin necesidad de obtener otra del nodo RW. Este mecanismo reduce eficazmente la sobrecarga que implica recuperar marcas de tiempo con frecuencia bajo cargas altas y mejora el rendimiento del nodo RO.
Seguimiento de modificaciones jerárquico de grano fino: para mejorar el rendimiento del nodo RO, el nodo RW introduce un mecanismo de marcas de tiempo multinivel (global, de tabla y de página). Cuando un nodo RO procesa una solicitud, primero obtiene la marca de tiempo global. Si esta marca es posterior a aquella hasta la cual el nodo RO ha reproducido los registros, el nodo no entra inmediatamente en estado de espera. En su lugar, continúa comprobando las marcas de tiempo de la tabla y de la página a las que accede la solicitud. El nodo RO espera a que finalice la reproducción de registros únicamente si la marca de tiempo de la página accedida sigue sin cumplir la condición. Este mecanismo evita eficazmente algunas esperas innecesarias durante la reproducción de registros y mejora la velocidad de respuesta del nodo RO.
Envío de registros basado en RDMA: PolarDB La consistencia global (modo de alto rendimiento) utiliza una interfaz RDMA unilateral para enviar registros del nodo RW al nodo RO. Esto mejora considerablemente la velocidad de envío de registros y reduce la sobrecarga de CPU que genera dicho proceso.
Marca de tiempo lineal de Lamport
Para reducir la latencia y el consumo de ancho de banda de las solicitudes de lectura, un nodo RO puede utilizar el mecanismo de marca de tiempo lineal de Lamport. Cuando una solicitud llega a un nodo RO y otra solicitud ya obtuvo una marca de tiempo del nodo RW, el nodo RO puede reutilizar directamente esa marca. Esto evita solicitudes repetidas, garantiza una consistencia fuerte y mejora el rendimiento.
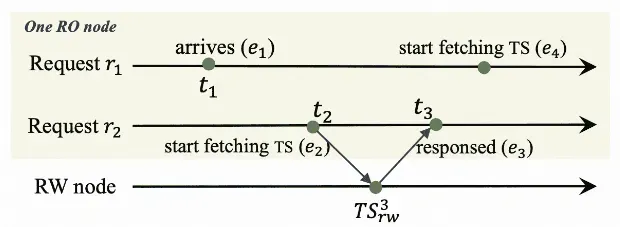
En la figura anterior, dos solicitudes de lectura concurrentes r1 y r2 llegan a un nodo RO. r2 envía una solicitud al nodo RW para obtener una marca de tiempo en t2 y, en t3, obtiene la marca de tiempo del nodo RW TS3rw. La relación entre estos eventos es e2TS3rwe3. r1 llega en t1. Asignar una marca de tiempo a cada evento en el nodo RO determina el orden de los distintos eventos dentro del mismo nodo. Si t1 es anterior a t2, la relación entre los eventos es e1e2TS3rwe3. En otras palabras, la marca de tiempo obtenida por r2 ya refleja todas las actualizaciones realizadas antes de que llegara r1. Por lo tanto, r1 puede usar directamente la marca de tiempo de r2 sin obtener una nueva. Con base en este principio, cada vez que un nodo RO obtiene una marca de tiempo del nodo RW, la guarda localmente y registra el momento en que se obtuvo. Si la hora de llegada de una solicitud es anterior al momento en que se obtuvo la marca de tiempo almacenada en la caché local, la solicitud puede usar directamente dicha marca.
Seguimiento de modificaciones jerárquico de grano fino
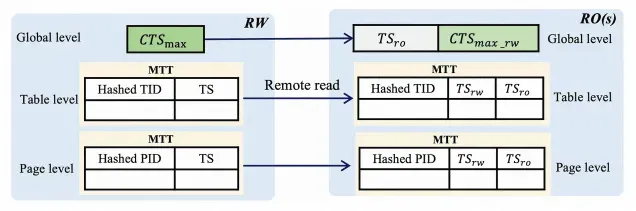
Para efectuar lecturas con consistencia fuerte, un nodo RO debe obtener primero la marca de tiempo de confirmación más reciente de la transacción actual en el nodo RW. Después, debe esperar a que sus registros se reproduzcan hasta esa marca antes de procesar una solicitud de lectura. Sin embargo, mientras el nodo RO espera la reproducción de registros, es posible que los datos requeridos por la solicitud actual ya estén actualizados y no se necesite ninguna espera. Para evitar estas esperas innecesarias, PolarDB utiliza un seguimiento de modificaciones de grano más fino en la consistencia global (modo de alto rendimiento). El nodo RW mantiene tres niveles de información de modificación: la marca de tiempo de modificación más reciente global, la marca de tiempo a nivel de tabla y la marca de tiempo a nivel de página.
Al procesar una solicitud de lectura, un nodo RO obtiene primero la marca de tiempo global para determinar la consistencia de los datos. Si esta marca no cumple la condición, el nodo RO obtiene además la marca de tiempo local de la tabla de destino para una verificación más precisa. Si la condición aún no se cumple, el nodo RO continúa comprobando la marca de tiempo de la página de destino para lograr una determinación más exacta. El nodo RO debe esperar la reproducción de registros únicamente cuando la marca de tiempo de la página sigue siendo posterior a la marca hasta la cual se han reproducido sus registros. Esto garantiza que el nodo RO lea los datos más recientes.
En el nodo RW, los tres niveles de marcas de tiempo se almacenan en una tabla hash en memoria para reducir el consumo de recursos. Para optimizar aún más el uso de memoria, las marcas de tiempo de varias tablas o páginas pueden asignarse a la misma entrada de la tabla hash. Para garantizar la consistencia, solo una marca de tiempo mayor puede reemplazar a una menor. Este diseño asegura que la consistencia no se vea comprometida incluso si un nodo RO obtiene una marca de tiempo mayor. A continuación se muestra la implementación, donde TID y PID indican el identificador de la tabla y el identificador de la página, respectivamente. La marca de tiempo que obtiene un nodo RO se almacena en la caché local según el diseño de marca de tiempo lineal de Lamport, de modo que otras solicitudes elegibles puedan utilizarla.
Envío de registros basado en RDMA
En PolarDB, la consistencia global (modo de alto rendimiento) hace que el nodo RW escriba registros de forma remota en la caché del nodo RO mediante RDMA unilateral. Este proceso no requiere la CPU del nodo RO y presenta una latencia baja. A continuación se muestra la implementación. Tanto el nodo RO como el nodo RW mantienen búferes de registros del mismo tamaño. Un hilo en segundo plano del nodo RW escribe el búfer de registros del nodo RW en el búfer del nodo RO a través de RDMA. El nodo RO lee su búfer de registros local en lugar de leer archivos, lo que acelera la sincronización de la replicación.
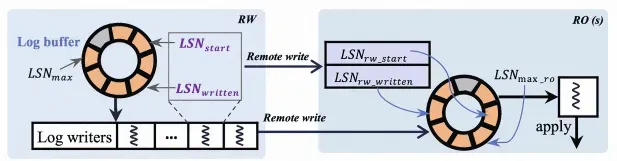
Para obtener más información sobre el envío de registros basado en RDMA, consulte RDMA-based log shipment.
Habilitar la consistencia global (modo de alto rendimiento)
Inicie sesión en la consola de PolarDB. En la página Basic Information del clúster de destino, dentro de la sección Database Connections, seleccione la dirección de conexión para la que desea habilitar la consistencia global (modo de alto rendimiento). A continuación, haga clic en Configure, establezca Consistency Level en Global Consistency (Strong) y configure Global Consistency Mode en High-performance Mode. Para obtener más información sobre el procedimiento, consulte Configure the database proxy.
La consistencia global (modo de alto rendimiento) surte efecto en todas las direcciones de un clúster al mismo tiempo. Si la habilita para una dirección, se habilitará automáticamente para todas las demás direcciones del clúster.
Comparativa de rendimiento
-
Entorno de prueba
Un clúster de PolarDB for MySQL 8.0 de edición Cluster Edition con 8 núcleos y 32 GB de memoria.
-
Herramienta de prueba
Sysbench
-
Volumen de datos de prueba
25 tablas, cada una con 250 000 filas.
-
Resultados y descripción de la prueba
A continuación se muestra la comparativa de rendimiento de lectura y escritura mixtas de un clúster con consistencia global (modo de alto rendimiento). Descripción del gráfico:
Eje vertical (qps): resultado de la prueba de Sysbench.
Eje horizontal (threads): número de hilos simultáneos de Sysbench utilizados durante la prueba.
RW: todas las solicitudes de lectura y escritura se envían al nodo RW, bajo el supuesto de que el nodo RO no puede proporcionar lecturas con consistencia global.
Consistencia global: función de consistencia global proporcionada por el proxy.
Consistencia global (modo de alto rendimiento): configuración del proxy que habilita la consistencia global (modo de alto rendimiento) proporcionada por el kernel y que, en última instancia, configura la consistencia eventual.
Consistencia eventual: el proxy se configura para lecturas con consistencia eventual y se deshabilita la consistencia global (modo de alto rendimiento) proporcionada por el kernel.
En el escenario
sysbench oltp_read_write, la sobrecarga general de rendimiento del clúster con consistencia global (modo de alto rendimiento) se mantiene por debajo del 10 % en comparación con la consistencia eventual.