La función de failover con réplica activa en PolarDB mejora la velocidad del failover y preserva el estado de las transacciones. Este tema describe cómo funciona esta función.
Contexto
La evolución de la alta disponibilidad de ApsaraDB se divide en las siguientes fases: alta disponibilidad (HA) primaria/secundaria, HA con memoria compartida y HA nativa de la nube de PolarDB. La HA primaria/secundaria presenta problemas de latencia de replicación en casos como DDL y transacciones grandes, ya que utiliza replicación de registros binarios. La HA de PolarDB resuelve este problema mediante replicación física y mejora la escalabilidad con el almacenamiento compartido de PolarStore. Sin embargo, siguen ocurriendo interrupciones de conexión y reversiones de transacciones en escenarios como las actualizaciones de versión. Además, el cliente de la aplicación reporta una gran cantidad de errores de solicitud. La función de failover con réplica activa se introdujo para resolver problemas relacionados con actualizaciones de versiones menores, escalado y recuperación ante desastres. Esta función también es necesaria para la evolución de PolarDB hacia un modelo serverless.
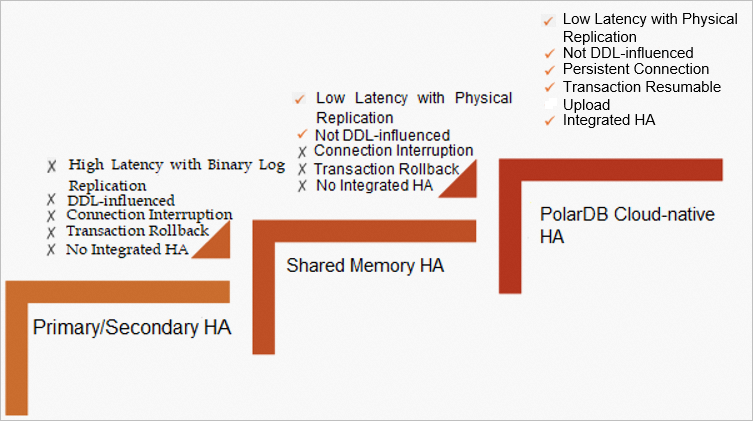 La función de failover con réplica activa de PolarDB optimiza tres aspectos: detección de fallas, velocidad de failover y experiencia. Distingue los cambios programados, como modificaciones de configuración del clúster y actualizaciones de versiones menores, de los eventos de failover. Esta función combina varias técnicas para resolver los desafíos de los clientes:
Voting Disk Service (VDS): VDS es un módulo de alta disponibilidad basado en la arquitectura de disco compartido que permite gestionar de forma autónoma los nodos del clúster. Reduce considerablemente el tiempo necesario para detectar fallas y seleccionar el nodo principal.
Precarga global: gracias a la precarga global, los nodos de réplica activa pueden precargar varios módulos dentro del motor de almacenamiento, lo que reduce el tiempo requerido para el failover.
PolarProxy admite conexiones persistentes y preservación del estado de las transacciones. Una vez habilitadas estas funciones, PolarDB ejecuta operaciones activas de operación y mantenimiento sin interrumpir sus servicios durante cambios de configuración del clúster o actualizaciones de versiones menores.
Ámbito de aplicación
La función de failover con réplica activa es compatible con las siguientes versiones de PolarDB for MySQL:
-
**Engine version**:
MySQL 5.6. La versión de revisión debe ser 5.6.1.0.35 o posterior.
MySQL 5.7. La versión de revisión debe ser 5.7.1.0.24 o posterior.
MySQL 8.0.1. La versión de revisión debe ser 8.0.1.1.29 o posterior.
MySQL 8.0.2. La versión de revisión debe ser 8.0.2.2.12 o posterior.
PolarProxy version: se requiere la versión 2.8.3 o posterior.
Si su clúster es de Standard Edition y necesita esta función, submit a ticket para solicitar asistencia.
Notas de uso
Si la réplica activa no está habilitada en un nodo de solo lectura, puede producirse una interrupción transitoria de entre 20 y 30 segundos durante un failover primario/secundario. Compruebe que su aplicación admita la reconexión automática. Si la réplica activa está habilitada, el failover se completa en un lapso de 1 a 5 segundos.
El nodo de réplica activa debe tener las mismas especificaciones que el nodo principal.
-
El módulo Voting Disk de la función de alta disponibilidad utilizada por el failover con réplica activa tiene cierta exclusión mutua con la función IMCI (In-Memory Column Index) en algunas versiones del kernel. Los detalles son los siguientes:
En clústeres con una **kernel version 8.0.1.1.43 o posterior, o 8.0.2.2.24 o posterior**, la función IMCI es totalmente compatible con el failover con réplica activa.
-
En clústeres con una **kernel version 8.0.1.1.42 u 8.0.2.2.23**:
Si el clúster ya cuenta con un nodo de solo lectura con el failover con réplica activa habilitado, puede agregar un nodo IMCI de solo lectura al clúster.
Si el clúster ya cuenta con un nodo IMCI de solo lectura, no puede habilitar el failover con réplica activa en ningún nodo de solo lectura del clúster.
-
En clústeres con una **kernel version anterior a 8.0.1.1.42 u 8.0.2.2.23**, la función IMCI y el failover con réplica activa son mutuamente excluyentes:
-
Si el clúster ya cuenta con un nodo de solo lectura con el failover con réplica activa habilitado, no puede agregar un nodo IMCI de solo lectura al clúster.
NotaSi desea agregar un nodo IMCI de solo lectura al clúster, puede contact us para deshabilitar el módulo de alta disponibilidad Voting Disk del failover con réplica activa. Una vez deshabilitado el módulo, podrá agregar el nodo IMCI de solo lectura. Tenga en cuenta que todos los nodos se reinician automáticamente durante este proceso.
Si el clúster ya cuenta con un nodo IMCI de solo lectura, no puede habilitar el failover con réplica activa en ningún nodo de solo lectura del clúster.
-
NotaSi IMCI y la réplica activa son mutuamente excluyentes y desea habilitar el failover con réplica activa para el clúster, elimine primero el nodo IMCI de solo lectura existente.
Cómo funciona
A continuación se describen las tecnologías principales utilizadas para implementar el failover con réplica activa en PolarDB:
-
New high availability module: VDS
Una vez habilitada la función de failover con réplica activa, PolarDB inicia VDS. Con la arquitectura de disco compartido de PolarDB, VDS proporciona gestión autónoma, detección de fallas y selección del nodo principal para los nodos del clúster.
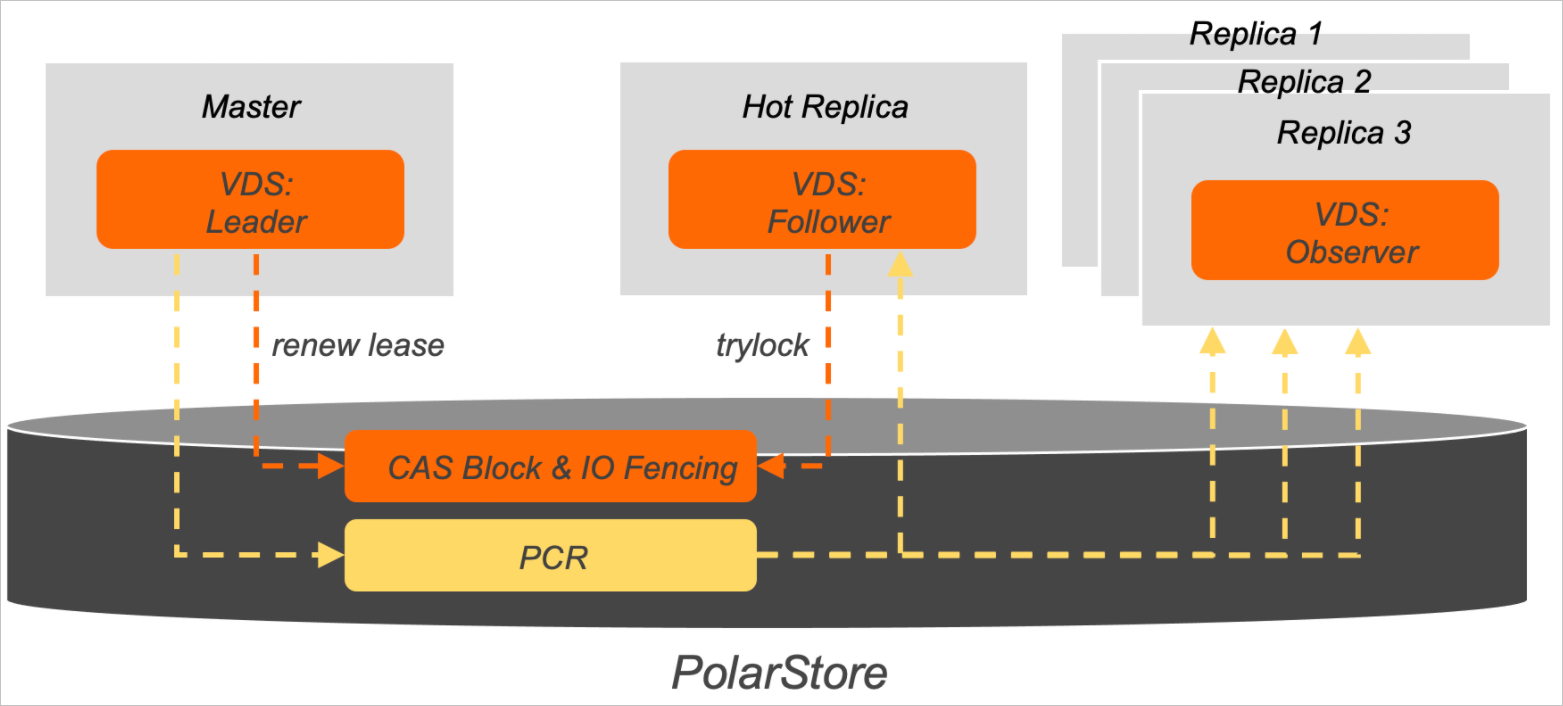 Detalles sobre la arquitectura de VDS:
Cada nodo de cómputo en VDS tiene un hilo independiente. Los hilos de VDS se clasifican en tres categorías: Leader, Follower y Observer. En un clúster de PolarDB, los hilos Leader se ejecutan en el nodo principal, los hilos Follower en el nodo de réplica activa y los hilos Observer en los nodos de solo lectura. Un clúster de PolarDB puede contener un hilo leader, un hilo follower y varios hilos observer.
-
VDS crea dos módulos de datos en PolarStore: Compare-and-Swap (CAS) Block y Polar Cluster Registry (PCR).
CAS Block es un bloque de datos atómico que admite operaciones CAS proporcionadas por PolarStore. CAS permite utilizar bloqueos distribuidos basados en concesiones (lease) en VDS y registra metadatos como el titular del bloqueo y el tiempo de concesión. El nodo principal y el nodo de réplica activa de un clúster de PolarDB usan semánticas de adquisición y renovación de bloqueos para detectar fallas y seleccionar el nodo principal.
PCR almacena la información de gestión de nodos de PolarDB, como el estado de topología de un clúster. Los hilos Leader tienen el permiso para escribir datos en PCR, mientras que los hilos Follower y Observer solo tienen el permiso para leer datos de PCR. Cuando un hilo Follower se designa como hilo Leader, el hilo Leader original se convierte en un hilo Follower. Solo el hilo Leader más reciente tiene el permiso para escribir datos en PCR. PCR también reconstruye la topología.
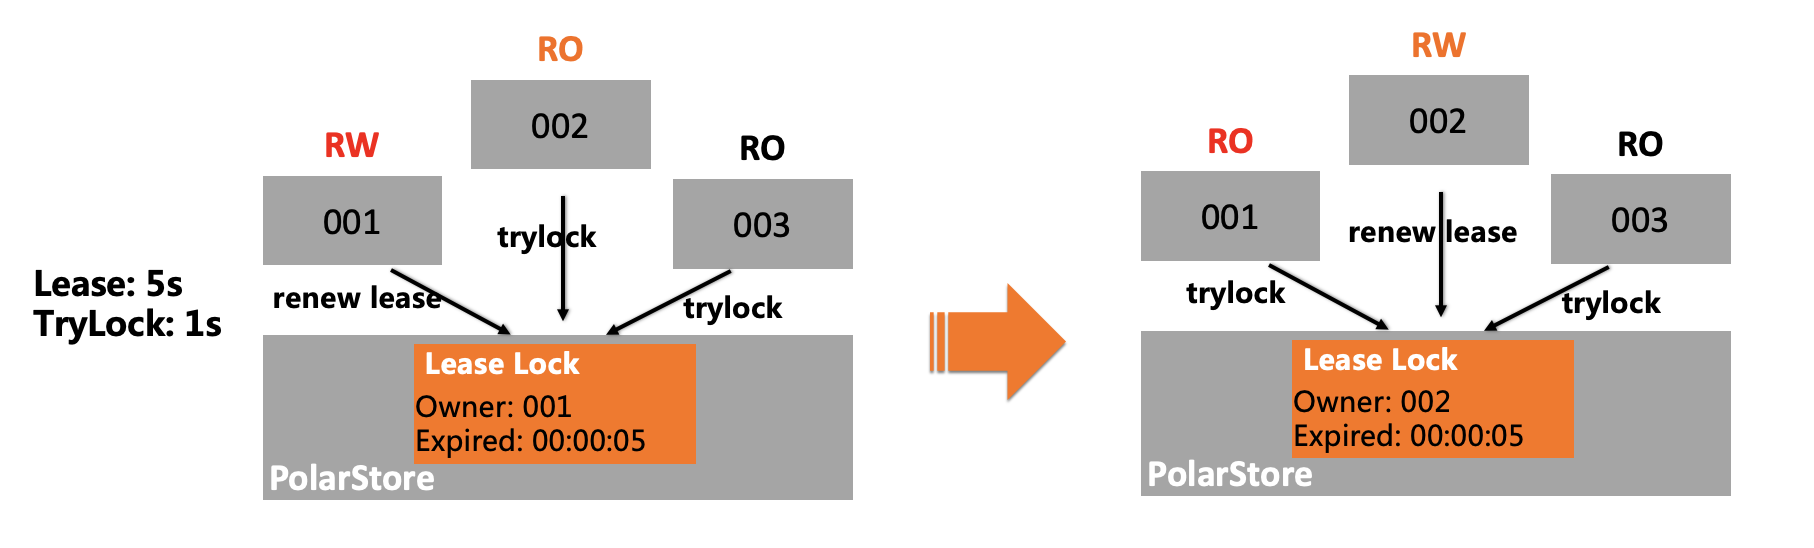
Por lo general, el nodo principal proporciona servicios de lectura y escritura, y el hilo Leader correspondiente renueva periódicamente su bloqueo en VDS. Cuando el nodo principal deja de estar disponible, un nodo de réplica activa toma el control. El proceso se describe a continuación:
Cuando expira la concesión del nodo principal, un hilo Follower se bloquea y se elige como el nuevo hilo Leader. En ese momento, el nodo de réplica activa se convierte en el nodo principal.
Cuando el nodo principal original se recupera, no logra adquirir un bloqueo. Entonces, el nodo principal original se degrada a nodo de réplica activa.
Una vez finalizado el proceso de selección del nodo principal, PCR transmite la nueva información de topología a todos los hilos Observer. De esta manera, los nodos de solo lectura pueden conectarse automáticamente al nuevo nodo principal y restaurar los vínculos de sincronización para los números de secuencia de registro (LSN) y los registros binarios.
-
Global prefetching system
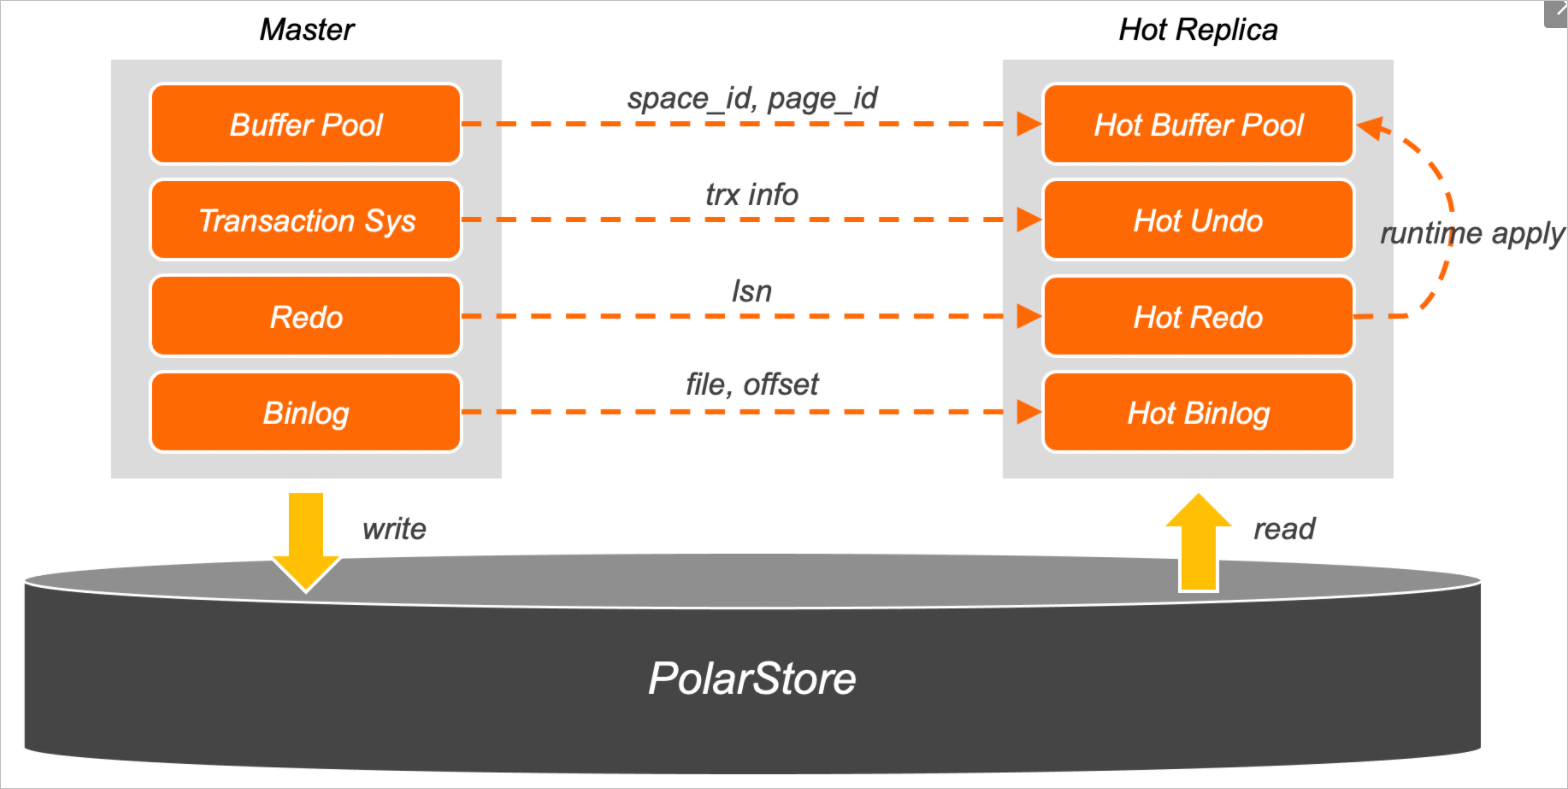
En comparación con los nodos de solo lectura comunes, el nodo en espera activa es un tipo especial de nodo de solo lectura que reserva una pequeña porción de recursos de CPU y memoria para optimizar la velocidad de cambio. El sistema de precarga global es el módulo más importante en el failover con réplica activa. Sincroniza los metadatos del nodo principal en tiempo real y precarga datos clave en la memoria para mejorar la velocidad de failover. El sistema de precarga global consta de cuatro módulos: Buffer Pool, Undo, Redo y Binlog.
-
Buffer Pool
El módulo Buffer Pool supervisa en tiempo real la lista vinculada que implementa el algoritmo Least Recently Used (LRU) en el pool de búferes del nodo principal, y envía los datos relevantes al nodo de réplica activa. El nodo de réplica activa selecciona las páginas con acceso frecuente y las precarga en la memoria para evitar la degradación del rendimiento causada por una caída significativa en la tasa de aciertos del pool de búferes cuando un nodo de solo lectura se elige como nodo principal.
-
Undo
El módulo Undo precarga datos en el sistema de transacciones. Durante el failover, PolarDB busca las transacciones pendientes en las páginas undo y revierte dichas transacciones. Los nodos de solo lectura procesan únicamente solicitudes de consultas analíticas a gran escala y no acceden a las transacciones no confirmadas del nodo principal. Esto genera tiempos de espera de E/S prolongados para las páginas undo. La función de failover con réplica activa precarga las páginas undo y las reproduce hasta la versión más reciente mediante Runtime Apply para reducir el tiempo de recuperación del sistema de transacciones.
-
Redo
El módulo Redo almacena en caché los registros redo de los nodos de réplica activa y de solo lectura en la tabla hash redo de la memoria en tiempo real.
-
Binlog
Una vez habilitados los registros binarios, las transacciones InnoDB en estado Prepare deciden si confirman o revierten una transacción según dichos registros. Cuando se ejecuta una gran cantidad de transacciones, el sistema puede tardar varios segundos o minutos en leer y analizar sintácticamente todos los registros binarios. Los nodos de réplica activa utilizan hilos en segundo plano para almacenar de forma asíncrona los registros binarios más recientes en la caché de E/S y analizarlos previamente, con el fin de mejorar la velocidad de failover.
PolarDB admite la conversión dinámica entre nodos de réplica activa y nodos en espera comunes. En escenarios reales, puede mantener habilitado un nodo de réplica activa de forma permanente o habilitar la función de réplica activa solo por un breve periodo durante cambios de configuración o actualizaciones. PolarDB le permite configurar el nodo principal y los nodos de solo lectura con distintas especificaciones. Sin embargo, como mínimo un nodo de solo lectura debe usar las mismas especificaciones que el nodo principal para la recuperación ante desastres. Se recomienda configurar este nodo como nodo de réplica activa.
-
-
Persistent connections and transaction status preservation
No obstante, el failover o la actualización en caliente pueden afectar su servicio y causar problemas como conexiones transitorias, fallas de conexión y reversión de transacciones existentes. Esto aumenta la complejidad y los riesgos del desarrollo de aplicaciones.
PolarDB admite la función Persistent connections. Las conexiones persistentes se implementan de manera que PolarProxy actúa como puente de conexión entre su aplicación y PolarDB. Cuando la base de datos ejecuta un failover primario/secundario, PolarProxy conecta los nodos de la base de datos con su aplicación y restaura la sesión previa, incluidas las variables de sistema originales, las variables de usuario, la codificación del juego de caracteres y otra información.
La función de conexiones persistentes solo se aplica a conexiones inactivas. Si la sesión actual tiene una transacción en ejecución justo en el momento del cambio de nodo, PolarProxy no puede recuperar el contexto de la transacción original desde PolarDB. El nuevo nodo principal revertirá las transacciones no confirmadas y liberará los bloqueos de fila asociados a ellas. En este caso, no es posible mantener las conexiones persistentes. Para resolver este problema, PolarDB proporciona la función de preservación del estado de las transacciones. Esta función, junto con las conexiones persistentes, permite un failover rápido que ofrece alta disponibilidad sin interrumpir sus servicios.
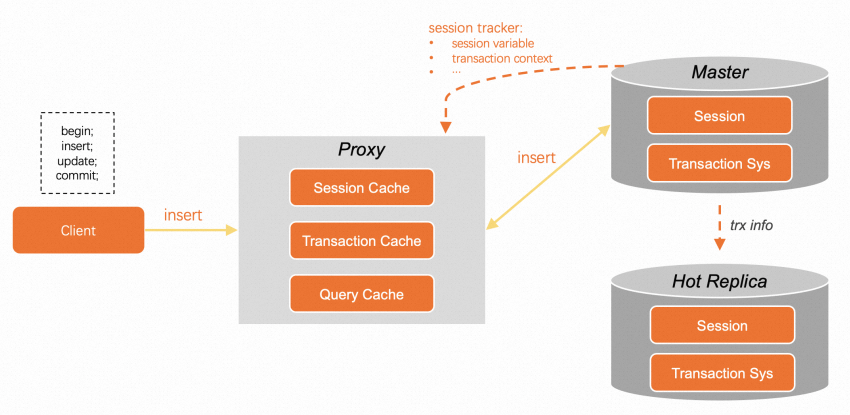
A diferencia de la replicación lógica basada en registros binarios, la arquitectura de replicación física permite a PolarDB reconstruir en el nodo de réplica activa las mismas transacciones que existen en el nodo principal.
Por ejemplo, supongamos que el proceso para confirmar una transacción en una aplicación es BEGIN > INSERT > UPDATE > COMMIT y que la función de preservación del estado de las transacciones está habilitada. Después de que la transacción comienza a ejecutarse, PolarProxy almacena en caché la instrucción SQL ejecutada más recientemente mientras la reenvía al nodo principal. Una vez ejecutada la instrucción INSERT en el nodo principal, PolarDB guarda automáticamente el punto de guardado (savepoint) de la última instrucción como parte de la información de la transacción. El rastreador de sesiones devuelve la información actual de la sesión y de la transacción a PolarProxy. Luego, PolarProxy guarda temporalmente los datos en la caché interna. La información de la sesión, como los juegos de caracteres y las variables de usuario, se usa para mantener las conexiones. La información de la transacción, como trx_id y undo_no, se usa para preservar el estado de la transacción. Además, la información de la transacción se sincroniza continuamente con la réplica activa a través de un vínculo RDMA independiente. Si los registros binarios están habilitados para la base de datos de backend, la caché local de registros binarios correspondiente a cada transacción se sincroniza con el nodo de réplica activa.
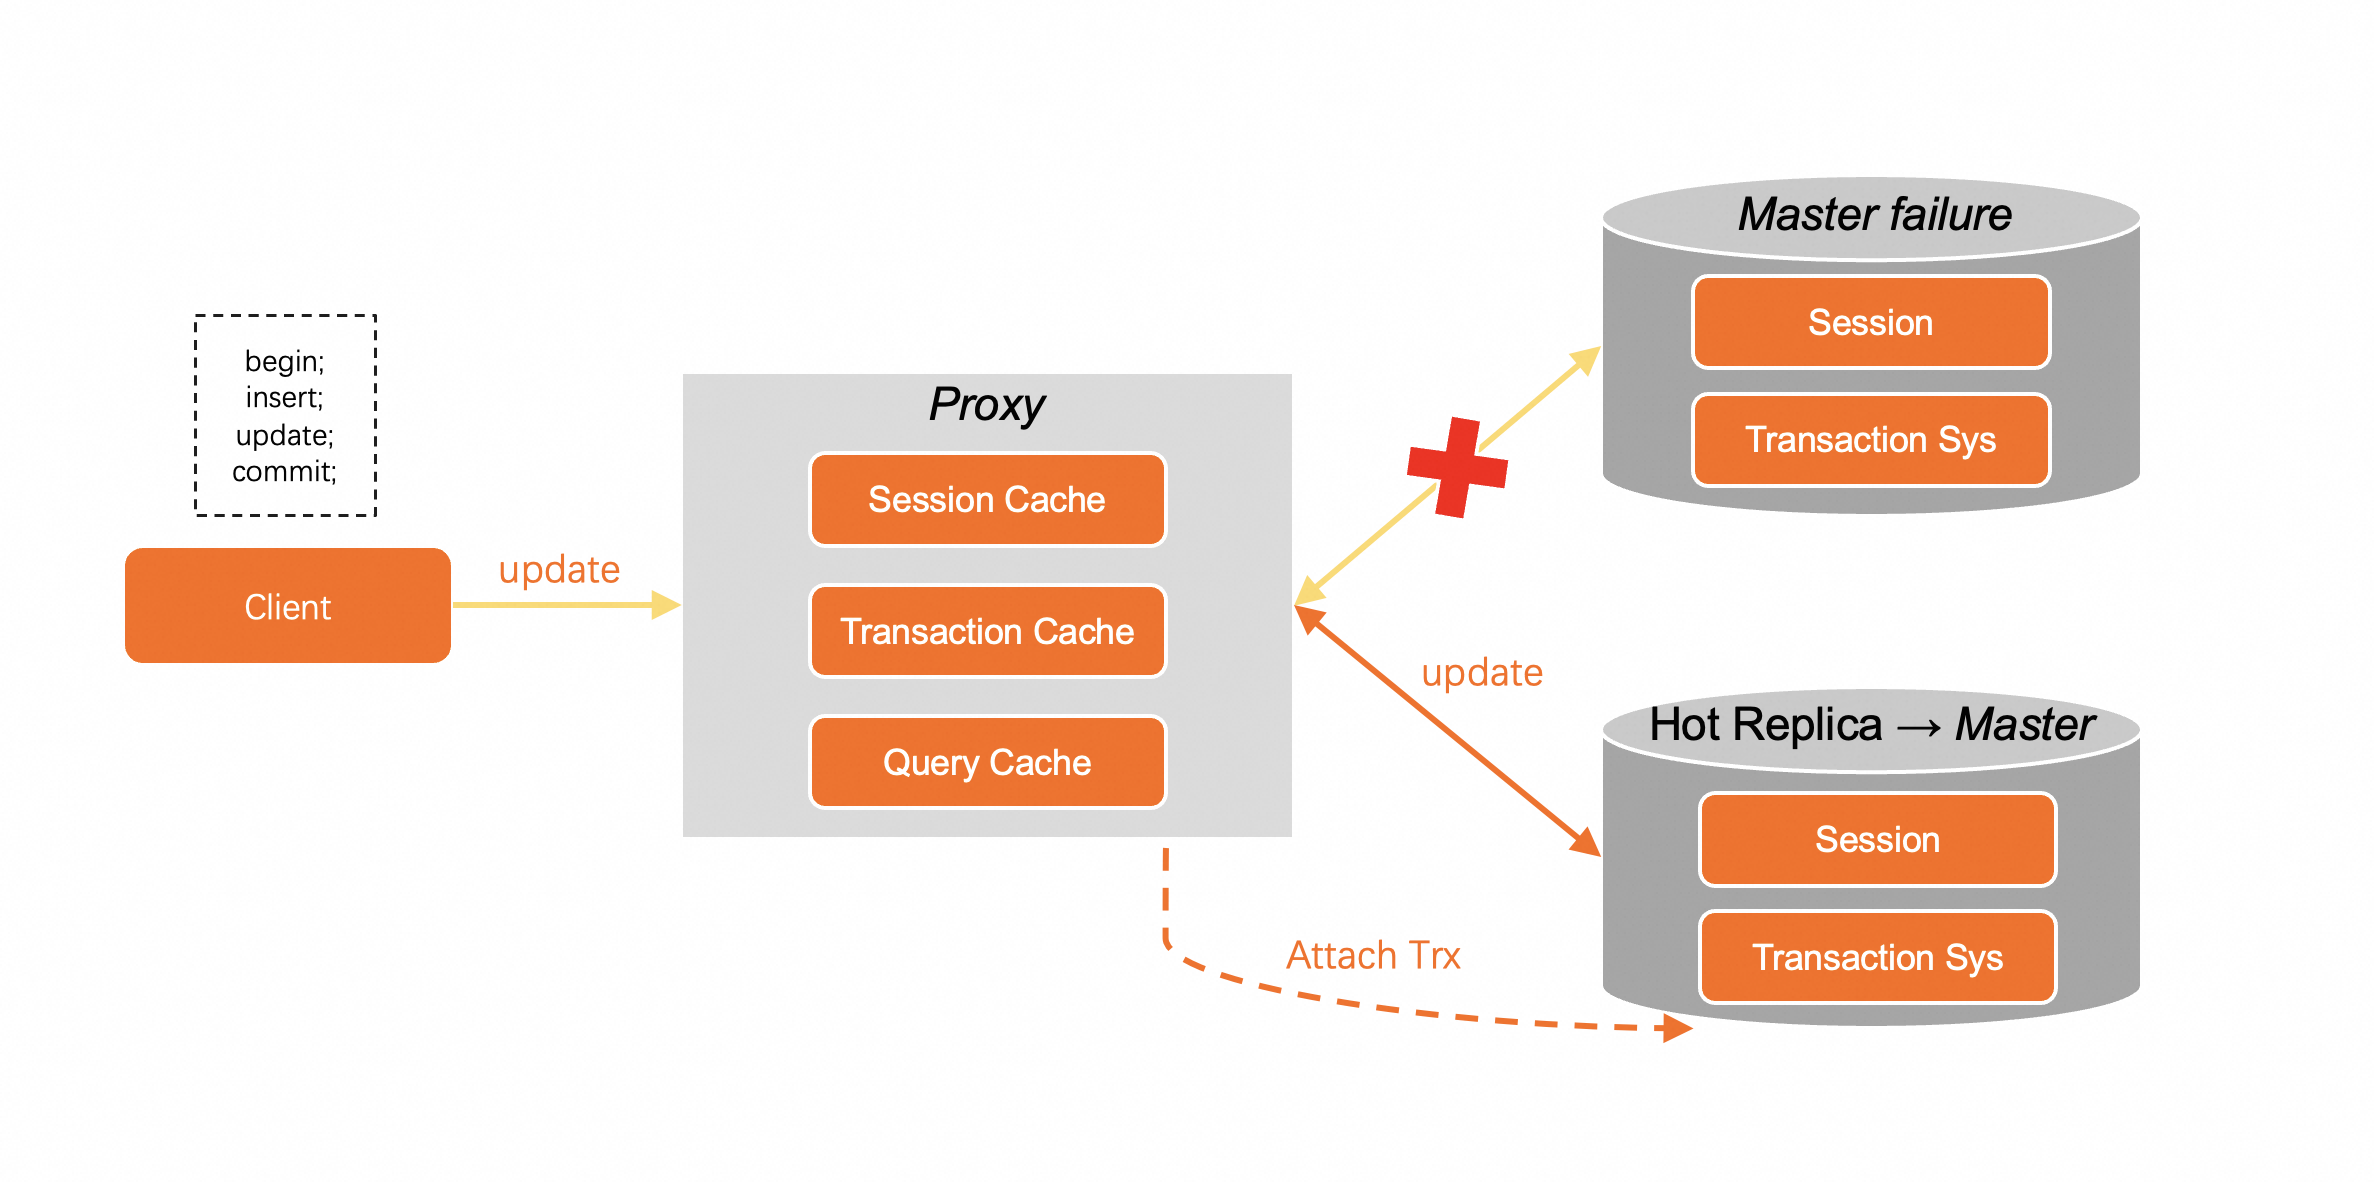
Por ejemplo, supongamos que el nodo principal deja de estar disponible mientras se ejecuta la instrucción UPDATE en PolarDB. PolarProxy no transmite de inmediato el error de la capa subyacente a la conexión de la aplicación, sino que retiene la solicitud durante un periodo determinado. Después del failover, el nuevo nodo principal puede construir todas las transacciones no confirmadas a partir de los registros redo y esperar de forma asíncrona por las transacciones no confirmadas sin revertirlas. Cuando PolarProxy detecta el mensaje de failover exitoso, utiliza la información de sesión y de transacción almacenada en su caché para reconstruir la transacción mediante la llamada a la API Attach Trx de PolarDB. PolarDB determina si la información de la transacción es válida según la información de PolarProxy. Si la información es válida, se vincula a la conexión y se revierte al punto de guardado del undo_no correspondiente a la última instrucción (la instrucción UPDATE).
Una vez reconstruida la transacción, PolarProxy puede reenviar la última instrucción UPDATE que no se pudo ejecutar al nuevo nodo principal desde la caché de instrucciones SQL. Durante el proceso de failover, su aplicación no reporta errores de conexión ni de transacción. La única diferencia es que la instrucción UPDATE puede tardar más de lo normal.
La función de failover con réplica activa optimiza la detección de fallas, la velocidad de failover y la experiencia en PolarDB mediante la combinación de VDS, el sistema de precarga global, las conexiones persistentes y la preservación del estado de las transacciones. Puede actualizar el clúster en cualquier momento sin preocuparse por interrupciones de conexión o de transacciones, y aprovechar la verdadera elasticidad de las bases de datos nativas de la nube.