PolarDB ofrece la función de optimización de la replicación física de DDL (Data Definition Language). Esta función optimiza por completo la ruta crítica para escribir registros físicos en el nodo principal y aplicarlos en los nodos de solo lectura. Además, reduce de forma significativa el tiempo de ejecución de las operaciones DDL en el nodo principal y el retraso de replicación de registros físicos al analizar sintácticamente las instrucciones DDL en los nodos de solo lectura. En este tema se describe cómo usar la función de optimización de la replicación física de DDL.
Requisitos previos
Los clústeres de PolarDB deben ejecutar una de a continuación versiones. Puede Query the engine version para comprobar la versión de su clúster:
PolarDB for MySQL 8.0.1 con una versión de revisión 8.0.1.1.10 o posterior.
PolarDB for MySQL 5.7 con una versión de revisión 5.7.1.0.10 o posterior.
Límites
La función de optimización de la replicación física de DDL en paralelo solo es compatible con operaciones DDL que crean claves primarias o índices secundarios. No admite índices de texto completo ni índices espaciales.
Esta optimización no es necesaria para las operaciones DDL que solo modifican metadatos, como rename, ya que estas operaciones se ejecutan rápidamente de forma predeterminada.
Esta función de optimización no es compatible con PolarDB for MySQL 8.0.2 ni 5.6.
Contexto
PolarDB utiliza una arquitectura de separación entre almacenamiento y cómputo, de modo que el nodo principal y los nodos de solo lectura comparten los mismos datos almacenados. Esto reduce los costos de almacenamiento y mejora la disponibilidad y confiabilidad del clúster. Para implementar esta arquitectura, PolarDB emplea tecnología de replicación física. De esta manera, garantiza la coherencia de los datos entre el nodo principal y los nodos de solo lectura dentro de la arquitectura de almacenamiento compartido, y reduce la sobrecarga de E/S generada por las operaciones fsync del registro binario (Binlog).
InnoDB usa árboles B para mantener los índices. Sin embargo, la mayoría de las operaciones DDL lentas, como agregar una clave primaria, crear un índice secundario o ejecutar optimize table, suelen requerir la reconstrucción o creación de índices de árbol B. Esto genera un gran volumen de registros físicos. Las operaciones sobre estos registros suelen ubicarse en la ruta crítica de ejecución de las instrucciones DDL, lo que incrementa su tiempo de ejecución. Además, la replicación física exige que los nodos de solo lectura analicen sintácticamente y apliquen los nuevos registros físicos generados. El alto volumen de registros físicos que producen las operaciones DDL puede afectar gravemente la sincronización de registros en los nodos de solo lectura e incluso dejarlos no disponibles.
Para resolver estos problemas, PolarDB ofrece la función de optimización de la replicación física de DDL. Esta función optimiza por completo la ruta crítica para escribir registros físicos en el nodo principal y aplicarlos en los nodos de solo lectura. Permite reducir hasta un 20.6 % el tiempo de ejecución de una operación DDL que crea una clave primaria en el nodo principal. También disminuye el retraso de replicación al analizar sintácticamente las instrucciones DDL en los nodos de solo lectura a aproximadamente el 0.4 % del tiempo original.
Uso
Establezca a continuación parámetro para habilitar la función de optimización de la replicación física de DDL.
Parámetro | Nivel | Descripción |
innodb_bulk_load_page_grained_redo_enable | Global | El interruptor de la función de optimización de la replicación física de DDL. Valores válidos:
|
Prueba de rendimiento
-
Preparación de la prueba
-
Entorno de prueba
Clúster de PolarDB for MySQL 8.0 con un nodo principal y un nodo de solo lectura. El clúster utiliza la especificación de 16 núcleos y 128 GB.
El clúster cuenta con 50 TB de espacio de almacenamiento.
-
Esquema de la tabla de prueba
Ejecute a continuación instrucción para crear una tabla llamada
t0:CREATE TABLE t0(a INT PRIMARY KEY, b INT) ENGINE=InnoDB; -
Datos de la tabla de prueba
Ejecute a continuación instrucción para generar datos de prueba aleatorios:
DELIMITER // CREATE PROCEDURE populate_t0() BEGIN DECLARE i int DEFAULT 1; WHILE (i <= $table_size) DO INSERT INTO t0 VALUES (i, 1000000 * RAND()); SET i = i + 1; END WHILE; END // DELIMITER ; CALL populate_t0();NotaAl ejecutar la prueba, reemplace
$table_sizepor la cantidad real de registros de la tabla, por ejemplo,1000000.Esta prueba utiliza tablas que contienen 1,000,000, 10,000,000, 100,000,000 y 1,000,000,000 de registros.
-
Operaciones DDL utilizadas en la prueba
add primary keyadd secondary Indexoptimize table
-
-
Métodos de prueba
Prueba 1: mida el tiempo necesario para ejecutar distintas operaciones DDL en tablas con diferentes volúmenes de datos, tanto con la función de optimización de la replicación física de DDL habilitada como deshabilitada.
Prueba 2: cuando la función de optimización de la replicación física de DDL se usa junto con Parallel DDL, mida el tiempo necesario para ejecutar la operación
add secondary Indexen una tabla que contiene mil millones de registros.Prueba 3: mida el rendimiento del nodo de solo lectura, por ejemplo, si su estado es normal, el uso máximo de CPU y el retraso de replicación, con la función de optimización de la replicación física de DDL habilitada o deshabilitada. La prueba utiliza un clúster que contiene una tabla con mil millones de registros y varía la cantidad de operaciones DDL simultáneas en el nodo principal (1, 2, 4, 6 y 8).
-
Resultados de la prueba
-
Prueba 1
Cuando el parámetro innodb_bulk_load_page_grained_redo_enable está habilitado o deshabilitado, a continuación figura muestra el tiempo, en segundos, necesario para ejecutar la operación
add primary key(a)en tablas con distintos volúmenes de datos (1 millón, 10 millones, 100 millones y mil millones).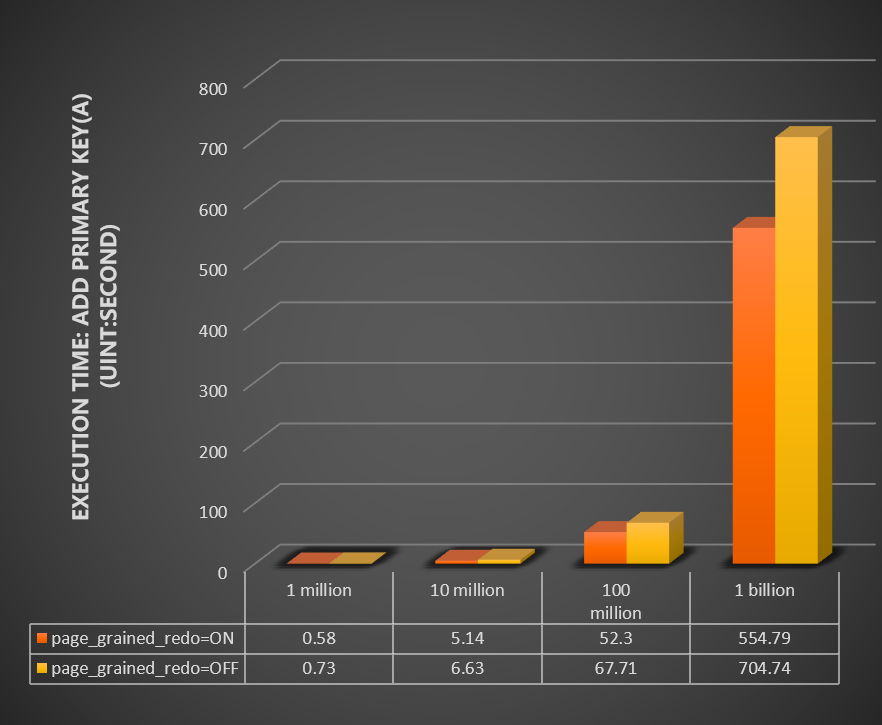
Cuando el parámetro innodb_bulk_load_page_grained_redo_enable está habilitado o deshabilitado, a continuación figura muestra el tiempo, en segundos, necesario para ejecutar la operación
optimize tableen tablas con distintos volúmenes de datos (1 millón, 10 millones, 100 millones y mil millones).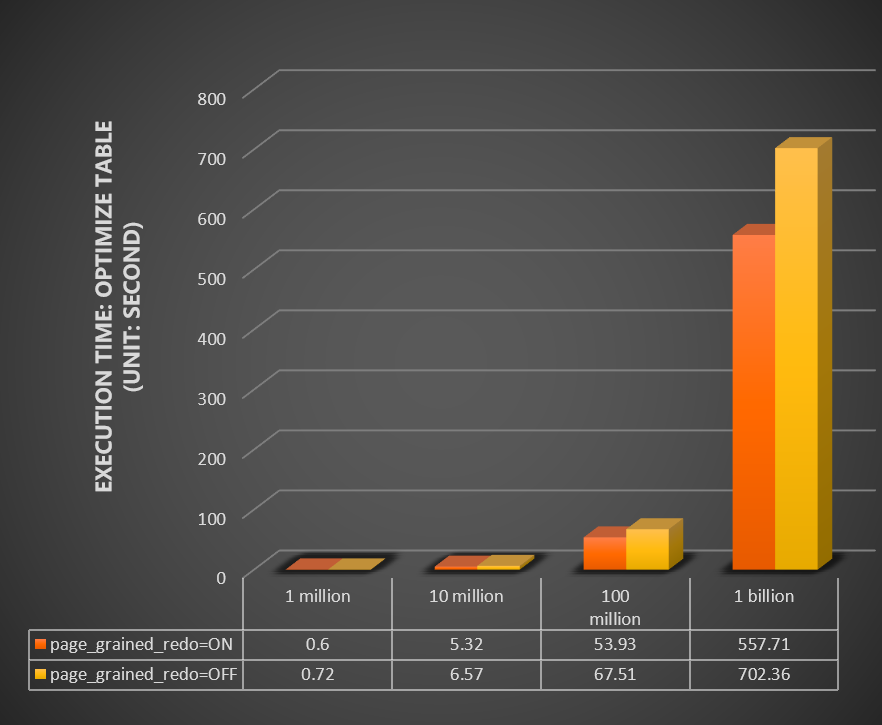
-
Prueba 2
En esta prueba se habilitan los parámetros Parallel DDL innodb_polar_use_sample_sort y innodb_polar_use_parallel_bulk_load. Se utiliza una tabla que contiene mil millones de registros y se ejecuta con el parámetro innodb_bulk_load_page_grained_redo_enable habilitado o deshabilitado. También se emplean distintas cantidades de subprocesos paralelos (es decir, el parámetro innodb_polar_parallel_ddl_threads establecido en 1, 2, 4, 8, 16 y 32). La prueba mide el tiempo, en segundos, necesario para ejecutar la operación
add secondary Index. A continuación figura muestra los resultados.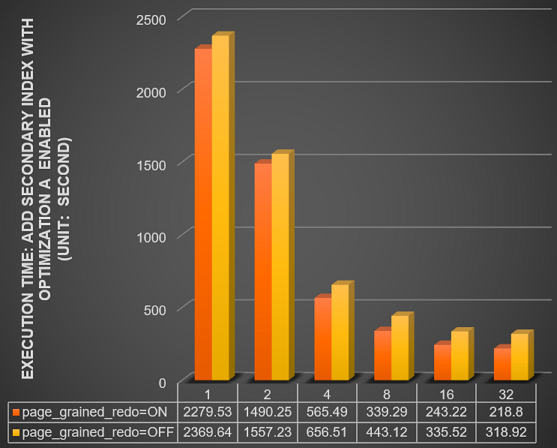
En esta prueba se deshabilitan los parámetros Parallel DDL innodb_polar_use_sample_sort y innodb_polar_use_parallel_bulk_load. Se utiliza una tabla que contiene mil millones de registros y se ejecuta con el parámetro innodb_bulk_load_page_grained_redo_enable habilitado o deshabilitado. También se emplean distintas cantidades de subprocesos paralelos (1, 2, 4, 8, 16 y 32). La prueba mide el tiempo, en segundos, necesario para ejecutar la operación
add secondary Index. A continuación figura muestra los resultados.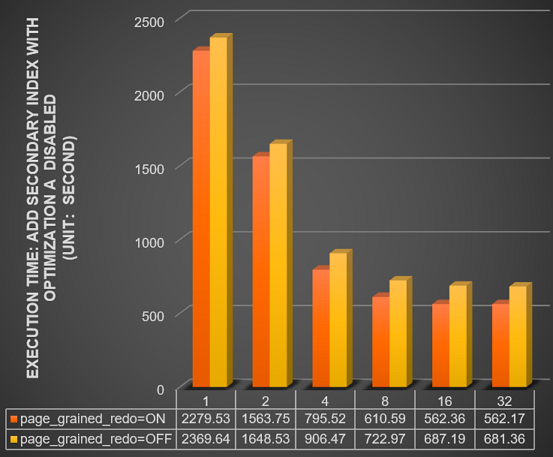
-
Prueba 3
-
En esta prueba se habilita innodb_bulk_load_page_grained_redo_enable. Se utiliza un clúster que contiene una tabla con mil millones de registros. A continuación tabla muestra el rendimiento del nodo de solo lectura para distintas cantidades de operaciones DDL simultáneas en el nodo principal (1, 2, 4, 6 y 8).
Cantidad de operaciones DDL simultáneas
1
2
4
6
8
Estado del nodo de solo lectura
Normal
Normal
Normal
Normal
Normal
Uso máximo de CPU (%)
1.86
1.71
1.76
2.25
2.36
Uso máximo de memoria (%)
10.37
10.80
10.88
11
11.1
IOPS máximas de lectura (operaciones/segundo)
10965
10762
10305
10611
10751
Retraso máximo de replicación (segundos)
0
0.73
0.87
0.93
0.03
-
En esta prueba se deshabilita innodb_bulk_load_page_grained_redo_enable. Se utiliza un clúster que contiene una tabla con mil millones de registros. A continuación tabla muestra el rendimiento del nodo de solo lectura para distintas cantidades de operaciones DDL simultáneas en el nodo principal (1, 2, 4, 6 y 8).
NotaLos datos correspondientes a cuatro operaciones DDL simultáneas se recopilaron antes de que el nodo de solo lectura quedara no disponible.
El símbolo
-en la tabla indica que no fue posible ejecutar las operaciones DDL relacionadas para la cantidad actual de operaciones DDL simultáneas. Por lo tanto, no hay datos de prueba disponibles.
Cantidad de operaciones DDL simultáneas
1
2
4
6
8
Estado del nodo de solo lectura
Normal
Normal
Unavailable
Unavailable
Unavailable
Uso máximo de CPU (%)
4.2
9.5
10.3
-
-
Uso máximo de memoria (%)
22.15
23.55
68.61
-
-
IOPS máximas de lectura (operaciones/segundo)
9243
7578
7669
-
-
Retraso máximo de replicación (segundos)
0.8
14.67
211
-
-
-
-
Contáctenos
Si tiene preguntas sobre las operaciones DDL, Contact us.