Ejecuta inference sin conexión en los modelos generados por el componente XGBoost Train. Es compatible con tareas de clasificación y regresión mediante datos de entrada en formato Table o LibSVM.
Límites
Motores de cómputo compatibles: MaxCompute, Flink y DLC.
Formatos de datos
Formatos compatibles: Table y LibSVM.
-
Ejemplo del formato Table:
f0
f1
label
0.1
1
0
0.9
2
1
-
Ejemplo del formato LibSVM:
Datos de muestra
2:1 9:1 10:1 20:1 29:1 33:1 35:1 39:1 40:1 52:1 57:1 64:1 68:1 76:1 85:1 87:1 91:1 94:1 101:1 104:1 116:1 123:1
0:1 9:1 18:1 20:1 23:1 33:1 35:1 38:1 41:1 52:1 55:1 64:1 68:1 76:1 85:1 87:1 91:1 94:1 101:1 105:1 115:1 121:1
2:1 8:1 18:1 20:1 29:1 33:1 35:1 39:1 41:1 52:1 57:1 64:1 68:1 76:1 85:1 87:1 91:1 94:1 101:1 104:1 116:1 123:1
2:1 9:1 13:1 21:1 28:1 33:1 36:1 38:1 40:1 53:1 57:1 64:1 68:1 76:1 85:1 87:1 91:1 94:1 97:1 105:1 113:1 119:1
0:1 9:1 18:1 20:1 22:1 33:1 35:1 38:1 44:1 52:1 55:1 64:1 68:1 76:1 85:1 87:1 91:1 94:1 101:1 104:1 115:1 121:1
0:1 8:1 18:1 20:1 23:1 33:1 35:1 38:1 41:1 52:1 55:1 64:1 68:1 76:1 85:1 87:1 91:1 94:1 101:1 105:1 116:1 121:1
Configuración de la interfaz gráfica
Configure el componente XGBoost Predict en el lienzo de Designer.
Parámetro | Tipo | Descripción | |
Fields Setting | Reserved Column Name | Arreglo de cadenas | Columnas que se conservan en la salida. |
Feature Columns | Arreglo de cadenas | Columnas de características para datos en formato Table. Este parámetro es mutuamente excluyente con Vector Field (formato LibSVM). | |
Vector Field Name | Cadena | Columna que contiene los datos en formato LibSVM. Este parámetro es mutuamente excluyente con Feature Columns (formato Table). | |
Parameters Setting | Prediction Result Column | Cadena | Nombre de la columna de salida para los resultados de predicción. |
Execution Tuning | Number of Workers | Entero positivo | Número de workers en paralelo. Establezca este valor junto con Memory per Worker. Valores válidos: [1, 9999]. |
Memory per Worker | Entero positivo | Memoria asignada a cada worker, en MB. Valores válidos: [1024, 64 × 1024]. | |
Ejemplo de uso
Este ejemplo muestra cómo aplicar una clasificación con XGBoost sobre datos de eventos de bosones de Higgs mediante una plantilla predefinida. Para crear esta canalización a partir de la plantilla Use XGBoost algorithm to identify the Higgs boson, consulte Create a pipeline from a preset template.
<!--@image {"id":"12490c81573k7","alt":"imagen","placement":"break","props":"china","src":"../images/p762255.png}/-->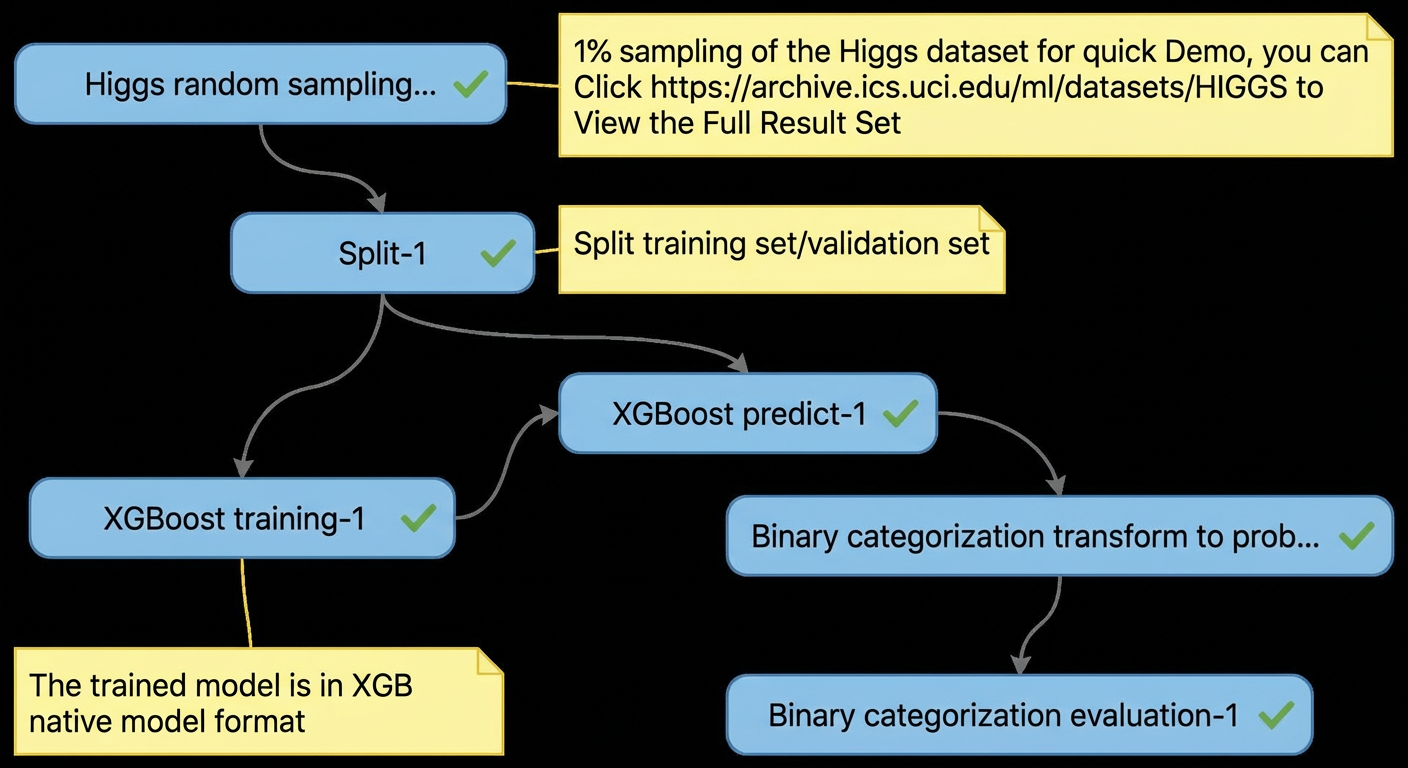
Convertir el formato de salida para la evaluación
El componente genera cadenas JSON serializadas desde la biblioteca de código abierto XGBoost. Convierta esta salida para que los componentes de evaluación procesen las predicciones.
Agregue un componente SQL Script después de XGboost Predict. El SQL Script convierte las predicciones al formato que requiere Binary classification Evaluation V2. Use el siguiente código:
set odps.sql.udf.getjsonobj.new=true;

select *, CONCAT("{\"0\":", 1.0-prob, ",\"1\":", prob, "}") as detail
FROM (
select *, cast(get_json_object(pred, '$[0]') as double) as prob FROM ${t1})
Referencias
XGBoost Predict necesita un modelo entrenado por el componente XGBoost Train. Para conocer los detalles de configuración, consulte XGBoost Train.
Designer ofrece componentes de algoritmos para tareas de procesamiento de datos. Consulte Overview of Designer components para ver la lista completa.