Despliegue y llame a un modelo de lenguaje grande (LLM) cifrado en el entorno seguro de inference cifrada de PAI-EAS dentro de Platform for AI (PAI). El modelo se cifra y se carga para usarse dentro de un entorno de confianza. Durante el despliegue, el servicio de atestación remota (Trustee) comprueba que el entorno de ejecución sea confiable y libera la clave de descifrado, la cual descifra y monta el modelo. Trusted Network Gateway (TNG) cifra de forma transparente el tráfico de inference. Estas capas de protección mantienen seguros sus datos y su modelo durante todo su ciclo de vida. Esta solución es adecuada para cargas de trabajo que manejan datos sensibles bajo requisitos de seguridad estrictos, como servicios financieros, gobierno y aplicaciones empresariales.
Cómo funciona
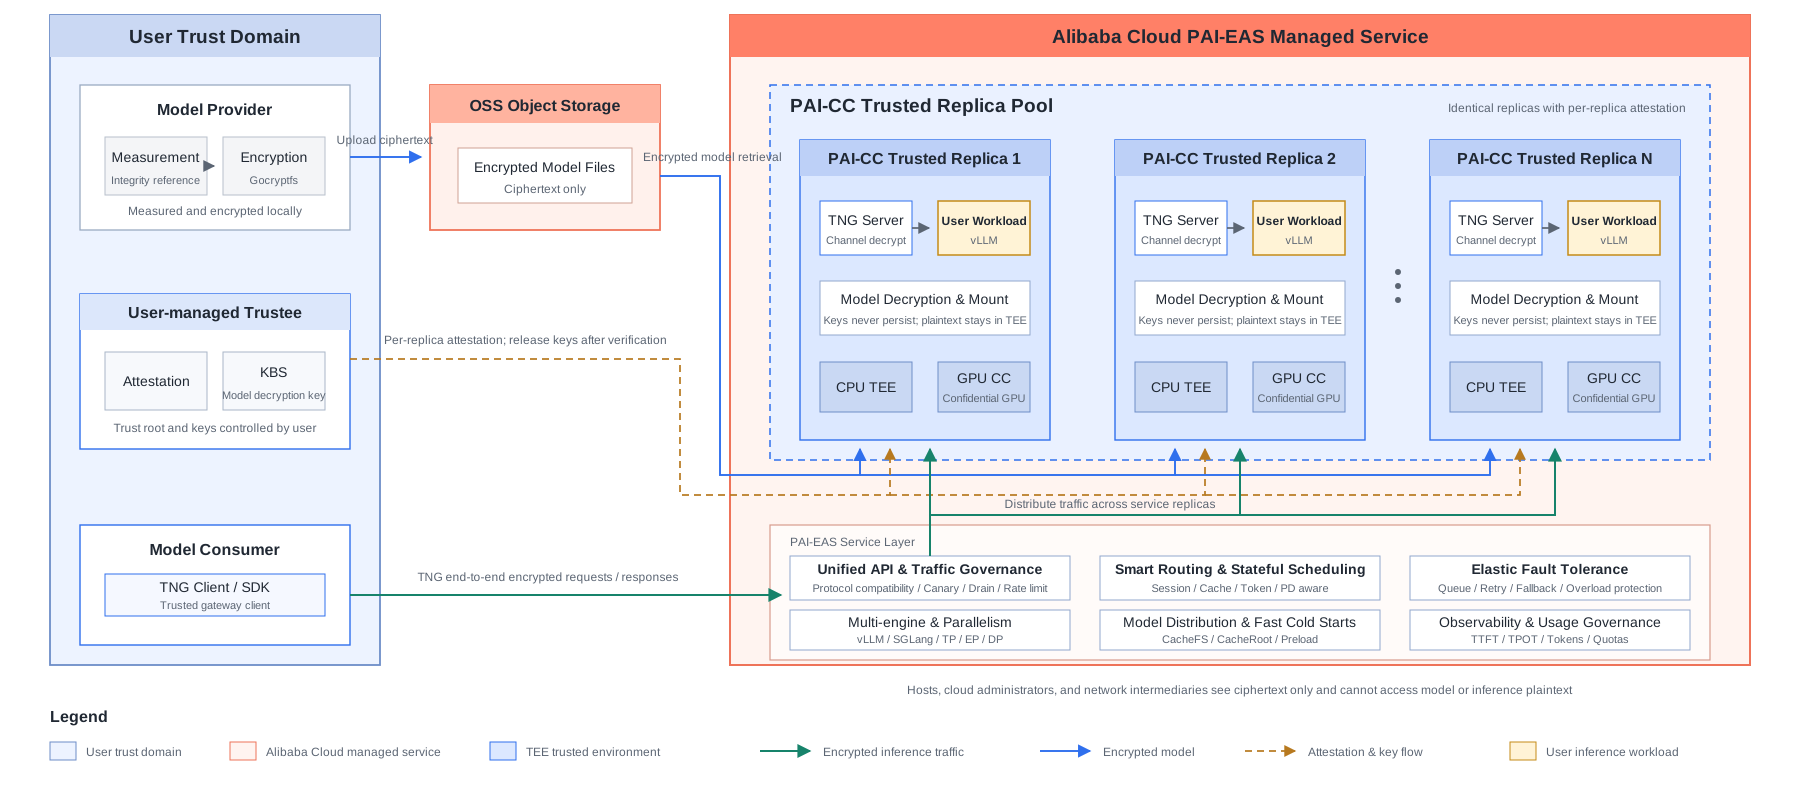
PAI-CC (PAI Confidential Computing) es el servicio de inference de PAI-EAS diseñado para cargas de trabajo de cómputo confidencial. Se basa en un servicio de inference estándar de Elastic Algorithm Service (EAS) y protege la inference del modelo de extremo a extremo con las siguientes funciones:
CPU TEE (entorno de ejecución de confianza Intel TDX): el proceso de inference se ejecuta en un dominio de confianza aislado por hardware Intel TDX. La carga del modelo, la tokenización, la lógica de programación y la caché KV ocurren dentro del enclave en la CPU, por lo que ni el host ni la plataforma en la nube pueden leer el texto sin formato.
GPU TEE (GPU confidencial): la GPU forma parte del entorno de ejecución de confianza (TEE). Este entorno protege la transferencia de los pesos del modelo desde la CPU hacia la GPU, así como el cálculo de atención, la multiplicación de matrices y la caché KV dentro de la GPU. La interconexión entre la CPU y la GPU está cifrada.
Almacenamiento cifrado del modelo: el modelo se cifra con gocryptfs (AES256-GCM), se almacena en Object Storage Service (OSS) y se transfiere a la instancia como texto cifrado. La clave de descifrado se inyecta en el TEE solo después de que la atestación remota se completa correctamente; luego se descifra y se monta el modelo. La clave nunca se escribe en disco ni sale del TEE.
Atestación remota: antes del despliegue y antes de iniciar la inference, Trustee verifica la firma de hardware del TEE, la medición del firmware y la configuración de ejecución de la instancia. La clave de descifrado del modelo se libera únicamente cuando esta verificación es exitosa.
Medición de integridad del modelo (verity): opcional. Esta función genera un hash raíz de árbol de Merkle para los archivos del modelo y lo comprueba durante el despliegue. Así se evita que el modelo se modifique o se reemplace en tiempo de ejecución.
Tráfico de inference cifrado (protección de puerta de enlace TNG): opcional. TNG cifra de manera transparente las solicitudes y respuestas entre el cliente y el servicio de inference, lo que protege los datos de inference de extremo a extremo. Las claves se negocian durante el protocolo de enlace de la atestación remota. Cada solicitud de inference utiliza una clave única para evitar escuchas no autorizadas y modificaciones en la ruta de red.
Instale el cliente pai-cc-tools
pai-cc-tools agrupa los comandos para medir, cifrar y cargar modelos, además de ejecutar inference confidencial. Instale el cliente antes de empezar:
curl -fsSL https://conf-ai.oss-cn-beijing.aliyuncs.com/pai-cc/pai-cc-tools-20260924-3599a46.tar.gz | tar -xz -C /opt && ln -sf /opt/pai-cc-tools/pai-cc /usr/local/bin/pai-ccA partir de este momento, el comando pai-cc queda disponible.
Paso 1: Prepare un modelo cifrado
Este paso consta de tres partes: medir el modelo (opcional), cifrarlo y cargarlo. Los archivos del modelo son grandes, por lo que el proceso puede tardar bastante tiempo.
Para probar esta solución rápidamente, utilice el archivo de modelo cifrado que se proporciona en la siguiente tabla. Omita las partes de medición, cifrado y carga de este paso, y continúe directamente con Step 2: Set up the Trustee remote attestation service.
Agregue el valor de referencia de la tabla anterior a la directiva de atestación remota en el paso 2. De esta forma, se verificará el modelo que su servicio cargue durante el despliegue. Si desea usar su propio modelo, complete las siguientes partes. En este tema se utiliza el modelo Qwen3.8-27B como ejemplo.
1. Mida el modelo (opcional)
La medición del modelo genera un valor de referencia para el directorio del modelo. Durante el despliegue, el servicio usa este valor para comprobar que ni el modelo cargado ni el punto de control en tiempo de ejecución hayan sido modificados. Complete esta parte si necesita verificar un modelo que carga desde una fuente remota y proteger el punto de control en tiempo de ejecución contra alteraciones. Mida el modelo antes de cifrarlo.
# Pull online from ModelScope or use a local directory
DIR=$(pai-cc model measure --modelscope Qwen/Qwen3.8-27B --hash-output /tmp/qwen-root.hash)
echo "Path of the measured model: ${DIR}"
El valor de referencia se escribe en el archivo especificado por
--hash-output. Registre este valor, ya que más adelante podrá utilizarlo como referencia para la atestación remota.
2. Cifre el modelo
La inference cifrada de PAI-EAS utiliza Gocryptfs, un método de cifrado basado en AES256-GCM compatible con el estándar de código abierto gocryptfs.
El comando pai-cc model encrypt ejecuta el cifrado. Esta solución emplea la clave 0Bn4Q1wwY9fN3P en todo el proceso. Usted debe proporcionar dicha clave.
-
(Opcional) Para cifrar el modelo medido:
CIPHER=$(pai-cc model encrypt --model "$DIR" --method gocryptfs --key 0Bn4Q1wwY9fN3P) echo "Path of the measured and encrypted model: ${CIPHER}" -
Para cifrar el modelo sin medirlo previamente:
CIPHER=$(pai-cc model encrypt --modelscope Qwen/Qwen3.8-27B --method gocryptfs --key 0Bn4Q1wwY9fN3P)
echo "Path of the encrypted model: ${CIPHER}"
3. Cargue el modelo
Cargue el directorio de texto cifrado en un bucket de OSS ubicado en la misma región que la instancia de despliegue. El comando pai-cc model upload integra ossutil, realiza una carga plana del texto cifrado y verifica la cantidad de archivos.
URI=$(pai-cc model upload --cipher "$CIPHER" --bucket <your-bucket> --prefix qwen3.8-27b-gocryptfs)El comando escribe el URI
oss://<your-bucket>/qwen3.8-27b-gocryptfs/en stdout. Utilice esta ruta para la configuración de Storage Mount en el paso 3.
Paso 2: Configure el servicio de atestación remota Trustee
Usted gestiona el servicio de atestación remota, el cual verifica el entorno de ejecución del modelo y del servicio de inference. La clave de descifrado del modelo se inyecta únicamente cuando el entorno de despliegue cumple con sus requisitos de confianza. Después, la clave descifra y monta el modelo. Esta solución despliega Trustee en Elastic Compute Service (ECS).
-
Prepare una instancia de ECS estándar con una dirección IP pública y seleccione Alibaba Cloud Linux 3.2104 LTS 64-bit como sistema operativo. Ejecute todos los comandos siguientes en esta instancia.
Para los requisitos de seguridad más estrictos, también puede desplegar Trustee en un centro de datos local o en un servidor físico. Conéctelo a la VPC en la nube mediante un circuito de Express Connect o una VPN. De este modo, la raíz de confianza permanece totalmente bajo su control.
-
Inicie sesión en la instancia y, a continuación, instale e inicie Trustee desde el repositorio yum:
yum install -y trustee-1.10.0Trustee se inicia automáticamente y escucha en el puerto 8081 de forma predeterminada. Su endpoint es
http://<trustee-ip>:8081/api. Configure HTTPS para Trustee en entornos de producción. -
Importe la clave de descifrado del modelo en Trustee. Esta solución utiliza la clave
0Bn4Q1wwY9fN3P, la cual usted debe proporcionar. Al escribir la clave, utiliceecho -npara omitir el salto de línea final. Así garantizará que el valor coincida byte por byte con la clave de cifrado:sudo mkdir -p /opt/trustee/kbs/repository/default/aliyun/ sudo sh -c 'echo -n "0Bn4Q1wwY9fN3P" > /opt/trustee/kbs/repository/default/aliyun/model-decryption-key'Después de este paso, el identificador de la clave en Trustee será
kbs:///default/aliyun/model-decryption-key. Este es el valor dedecryption_keyen la configuración del paso 3. -
Configure la directiva de atestación remota. El archivo de la directiva es
/opt/trustee/attestation-service/policies/opa/default.rego. Trustee evalúa cada réplica de la instancia de PAI-CC y decide si libera la clave. -
Reinicie Trustee:
sudo systemctl restart trustee
Paso 3: Cree un servicio de PAI-CC
Cree un resource group de Lingjun y adquiera nodos. Siga las instrucciones de Create a resource group and purchase Lingjun resources para crear el resource group en la región China (Beijing) y adquirir instancias del tipo
ml.gu8tef.8.46xlarge.cc. Este tipo de instancia se encuentra en vista previa por invitación. Póngase en contacto con su administrador de cuenta de Alibaba Cloud para solicitar acceso.Cree una virtual private cloud (VPC) en la región China (Beijing), cree un vSwitch en la zona beijing-i y, a continuación, cree un security group en la VPC. Esta VPC alojará los contenedores confidenciales que ejecutan la inference para la instancia de PAI-CC que creará más adelante. Configure la función SNAT de una puerta de enlace NAT de Internet para la VPC y asocie una dirección IP elástica (EIP). Así, las instancias tendrán acceso a la red pública para descargar el texto cifrado del modelo y comunicarse con Trustee. Para obtener más información, consulte Internet NAT gateway.
Configure la red de la instancia donde se ejecuta Trustee para que la instancia de PAI-CC pueda comunicarse con él a través de la red pública. Agregue una regla de entrada al security group de la instancia de ECS de Trustee para permitir el tráfico en el puerto 8081 (TCP personalizado). Establezca como origen la dirección IP de salida SNAT que configuró para la VPC.
Cree una cuota de recursos. Siga las instrucciones de Create a resource quota: para Source Type, seleccione Lingjun resource group y elija el resource group de Lingjun que creó, junto con sus nodos o tipos de instancia. Para VPC, seleccione la VPC que creó. En Associate Workspace, elija un espacio de trabajo de PAI. La cuota de recursos se asignará a dicho espacio de trabajo. Si aún no ha creado uno, siga las instrucciones de Create and manage workspaces para hacerlo.
Inicie sesión en la PAI console. En la parte superior de la página, seleccione la región. A la derecha, seleccione el espacio de trabajo. Luego haga clic en Elastic Algorithm Service (EAS). En la pestaña Inference Service, haga clic en Deploy Service. En la sección Custom Model Deployment, haga clic en Custom Deployment.
-
Configure los siguientes parámetros clave. Para obtener más información sobre el resto de los parámetros, consulte Custom deployment.
Parámetro
Descripción
Resource Information
Resource Type
Seleccione Resource Quota y, a continuación, elija la cuota de recursos de Lingjun que creó.
Deployment
Para GPU (Number of GPUs), especifique
1. Para CPU (Number of Cores), especifique20. Para Memory (GB), especifique200. Ajuste estos valores según su modelo y la forma en que despliegue el servicio.Replicas
Especifique
8. Ajuste este valor según la configuración de Deployment.Environment Information
Deployment Method
Seleccione Image-based Deployment.
Image Configuration
Seleccione una imagen de ejecución. En este ejemplo, elija Alibaba Cloud Image > vllm 0.25.0-gpu.
Storage Mount
Seleccione OSS. Establezca Uri en
oss://conf-ai/qwen3.8-27b-gocryptfs/(la ruta de texto cifrado que cargó en el paso 1) y Mount Path en/mnt/model/. Utilice un montaje de solo lectura.Command to Run
vllm serve /mnt/model/ --host 0.0.0.0 --port 8000 --served-model-name "Qwen3.8-27B". La ruta del modelo/mnt/model/debe coincidir con el Mount Path de OSS que especificó.Port Number
8000.
Network Information
VPC
Seleccione la VPC y el vSwitch que creó.
Security Group Name
Seleccione el security group que creó.
Features
GPU Driver Version
Utilice
570.148.08-open. Si no puede seleccionar este campo, edite directamente la configuración JSON.La principal diferencia entre PAI-CC y un servicio EAS estándar es el cómputo confidencial. Cuando cree un servicio de PAI-CC, habilite también Configure Secure Encryption Environment y configure las siguientes opciones. Una vez habilitada esta opción, el servicio de inference se ejecutará en un entorno de cómputo confidencial protegido tanto por el TEE de la CPU como por el TEE de la GPU. Durante la inference, los pesos del modelo, la caché KV y todos los cálculos intermedios permanecen dentro del TEE, sin exponer texto sin formato al host. En el despliegue, el modelo se descifra y se monta únicamente después de que la atestación remota se completa correctamente. Luego, TNG cifra el tráfico de inference.
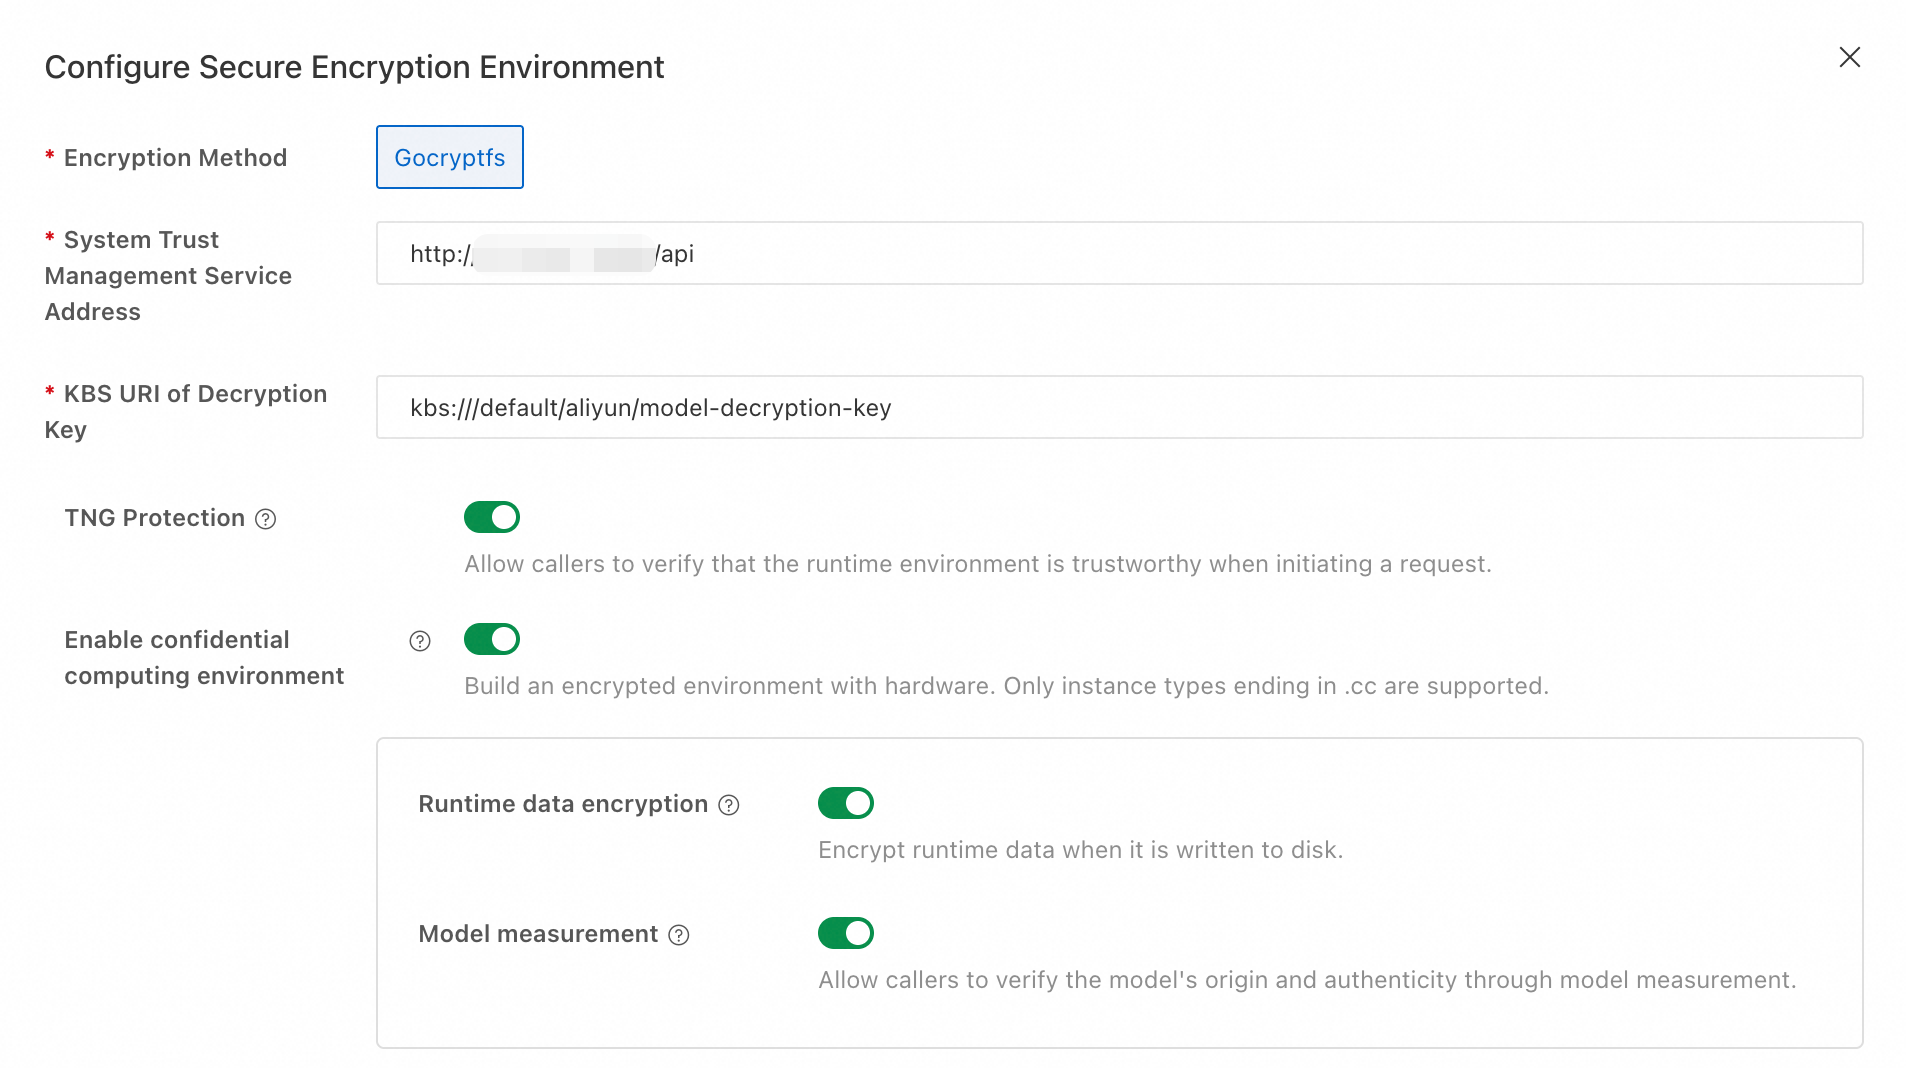
Elemento de configuración
Valor
Encryption Method
Gocryptfs (el mismo que utilizó en
--methoden el paso 1)Configure Secure Encryption Environment
Habilitado
Runtime data encryption
Habilitado
TNG gateway protection
Habilitado (TNG cifra el tráfico de inference)
Model measurement
Habilitado (si midió el modelo en el paso 1)
System Trust Management Service Address
http://<trustee-ip>:8081/api(el endpoint del servicio Trustee que desplegó)KBS URI of Decryption Key
kbs:///default/aliyun/model-decryption-keyEn el siguiente ejemplo se muestra la configuración JSON resultante:
Una vez configurados los parámetros, haga clic en Deploy. Cuando service status muestre Running, el servicio estará desplegado.
Paso 4: Ejecute inference confidencial
TNG cifra el tráfico entre el cliente y el servicio de inference. La inference se ejecuta en el entorno de cómputo confidencial proporcionado por Intel TDX y el TEE de la GPU. Sus solicitudes y respuestas, incluidas las de streaming, se cifran durante la transmisión.
Su cliente envía las solicitudes de inference a través del cliente TNG. A continuación se muestran los métodos de acceso disponibles. Elija el que mejor se adapte a su caso de uso.
|
Método de acceso |
Cómo obtenerlo |
|
Puerta de enlace proxy (proxy HTTP / proxy SOCKS5 / proxy transparente) |
Descargue los binarios o contenedores desde el repositorio de GitHub. Consulte la documentación y los ejemplos |
|
SDK de Python |
|
|
SDK de Go |
|
|
SDK de JS |
|
Para simplificar estos ejemplos, pai-cc-tools integra las llamadas de TNG que se muestran en la tabla anterior.
1. Consulte el endpoint del servicio
En la pestaña Inference Service, haga clic en el nombre de su servicio para abrir la página Overview. En la sección Basic Information, haga clic en View Endpoint Information.
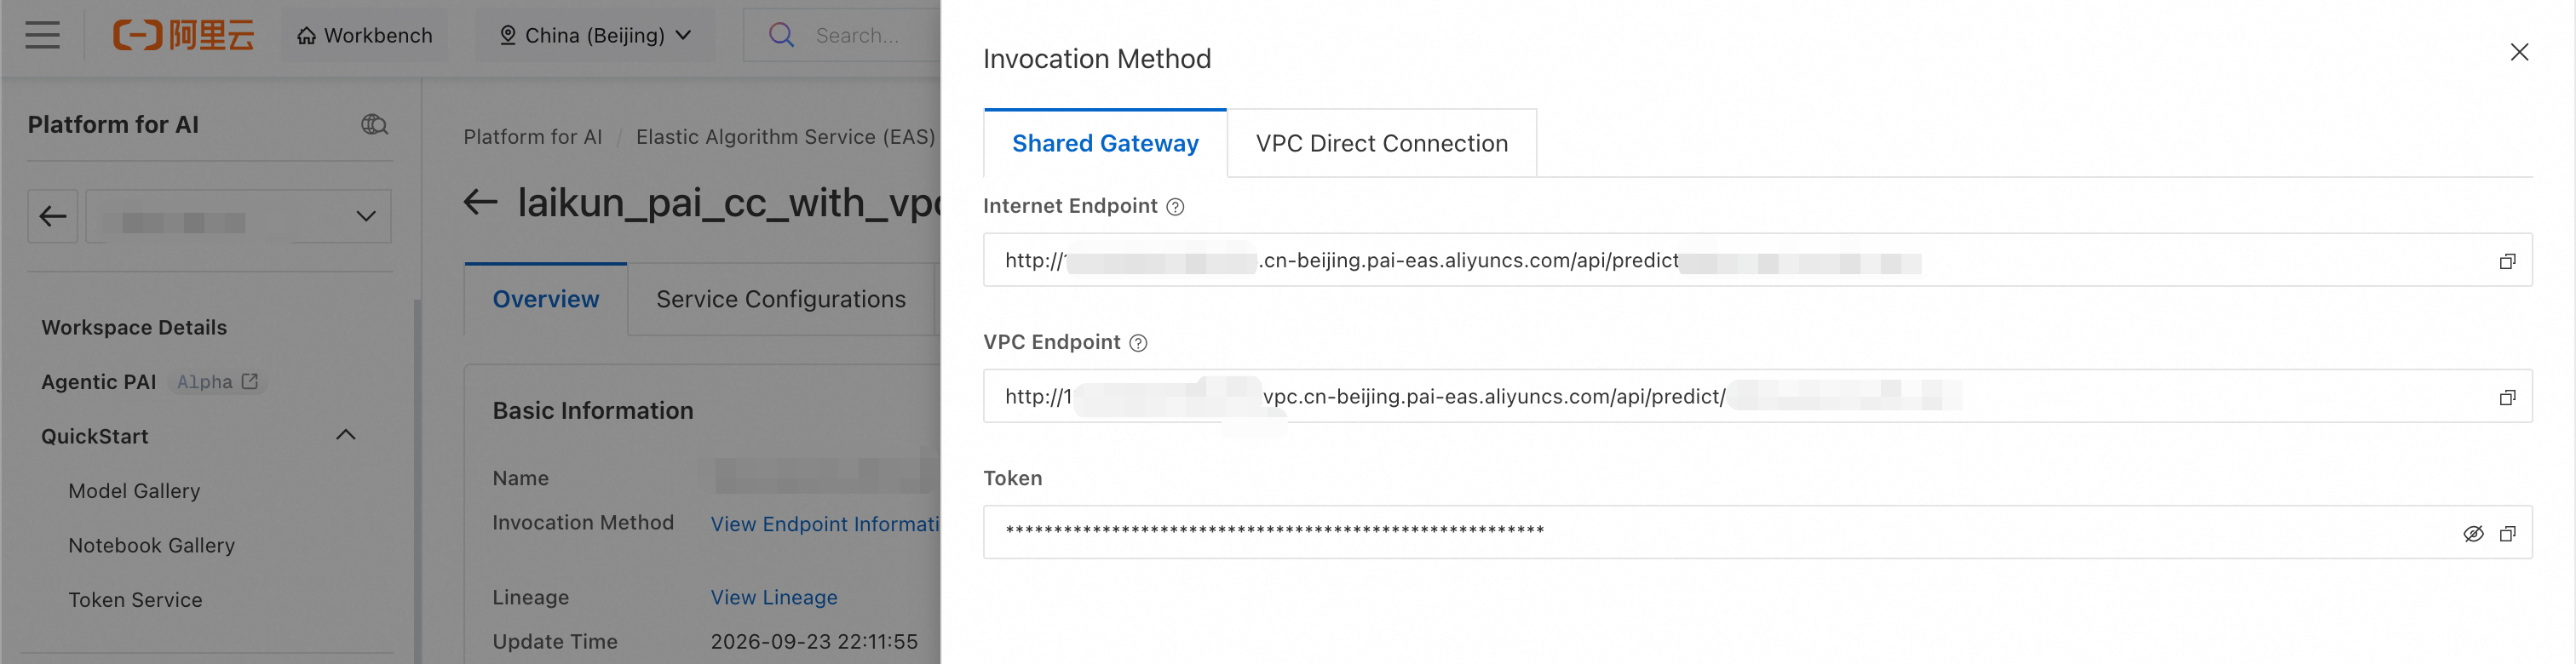
Registre el endpoint del servicio y el token para utilizarlos en los comandos pai-cc secure que siguen.
2. Ejecute una sola inference confidencial
El comando pai-cc secure run descarga y configura automáticamente los componentes de TNG necesarios. La puerta de enlace cifra de forma transparente cada solicitud de inference que envía el comando curl:
pai-cc secure run -- \
    curl -sS -X POST http://<service-url>/v1/chat/completions \
        -H "Authorization: <your-token>" -H "Content-Type: application/json" \
        -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"Hello"}],"max_tokens":100,"stream":false}'
Todo lo que aparece después de -- es el comando original completo, incluida la URL y el encabezado Authorization. Resultado real:
{"id":"chatcmpl-b1df6ef135765608","object":"chat.completion","created":1790173748,"model":"Qwen3.8-27B","choices":[{"index":0,"message":{"role":"assistant","content":"The user said \"Hello\" - a simple greeting. I should respond warmly and concisely, offering to help.\n```\n\n\nHello! How can I help you today?","refusal":null,"annotations":null,"audio":null,"function_call":null,"reasoning":null},"logprobs":null,"finish_reason":"stop","stop_reason":null,"token_ids":null,"routed_experts":null}],"service_tier":null,"system_fingerprint":"vllm-0.25.0-fb7f4d0a","usage":{"prompt_tokens":53,"total_tokens":90,"completion_tokens":37,"prompt_tokens_details":null},"prompt_logprobs":null,"prompt_token_ids":null,"prompt_text":null,"kv_transfer_params":null,"metrics":null}
3. Compruebe la compatibilidad del SDK
Ejecute el siguiente comando para comprobar que todos los SDK de cliente de TNG pueden realizar llamadas confidenciales a este servicio de inference. El comando abarca el modo proxy, la inyección de procesos, el SDK de Python, el SDK de Go y el SDK de JS.
pai-cc secure test \
  --endpoint http://<service-url>/v1/chat/completions \
  --token <your-token> --builtin-as -m all
── tng-launch ──────────────────────────────────
PASS	tng-launch
── tng-exec ──────────────────────────────────
PASS	tng-exec
── python-sdk ──────────────────────────────────
PASS	python-sdk
── go-sdk ──────────────────────────────────
PASS	go-sdk
── js-sdk ──────────────────────────────────
PASS	js-sdk
summary: 5 passed, 0 failed, 0 skipped