Este tema describe los códigos de estado y los errores comunes que se devuelven al llamar a un servicio.
Descripción de los códigos de estado
|
Código de estado |
Descripción |
|
200 |
El servicio procesó la solicitud correctamente. |
|
400 |
The Request Body format is incorrect o se produjo una excepción en el código del procesador personalizado. Nota
Si el código del procesador personalizado genera una excepción, el servidor devuelve un código de estado 400. Para diferenciarlo de otros errores, configure el procesador personalizado para que devuelva un código de estado específico ante las excepciones. |
|
401 |
Error de autenticación del servicio. Para obtener más información, consulte 401 Authorization Failed. |
|
404 |
Servicio no encontrado. Para obtener más información, consulte 404 Not Found. |
|
405 |
Método no permitido. Por ejemplo, el servidor devuelve un error 405 si envía una solicitud POST a un servidor que solo admite solicitudes GET. Intente usar un método HTTP diferente. |
|
408 |
Se agotó el tiempo de espera de la solicitud. El servidor tiene un tiempo de espera predeterminado de 5 segundos para cada solicitud. Puede configurar este valor mediante el campo Nota
El tiempo total de procesamiento de una sola solicitud incluye el tiempo de cálculo del procesador, el tiempo necesario para recibir los paquetes de datos de red y cualquier tiempo de espera en una cola. |
|
429 |
La solicitud activó el límite de velocidad.
|
|
450 |
|
|
499 |
El cliente cerró la conexión. Cuando un cliente cierra una conexión de forma activa, no recibe el código de estado 499. En su lugar, el servidor registra con un código de estado 499 cualquier solicitud no procesada de esa conexión. Por ejemplo, si un cliente tiene un tiempo de espera HTTP de 30 ms y la latencia de procesamiento del servidor es de 50 ms, el cliente abandona la solicitud después de 30 ms y cierra la conexión. Posteriormente, aparece un código de estado 499 en el monitoreo del lado del servidor. |
|
500 |
Error interno del servidor. El servidor encontró una condición inesperada que le impidió completar la solicitud. |
|
501 |
No implementado. El servidor no admite la funcionalidad necesaria para completar la solicitud. |
|
502 |
Puerta de enlace incorrecta. El servidor, mientras actuaba como puerta de enlace o proxy, recibió una respuesta no válida de un servidor ascendente. |
|
503 |
Servicio no disponible. Cuando accede a un servicio a través de una puerta de enlace, si ninguna instancia del servicio de backend está lista, la puerta de enlace devuelve un código de estado 503. Para obtener más información, consulte 503 no healthy upstream. |
|
504 |
Tiempo de espera de la puerta de enlace agotado. Para obtener más información, consulte 504 timeout. |
|
505 |
Versión de HTTP no compatible. El servidor no admite la versión del protocolo HTTP utilizada en la solicitud. |
Códigos de error de invocación del SDK
Al usar el SDK oficial de EAS para llamar a un servicio, el SDK puede generar sus propios códigos de error, los cuales pueden diferir de los que devuelve el servidor. Utilice siempre los códigos de error de los registros de la puerta de enlace y del servicio como fuente de verdad.
|
Código de estado |
Descripción |
|
512 |
Al usar el SDK de Golang de EAS, si el cliente se desconecta de forma activa, el SDK devuelve un código de error 512. Este tiempo de espera del lado del cliente corresponde a un código de estado 499 en el lado del servidor. |
Errores comunes
404 Not Found
Un error 404 suele indicar una ruta de solicitud no válida, un cuerpo de solicitud incorrecto o una API que el servicio no admite. Utilice los siguientes escenarios para solucionar problemas según el mensaje de error específico que reciba.
Tipo de error 1: {"object":"error","message":"The model `` does not exist.","type":"NotFoundError","param":null,"code":404}
Causa: el parámetro model del cuerpo de la solicitud está vacío o no es válido al llamar al endpoint /v1/chat/completions de un servicio desplegado con vLLM.

Solución: el valor del parámetro model debe ser un nombre de modelo válido. Consulte los nombres de modelo válidos mediante el endpoint v1/models.
Tipo de error 2: {"detail":"Not Found"}
Causa: la ruta de la solicitud está incompleta o es incorrecta. Por ejemplo, al llamar al endpoint de chat de un servicio LLM, no agregó la ruta v1/chat/completions a la URL base.

Solución: asegúrese de que la ruta de la solicitud de API esté completa y sea correcta. Para los servicios LLM, consulte LLM service invocation.
Tipo de error 3: la llamada al endpoint /v1/models de BladeLLM devuelve 404: Not Found.
Causa: el servicio desplegado con BladeLLM no admite el endpoint v1/models.

Solución: para consultar la lista de API compatibles, consulte BladeLLM service invocation parameter configurations.
Tipo de error 4: la página de depuración en línea devuelve un error 404 sin información adicional.
Causa: la ruta de la solicitud es incorrecta. Cuando usa la depuración en línea, la URL base suele ser http://123***.cn-hangzhou.pai-eas.aliyuncs.com/predict/service_name. Modificar o eliminar incorrectamente la parte del nombre del servicio en la URL provoca un error 404.

Solución: cuando usa la depuración en línea, normalmente no necesita modificar ni eliminar la URL predeterminada. Agregue la ruta específica de la API que necesita llamar.
Tipo de error 5: una llamada de API a ComfyUI devuelve **"404 not found page"**.
400 Bad Request
El formato del cuerpo de la solicitud es incorrecto. Revise cuidadosamente el formato del cuerpo de la solicitud, como la estructura JSON, los nombres de los campos y los tipos de datos.
401 Authorization Failed
El token de autenticación falta, es incorrecto o se usó de manera inadecuada. Compruebe lo siguiente:
-
Compruebe si el token es correcto. En la página Overview del servicio, haga clic en View Invocation Information dentro de la sección Basic Information.
NotaDe forma predeterminada, el servicio genera automáticamente el token de autenticación. También puede especificar un token personalizado y actualizarlo durante las actualizaciones del servicio.
-
Compruebe si el token se estableció correctamente.
Si usa el comando
curl, agregue el token al campoAuthorizationdel encabezado HTTP. Por ejemplo:curl -H 'Authorization: NWMyN2UzNjBiZmI2YT***' http:// xxx.cn-shanghai.aliyuncs.com/api/predict/echo.Si usa un SDK para acceder al servicio, llame a la función
SetToken()correspondiente. Para obtener más información, consulte Instructions for using the Java SDK.
504 timeout
El servidor, al actuar como puerta de enlace o proxy, no recibió una respuesta oportuna de un servidor ascendente. Esto suele significar que la inference del modelo está tardando demasiado. Para resolver este problema:
En el código de su cliente, aumente el tiempo de espera de la solicitud HTTP.
Para tareas de larga duración, use el modo EAS Queue Service (Asynchronous Invocation), diseñado para manejar tareas de inference por lotes o de larga duración.
450: Solicitud descartada porque la cola está llena
Cuando una instancia de cómputo del lado del servidor recibe una solicitud, primero la coloca en una cola. Cuando un worker de la instancia queda disponible, extrae datos de la cola para procesarlos. La cantidad predeterminada de workers es 5, y puede ajustarla mediante el campo metadata.rpc.worker_threads en el archivo JSON de create a service. Si el tiempo de procesamiento de los workers es demasiado largo, las solicitudes se acumulan en la cola. Cuando la cola se llena, la instancia rechaza inmediatamente las nuevas solicitudes con un código de estado 450. Esto evita que una acumulación excesiva aumente la latencia y deje el servicio no disponible. La longitud predeterminada de la cola es 64, y puede ajustarla mediante el campo metadata.rpc.max_queue_size en el archivo JSON de create a service.
Limitar la longitud de la cola también actúa como una forma de límite de velocidad para evitar que los picos de tráfico provoquen un fallo en cascada del servicio.
Soluciones:
Si recibe una cantidad pequeña de códigos de estado 450, puede reintentar la solicitud. Como las instancias del lado del servidor son independientes, un reintento podría dirigirse a una instancia menos ocupada, lo que hace que el problema sea transparente para el cliente. Sin embargo, no reintente de forma indefinida, ya que esto anularía el propósito de la protección de límite de velocidad.
Si todas las solicitudes devuelven un código de estado 450, podría indicar que el código dentro del procesador se quedó bloqueado. Si todos los workers entran en interbloqueo mientras procesan solicitudes y dejan de extraer datos de la cola, debe depurar el código del procesador para encontrar el bug.
503 no healthy upstream
Recibe un error 503 con el mensaje "no healthy upstream" durante la depuración en línea:
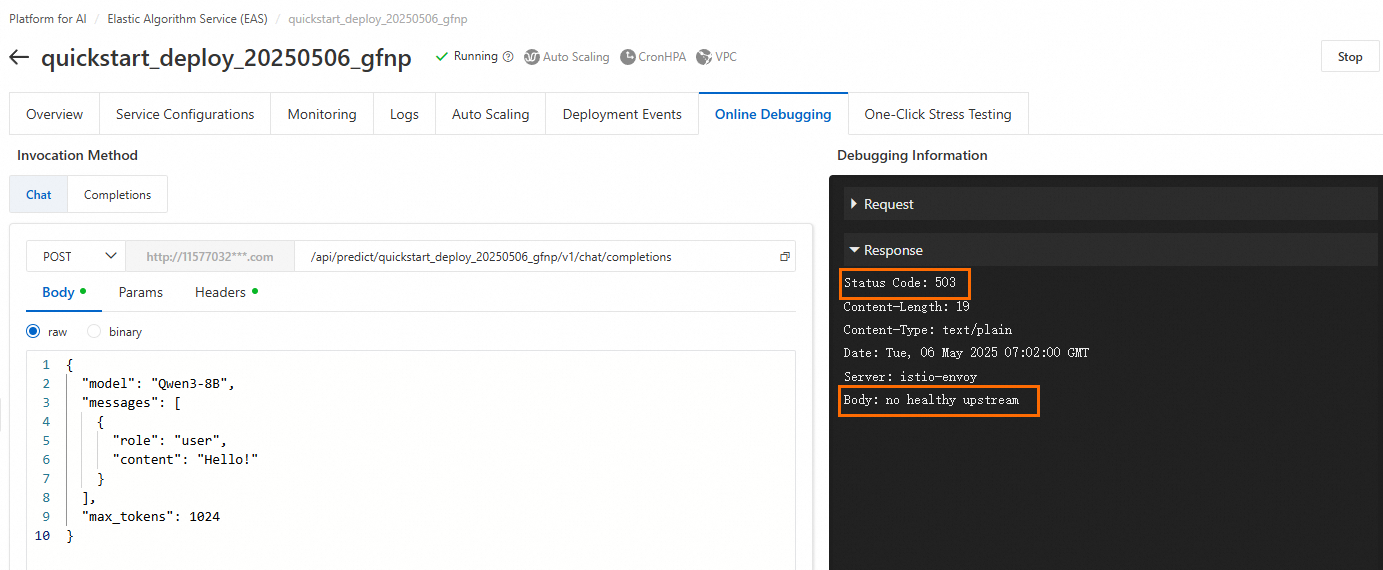
Solucione el problema de la siguiente manera:
Compruebe el estado de la instancia. Si la instancia se detuvo, reinicie el servicio.
-
Si el estado del servicio es Running, es posible que la instancia tenga recursos insuficientes, como CPU, memoria o memoria GPU, lo que provoca la falta de espacio de búfer.
Si usa recursos públicos, intente realizar la llamada nuevamente fuera de las horas pico, o cambie a una especificación de recursos o región diferente.
Si usa un recurso dedicado (EAS Resource Group), asegúrese de que el resource group haya reservado suficiente CPU, memoria y memoria GPU para la instancia. Se recomienda dejar como mínimo un 20 % de los recursos libres como búfer.
Otro escenario común ocurre cuando el estado del servicio es Running y todas las instancias están listas después del despliegue. Sin embargo, una solicitud activa un bug en el código, lo que provoca que la instancia del servicio de backend falle y deje de responder. En esta situación, la puerta de enlace devuelve un código de estado 503 al cliente. Use los registros para identificar y corregir el bug.
Error: Unexpected token 12606 while expecting start token 200006
Cuando usa vllm para desplegar gpt-oss, las llamadas al servicio podrían devolver el siguiente error:

Solución: intente desplegar con la aceleración SGLang.
Error de invocación de curl: no URL specified
Recibe un error no URL specified después de enviar una solicitud con el siguiente comando:
curl -X http://17****.cn-hangzhou.pai-eas.aliyuncs.com/api/predict/service_name/**path** \
-H "Content-Type: application/json" \
-H "Authorization: **********==" \
-d '{"***":"****"}'Causa: el comando curl usa la marca -X, pero falta el método, como POST.
La invocación devuelve codificación ASCII
Modifique su código de la siguiente manera:
from flask import Flask, Response

@app.route('/hello', methods=['POST'])
def get_advice():
    result = "result"
    return Response(result, mimetype='text/plain', charset='utf-8')
¿Cómo resolver "[WARN] connection is closed: End of file" o "Write a Invalid stream: End of file" en los registros del servicio?
Este registro de advertencia indica que el cliente o el servidor cerró la conexión, y el servidor estaba intentando escribir una respuesta en esa conexión cerrada. Una conexión puede cerrarse de dos maneras:
Tiempo de espera del lado del servidor: en el modo Processor, el tiempo de espera predeterminado del lado del servidor es de 5 segundos. Puede cambiarlo mediante el parámetro
metadata.rpc.keepalivedel servicio. Cuando se alcanza el tiempo de espera, el servidor cierra la conexión y registra un código de estado 408 en su monitoreo.Tiempo de espera del lado del cliente: la configuración de su código de llamada determina el tiempo de espera del lado del cliente. Si el cliente no recibe una respuesta HTTP dentro del período de tiempo de espera configurado, cierra la conexión de forma activa. Luego, el servidor registra un código de estado 499 en su monitoreo.
upstream connect error or disconnect/reset before headers. reset reason: connection termination
Problemas como el agotamiento del tiempo de espera de una conexión persistente o cargas desequilibradas entre instancias suelen causar este error. Si el tiempo de procesamiento del lado del servidor supera el tiempo de espera HTTP configurado en el cliente, el cliente abandona la solicitud y cierra la conexión de forma activa. Después, aparece un código de estado 499 en el monitoreo del lado del servidor. Puede revisar las métricas de monitoreo para confirmarlo. Para tareas de inference que consumen mucho tiempo, deploy an asynchronous inference service.
¿Cómo resolver fallos de depuración en línea para servicios desplegados con un procesador TensorFlow/PyTorch?
Por motivos de rendimiento, los procesadores TensorFlow/PyTorch usan un formato protobuf que no es de texto sin formato para el cuerpo de la solicitud. Actualmente, la depuración en línea solo admite entradas de texto sin formato. Por lo tanto, no puede depurar directamente en la consola los servicios desplegados con estos procesadores. Use los SDK de EAS proporcionados para llamar al servicio. Para obtener información sobre los SDK en diferentes lenguajes, consulte Service Invocation SDKs.