El componente PyAlink Script permite invocar cualquier algoritmo de Alink mediante código. Este componente es útil para realizar tareas como clasificación, regresión y recomendación. Además, PyAlink Script se integra perfectamente con otros componentes de Machine Learning Designer, lo que facilita la construcción y validación de flujos de trabajo empresariales de extremo a extremo. En este tema se describe cómo utilizar el componente PyAlink Script.
Contexto
El componente PyAlink Script puede utilizarse de dos formas: alone o combined with other Machine Learning Designer components. Proporciona acceso a cientos de componentes de Alink y admite reading from and writing to data types mediante código. También es posible desplegar un PipelineModel generado por este componente como un servicio de EAS. Para obtener más información, consulte Example: Deploy a model generated by a PyAlink Script as an EAS service.
Conceptos clave
Antes de utilizar el componente PyAlink Script, familiarícese con los siguientes conceptos clave.
|
Concepto |
Descripción |
|
operator |
En Alink, un operador representa una función algorítmica. Los operadores se clasifican en operadores por lotes (batch) o de flujo (stream). Por ejemplo, la regresión logística incluye los siguientes operadores:
Los operadores se conectan mediante los métodos Cada operador tiene parámetros. Por ejemplo, la regresión logística incluye los siguientes parámetros.
Para configurar un parámetro, utilice el prefijo Las fuentes y destinos de datos son tipos especiales de operadores. Una vez definidos, pueden conectarse a componentes algorítmicos mediante los métodos  Alink incluye fuentes de datos comunes por lotes y de flujo. El siguiente código muestra un ejemplo. |
|
pipeline |
También es posible utilizar algoritmos de Alink en un pipeline, combinando el procesamiento de datos, la generación de características y el entrenamiento de modelos en un solo flujo para entrenamiento, predicción y servicios en línea. El siguiente código muestra un ejemplo. |
|
vector |
Tipo de dato personalizado en Alink que admite dos formatos:
Nota
En Alink, si una columna es de tipo vector, el nombre del parámetro suele ser |
Componentes de Alink compatibles con PyAlink Script
Es posible utilizar cientos de componentes de Alink en un PyAlink Script, incluidos componentes para procesamiento de datos, ingeniería de características y entrenamiento de modelos.
Actualmente, el componente PyAlink Script admite componentes de pipeline y por lotes, pero no admite componentes de flujo.
Método 1: Uso independiente de PyAlink Script
Este tema utiliza un ejemplo de puntuación del conjunto de datos movielens con el modelo ItemCf para describir cómo usar la plataforma Machine Learning Designer y los recursos de Alibaba Cloud para ejecutar un flujo de trabajo implementado con PyAlink Script. El procedimiento es el siguiente.
Vaya a la página de Machine Learning Designer y cree un pipeline en blanco. Para obtener más información, consulte Procedure.
En la lista de pipelines, seleccione el pipeline en blanco que creó y haga clic en Open.
En el cuadro de búsqueda de la lista de componentes a la izquierda, busque PyAlink Script y arrastre PyAlink Script al lienzo de la derecha. Se generará automáticamente un nodo de pipeline llamado PyAlink Script-1 en el lienzo.
-
En el lienzo, seleccione el nodo PyAlink Script-1. En el panel derecho, configure los parámetros en las pestañas Parameter Settings y Execution tuning.
-
En la pestaña Parameter Settings, escriba su código. El siguiente código es un ejemplo.
from pyalink.alink import *
def main(sources, sinks, parameter):
    PATH = "http://alink-test.oss-cn-beijing.aliyuncs.com/yuhe/movielens/"
    RATING_FILE = "ratings.csv"
    PREDICT_FILE = "predict.csv"
    RATING_SCHEMA_STRING = "user_id long, item_id long, rating int, ts long"
    ratingsData = CsvSourceBatchOp() \
            .setFilePath(PATH + RATING_FILE) \
            .setFieldDelimiter("\t") \
            .setSchemaStr(RATING_SCHEMA_STRING)
    predictData = CsvSourceBatchOp() \
            .setFilePath(PATH + PREDICT_FILE) \
            .setFieldDelimiter("\t") \
            .setSchemaStr(RATING_SCHEMA_STRING)
    itemCFModel = ItemCfTrainBatchOp() \
            .setUserCol("user_id").setItemCol("item_id") \
            .setRateCol("rating").linkFrom(ratingsData);
    itemCF = ItemCfRateRecommender() \
            .setModelData(itemCFModel) \
            .setItemCol("item_id") \
            .setUserCol("user_id") \
            .setReservedCols(["user_id", "item_id"]) \
            .setRecommCol("prediction_score")
    result = itemCF.transform(predictData)
    result.link(sinks[0])
    BatchOperator.execute()
Un PyAlink Script admite cuatro puertos de salida. En el script, utilice
result.link(sinks[0])para escribir datos en el primer puerto de salida. Los componentes posteriores pueden leer los datos del script conectándose a este primer puerto de salida. Para obtener más información, consulte Reading and writing different data types in a PyAlink Script. -
En la pestaña Execution tuning, establezca el modo de ejecución y las especificaciones del nodo.
Parámetro
Descripción
Select job running mode
Se admiten los siguientes modos:
-
DLC (Single-machine, multi-concurrency): Recomendado para tareas con conjuntos de datos pequeños, así como para fines de depuración y validación.
-
MaxCompute (Distributed): Recomendado para tareas con grandes volúmenes de datos o para entornos de producción.
-
Fully-managed Flink: Ejecuta el trabajo en el clúster de Fully-managed Flink vinculado al espacio de trabajo.
Number of workers
Este parámetro es obligatorio solo cuando el job running mode es MaxCompute (Distributed) o Fully-managed Flink (Distributed). Especifica el número de nodos de ejecución. Si deja este parámetro vacío, el sistema asigna nodos automáticamente según los datos de la tarea. De forma predeterminada, este parámetro está vacío.
Memory per worker (MB)
Solo necesita configurar este parámetro cuando el running mode of the job está establecido en MaxCompute (Distributed) o Fully-managed Flink (Distributed). El parámetro especifica el tamaño de memoria de un solo nodo en MB. El valor debe ser un entero positivo; el valor predeterminado es 8192.
CPU cores per worker
Este parámetro es obligatorio solo cuando el Job running mode está establecido en MaxCompute (distributed) o Fully-managed Flink (distributed). Especifica el número de núcleos de CPU para un solo nodo. El valor debe ser un entero positivo y está vacío de forma predeterminada.
Select node specification to run script
Tipo de recurso del nodo DLC. El valor predeterminado es 2 vCPU + 8 GB Mem-ecs.g6.large.
-
-
Encima del lienzo, haga clic en Save y luego haga clic en el icono de ejecución
 para ejecutar el PyAlink Script.
-
Cuando finalice la tarea, haga clic con el botón derecho en el nodo PyAlink Script-1 del lienzo y seleccione para ver los resultados.
Nombre de columna
Descripción
user_id
ID del usuario.
item_id
ID de la película.
prediction_score
Indica la preferencia del usuario por la película. Esta puntuación se utiliza como referencia para las recomendaciones.
Método 2: Combinación de PyAlink Script con otros componentes
Los puertos de entrada y salida de un componente PyAlink Script son idénticos a los de otros componentes algorítmicos en Machine Learning Designer. Puede conectarlos para crear un pipeline combinado, como se muestra en la siguiente figura.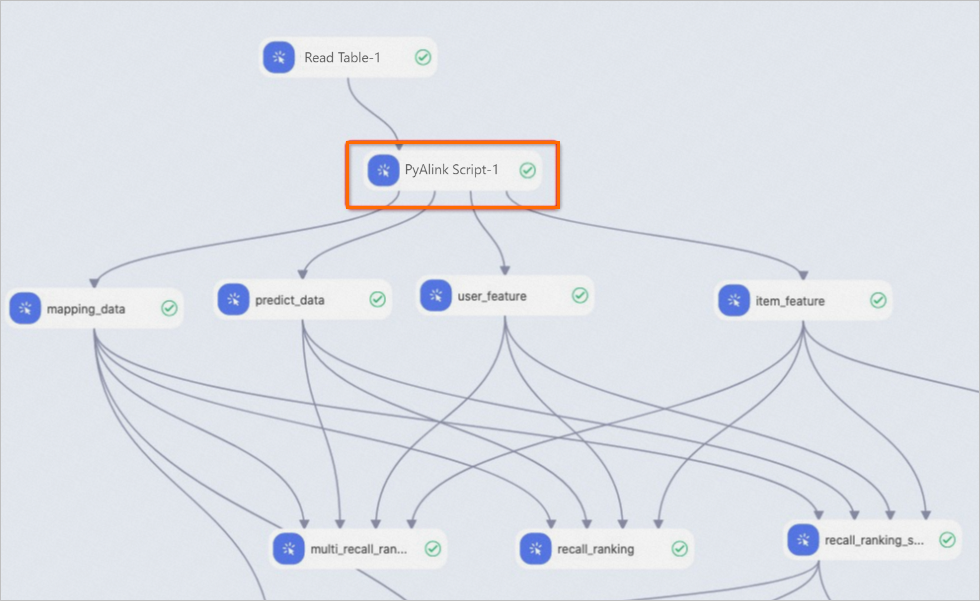
Lectura y escritura de datos en PyAlink Script
-
Lectura de datos.
-
Leer desde una tabla de MaxCompute: El script lee los datos transmitidos desde un componente anterior a través de un puerto de entrada. El siguiente código muestra un ejemplo.
train_data = sources[0]
test_data = sources[1]
En el código,
sources[0]representa la tabla de MaxCompute conectada al primer puerto de entrada, ysources[1]representa la tabla conectada al segundo puerto de entrada. El componente admite hasta cuatro puertos de entrada. -
Leer desde un sistema de archivos de red: El script lee datos utilizando componentes de origen de Alink, como
CsvSourceBatchOpyAkSourceBatchOp, dentro del código. Puede leer los siguientes tipos de archivos:-
Leer un archivo compartido desde una red mediante HTTP. El siguiente código muestra un ejemplo:
ratingsData = CsvSourceBatchOp() \ .setFilePath(PATH + RATING_FILE) \ .setFieldDelimiter("\t") \ .setSchemaStr(RATING_SCHEMA_STRING) -
Leer un archivo de OSS. Primero, localice la ruta de almacenamiento temporal de datos del pipeline en la pestaña pipeline properties. Esta ruta, con formato
oss://<bucket-name>/<path>, se utiliza para operaciones de lectura y escritura en OSS. El siguiente código muestra un ejemplo.model_data = AkSourceBatchOp().setFilePath("oss://xxxxxxxx/model_20220323.ak")
-
-
-
Escritura de datos.
-
Escribir en una tabla de MaxCompute: El script escribe datos hacia un componente posterior a través de un puerto de salida. El siguiente código muestra un ejemplo.
result0.link(sinks[0])
result1.link(sinks[1])
BatchOperator.execute()
La línea
result0.link(sinks[0])escribe datos y los hace accesibles a través del primer puerto de salida. Es posible escribir en un máximo de cuatro tablas de resultados, correspondientes a cuatro puertos de salida. -
Escribir en un archivo de OSS. Utilice la ruta de OSS definida en el campo temporary data storage path del pipeline, ubicado en la pestaña pipeline properties. El siguiente código muestra un ejemplo.
result.link(AkSinkBatchOp() \
            .setFilePath("oss://xxxxxxxx/model_20220323.ak") \
            .setOverwriteSink(True))
BatchOperator.execute()
-
Ejemplo: Despliegue de un modelo como servicio de EAS
-
Genere el modelo a desplegar.
Solo es posible desplegar un modelo como servicio de EAS si es un PipelineModel generado por el componente PyAlink Script. Utilice el siguiente código para generar un archivo PipelineModel. Para obtener instrucciones sobre cómo ejecutar el script, consulte Method 1: Use the PyAlink Script component alone.
from pyalink.alink import *
def main(sources, sinks, parameter):
    PATH = "http://alink-test.oss-cn-beijing.aliyuncs.com/yuhe/movielens/"
    RATING_FILE = "ratings.csv"
    PREDICT_FILE = "predict.csv"
    RATING_SCHEMA_STRING = "user_id long, item_id long, rating int, ts long"
    ratingsData = CsvSourceBatchOp() \
            .setFilePath(PATH + RATING_FILE) \
            .setFieldDelimiter("\t") \
            .setSchemaStr(RATING_SCHEMA_STRING)
    predictData = CsvSourceBatchOp() \
            .setFilePath(PATH + PREDICT_FILE) \
            .setFieldDelimiter("\t") \
            .setSchemaStr(RATING_SCHEMA_STRING)
    itemCFModel = ItemCfTrainBatchOp() \
            .setUserCol("user_id").setItemCol("item_id") \
            .setRateCol("rating").linkFrom(ratingsData);
    itemCF = ItemCfRateRecommender() \
            .setModelData(itemCFModel) \
            .setItemCol("item_id") \
            .setUserCol("user_id") \
            .setReservedCols(["user_id", "item_id"]) \
            .setRecommCol("prediction_score")
    model = PipelineModel(itemCF)
    model.save().link(AkSinkBatchOp() \
            .setFilePath("oss://<your_bucket_name>/model.ak") \
            .setOverwriteSink(True))
    BatchOperator.execute()
Reemplace
<your_bucket_name>con el nombre de su bucket de OSS.ImportanteAsegúrese de tener permisos de lectura para la ruta del conjunto de datos configurada en PATH. De lo contrario, el componente fallará al ejecutarse.
-
Genere un archivo de configuración de EAS.
Ejecute el siguiente script para escribir la salida en un archivo
config.json.# EAS configuration file import json # Generate EAS model configuration model_config = {} # Schema of the data that EAS receives model_config['inputDataSchema'] = "id long, movieid long" model_config['modelVersion'] = "v0.2" eas_config = { "name": "recomm_demo", "model_path": "http://xxxxxxxx/model.ak", "processor": "alink_outer_processor", "metadata": { "instance": 1, "memory": 2048, "region":"China (Beijing)" }, "model_config": model_config } print(json.dumps(eas_config, indent=4))Parámetros clave en el archivo
config.json:name: Nombre del servicio de modelo desplegado.model_path: Ruta de OSS donde se almacena el archivo PipelineModel. Debe cambiar esto por la ruta real de OSS de su archivo de modelo.
Para obtener una explicación de otros parámetros en el archivo
config.json, consulte Command reference. -
Despliegue el modelo como un servicio de EAS.
Despliegue el modelo utilizando el cliente eascmd. Para obtener instrucciones sobre la configuración del cliente, consulte Download and configure the client. Por ejemplo, en un sistema Windows de 64 bits, ejecute este comando:
eascmdwin64.exe create config.json