El componente Prediction aplica un modelo entrenado a nuevos datos y escribe los resultados en una tabla de salida. Utilícelo cuando su modelo se haya entrenado con un componente tradicional de minería de datos que no cuenta con un componente de predicción asociado.
Requisitos previos
Antes de empezar, asegúrese de contar con:
Un modelo entrenado en Machine Learning Designer
Una tabla de entrada con las columnas de características que requiere el modelo
Configurar el componente
Método 1: Configuración en Machine Learning Designer
En el lienzo del pipeline de la consola de Machine Learning Platform for AI (PAI), seleccione el componente Prediction y configure los siguientes parámetros.
Pestaña Fields Setting
|
Parámetro |
Descripción |
|
Feature columns |
Columnas de características seleccionadas de la tabla de entrada. De forma predeterminada, se seleccionan todas las columnas. |
|
Reserved columns |
Columnas que se conservarán en la tabla de salida. Incluya la columna de etiqueta para facilitar la evaluación posterior. |
|
Output result column |
Columna de salida que contiene el resultado principal de la predicción. |
|
Output score column |
Columna de salida que contiene la probabilidad del resultado principal de la predicción. |
|
Output detail column |
Columna de salida que contiene todos los resultados posibles y sus probabilidades. |
|
Sparse matrix |
Habilite esta opción si los datos de entrada están en formato disperso (pares clave-valor). |
|
KV delimiter |
Delimitador entre claves y valores en datos dispersos. Valor predeterminado: dos puntos ( |
|
KV pair delimiter |
Delimitador entre pares clave-valor en datos dispersos. Valor predeterminado: coma ( |
Pestaña Tuning
|
Parámetro |
Descripción |
|
Cores |
Número de núcleos. Debe ser un entero positivo. Utilice este parámetro junto con Memory size per core. |
|
Memory size per core |
Memoria por núcleo, en MB. Utilice este parámetro junto con Cores. |
Método 2: Ejecución de un comando de PAI
Ejecute el siguiente comando mediante el componente SQL Script:
pai -name prediction
    -DmodelName=nb_model
    -DinputTableName=wpbc
    -DoutputTableName=wpbc_pred
    -DappendColNames=label;
Parámetros
|
Parámetro |
Obligatorio |
Descripción |
Valor predeterminado |
|
|
Sí |
Nombre de la tabla de entrada. |
— |
|
|
Sí |
Nombre del modelo entrenado. |
— |
|
|
Sí |
Nombre de la tabla de salida. |
— |
|
|
No |
Columnas de características de la tabla de entrada, separadas por comas. |
Todas las columnas |
|
|
No |
Columnas de entrada que se agregarán a la tabla de salida. |
Ninguna |
|
|
No |
Particiones que se leerán de la tabla de entrada. Formatos compatibles: |
Tabla completa |
|
|
No |
Partición donde se escribirán los resultados en la tabla de salida. |
Ninguna |
|
|
No |
Columna de salida para el resultado principal de la predicción. |
|
|
|
No |
Columna de salida para la probabilidad del resultado principal de la predicción. |
|
|
|
No |
Columna de salida para todos los resultados posibles y sus probabilidades. |
|
|
|
No |
Indica si los datos de entrada son dispersos. Valores válidos: |
|
|
|
No |
Delimitador entre pares clave-valor dispersos. |
|
|
|
No |
Delimitador entre claves y valores dispersos. |
|
|
|
No |
Ciclo de vida de la tabla de salida. |
Ninguna |
|
|
No |
Número de núcleos. |
Asignado automáticamente |
|
|
No |
Memoria por núcleo, en MB. |
Asignado automáticamente |
Ejemplo
Este ejemplo crea un clasificador de bosque aleatorio y ejecuta Prediction sobre los mismos datos.
-
Cree la tabla de entrada de prueba:
create table pai_rf_test_input as select * from ( select 1 as f0,2 as f1, "good" as class union all select 1 as f0,3 as f1, "good" as class union all select 1 as f0,4 as f1, "bad" as class union all select 0 as f0,3 as f1, "good" as class union all select 0 as f0,4 as f1, "bad" as class )tmp; -
Entrene el modelo con el algoritmo de bosque aleatorio:
PAI -name randomforests -project algo_public -DinputTableName="pai_rf_test_input" -DmodelName="pai_rf_test_model" -DforceCategorical="f1" -DlabelColName="class" -DfeatureColNames="f0,f1" -DmaxRecordSize="100000" -DminNumPer="0" -DminNumObj="2" -DtreeNum="3"; -
Ejecute Prediction con el modelo entrenado:
PAI -name prediction -project algo_public -DinputTableName=pai_rf_test_input -DmodelName=pai_rf_test_model -DresultColName=prediction_result -DscoreColName=prediction_score -DdetailColName=prediction_detail -DoutputTableName=pai_temp_2283_76333_1 -
Consulte la tabla de salida
pai_temp_2283_76333_1: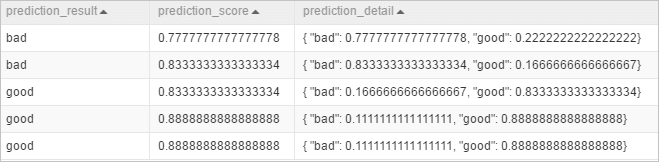
La tabla de salida contiene tres columnas:
prediction_result: el resultado principal de la predicción (la clase con mayor probabilidad). En este ejemplo, el valor esgoodobad.prediction_score: la probabilidad del resultado principal de la predicción. En este ejemplo, el resultado puede ser good o bad según cuál tenga mayor probabilidad;prediction_scorealmacena la probabilidad más alta.prediction_detail: todos los resultados posibles junto con sus probabilidades.