Una máquina de vectores de soporte (SVM) es un método de aprendizaje automático basado en la teoría del aprendizaje estadístico. Mejora la capacidad de generalización de un modelo mediante la minimización del riesgo estructural, lo cual equilibra el riesgo empírico y el intervalo de confianza. Este tema explica cómo configurar el componente Linear SVM e incluye un ejemplo de uso.
Contexto
Este algoritmo Linear SVM se implementa sin utilizar una función de kernel. Para obtener detalles sobre la implementación, consulte la sección "trust region method for L2-SVM" en principios del algoritmo.
Limitaciones
El componente Linear SVM solo admite clasificación binaria.
Configuración del componente
Puede configurar los parámetros del componente Linear SVM mediante uno de los siguientes métodos.
Método 1: Configuración visual
-
Puerto de entrada
El componente Linear SVM tiene un puerto de entrada obligatorio que debe conectarse a un componente Read Table.
-
Configure los parámetros del componente en la página del flujo de trabajo.
Tipo de parámetro
Parámetro
Obligatorio
Descripción
Configuración de campos
Columnas de características
Sí
Las columnas de características para el entrenamiento del modelo. Tipos de datos compatibles: BIGINT y DOUBLE.
Columna de etiquetas
Sí
La columna de etiquetas para el entrenamiento del modelo. Tipos de datos compatibles: BIGINT, DOUBLE y STRING.
Configuración de parámetros
Valor de etiqueta de muestra positiva
No
El valor que representa una muestra positiva. Si no se especifica este parámetro, se selecciona aleatoriamente un valor de la columna de etiquetas. Se recomienda especificar este parámetro para conjuntos de datos desequilibrados.
Factor de penalización positiva
No
El peso para las muestras positivas. El valor predeterminado es 1.0 y el rango de valores es (0, +∞).
Factor de penalización negativa
No
El peso de la muestra negativa tiene un valor predeterminado de 1.0 y un rango de valores de (0, +∞).
Coeficiente de convergencia
No
Error de convergencia. El valor predeterminado es 0.001. El rango de valores es (0, 1).
Ajuste de ejecución
Número de núcleos
No
Si no se especifica, el sistema asigna los recursos automáticamente.
Memoria por núcleo
No
El tamaño de memoria para cada núcleo, en MB. Si no se especifica, el sistema asigna los recursos automáticamente.
-
Puerto de salida
Genera un modelo de clasificación binaria en formato OfflineModel. La salida de este componente se conecta a un componente Prediction.
Método 2: Comando PAI
Puede configurar los parámetros del componente al ejecutar un comando PAI en un componente SQL Script. Para más información, consulte SQL Script.
PAI -name LinearSVM -project algo_public
    -DinputTableName="bank_data"
    -DmodelName="xlab_m_LinearSVM_6143"
    -DfeatureColNames="pdays,emp_var_rate,cons_conf_idx"
    -DlabelColName="y"
    -DpositiveLabel="0"
    -DpositiveCost="1.0"
    -DnegativeCost="1.0"
    -Depsilon="0.001";
A continuación se describen los parámetros del comando PAI.
|
Parámetro |
Obligatorio |
Predeterminado |
Descripción |
|
inputTableName |
Sí |
N/A |
El nombre de la tabla de entrada. |
|
inputTablePartitions |
No |
Todas las particiones de la tabla de entrada. |
Las particiones de la tabla de entrada para el entrenamiento. Se admiten los siguientes formatos:
Nota
Para especificar varias particiones, sepárelas con comas (,). |
|
modelName |
Sí |
N/A |
El nombre del modelo de salida. |
|
featureColNames |
Sí |
N/A |
Los nombres de las columnas de características en la tabla de entrada. |
|
labelColName |
Sí |
N/A |
El nombre de la columna de etiquetas en la tabla de entrada. |
|
positiveLabel |
No |
Se selecciona aleatoriamente un valor de la columna label. |
El valor que representa una muestra positiva. |
|
positiveCost |
No |
1.0 |
El peso de la clase positiva, también conocido como factor de penalización positiva. El valor debe estar en el rango (0, +∞). |
|
negativeCost |
No |
1.0 |
El peso de la clase negativa, también conocido como factor de penalización negativa. El valor debe estar en el rango (0, +∞). |
|
epsilon |
No |
0.001 |
El coeficiente de convergencia. El valor debe estar en el rango (0,1). |
|
enableSparse |
No |
false |
Especifica si los datos de entrada están en formato disperso. Valores válidos: true y false. |
|
itemDelimiter |
No |
, (coma) |
El delimitador entre pares KV cuando los datos de la tabla de entrada están en formato disperso. |
|
kvDelimiter |
No |
: (dos puntos) |
El delimitador entre key y value cuando los datos de la tabla de entrada están en formato disperso. |
|
coreNum |
No |
Asignado por el sistema |
El número de núcleos de cómputo. El valor debe ser un entero positivo. |
|
memSizePerCore |
No |
Asignado por el sistema |
El tamaño de memoria para cada núcleo, en MB. El valor debe ser un entero en el rango [1, 65536]. |
Ejemplo
-
Importe los siguientes datos de entrenamiento.
id
y
f0
f1
f2
f3
f4
f5
f6
f7
1
-1
-0.294118
0.487437
0.180328
-0.292929
-1
0.00149028
-0.53117
-0.0333333
2
+1
-0.882353
-0.145729
0.0819672
-0.414141
-1
-0.207153
-0.766866
-0.666667
3
-1
-0.0588235
0.839196
0.0491803
-1
-1
-0.305514
-0.492741
-0.633333
4
+1
-0.882353
-0.105528
0.0819672
-0.535354
-0.777778
-0.162444
-0.923997
-1
5
-1
-1
0.376884
-0.344262
-0.292929
-0.602837
0.28465
0.887276
-0.6
6
+1
-0.411765
0.165829
0.213115
-1
-1
-0.23696
-0.894962
-0.7
7
-1
-0.647059
-0.21608
-0.180328
-0.353535
-0.791962
-0.0760059
-0.854825
-0.833333
8
+1
0.176471
0.155779
-1
-1
-1
0.052161
-0.952178
-0.733333
9
-1
-0.764706
0.979899
0.147541
-0.0909091
0.283688
-0.0909091
-0.931682
0.0666667
10
-1
-0.0588235
0.256281
0.57377
-1
-1
-1
-0.868488
0.1
-
Importe los siguientes datos de prueba.
id
y
f0
f1
f2
f3
f4
f5
f6
f7
1
+1
-0.882353
0.0854271
0.442623
-0.616162
-1
-0.19225
-0.725021
-0.9
2
+1
-0.294118
-0.0351759
-1
-1
-1
-0.293592
-0.904355
-0.766667
3
+1
-0.882353
0.246231
0.213115
-0.272727
-1
-0.171386
-0.981213
-0.7
4
-1
-0.176471
0.507538
0.278689
-0.414141
-0.702128
0.0491804
-0.475662
0.1
5
-1
-0.529412
0.839196
-1
-1
-1
-0.153502
-0.885568
-0.5
6
+1
-0.882353
0.246231
-0.0163934
-0.353535
-1
0.0670641
-0.627669
-1
7
-1
-0.882353
0.819095
0.278689
-0.151515
-0.307329
0.19225
0.00768574
-0.966667
8
+1
-0.882353
-0.0753769
0.0163934
-0.494949
-0.903073
-0.418778
-0.654996
-0.866667
9
+1
-1
0.527638
0.344262
-0.212121
-0.356974
0.23696
-0.836038
-0.8
10
+1
-0.882353
0.115578
0.0163934
-0.737374
-0.56974
-0.28465
-0.948762
-0.933333
-
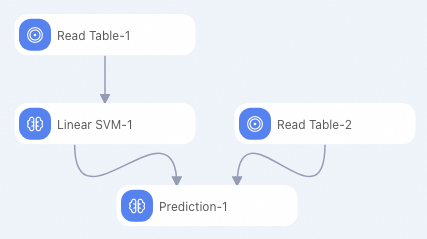
Cree un pipeline como se muestra en la siguiente figura. Para más información, consulte algorithm modeling.
-
Configure los parámetros del componente Linear SVM como se muestra en la siguiente tabla. Mantenga los valores predeterminados para todos los demás parámetros.
Tipo de parámetro
Parámetro
Descripción
Fields Setting
Feature Columns
Seleccione las columnas f0, f1, f2, f3, f4, f5, f6 y f7.
Label Column
Seleccione la columna y.
Ejecute el pipeline y consulte los resultados de la predicción. Una vez completada la predicción, la salida muestra los resultados de clasificación binaria para las 10 filas de datos de prueba en cinco columnas: id, y (etiqueta real), prediction_result (etiqueta predicha: +1 o -1), prediction_score y prediction_detail (detalles de puntuación para las clases +1 y -1, en formato JSON).