El componente Linear Model Feature Importance calcula la importancia de las características para modelos lineales, lo que incluye regresión lineal y regresión logística para clasificación binaria. Es compatible con formatos de datos dispersos y densos. Este tema describe cómo configurar el componente.
Limitaciones
El motor de computación compatible es MaxCompute.
Configuración del componente
Configure los parámetros del componente Linear Model Feature Importance mediante uno de los siguientes métodos.
Método 1: Interfaz visual
Configure los parámetros del componente en la página de pipeline de Machine Learning Designer.
|
Pestaña |
Parámetro |
Descripción |
|
Fields Setting |
Feature Columns |
Columnas de características de la tabla de entrada que se usarán para el entrenamiento. Este parámetro es opcional. De forma predeterminada, se utilizan todas las columnas excepto la columna de etiqueta. |
|
Target Column |
Obligatorio. Haga clic en Select Fields para seleccionar la columna de etiqueta. |
|
|
Input table data is in sparse format |
Opcional. |
|
|
Tuning |
Number of Cores |
Número de núcleos para la computación. Opcional. |
|
Memory per Core (MB) |
Cantidad de memoria por núcleo, en MB. Opcional. |
Método 2: Comando de PAI
Configure los parámetros del componente al ejecutar un comando de PAI en el componente SQL Script. Para obtener más información, consulte SQL Script.
PAI -name regression_feature_importance -project algo_public
    -DmodelName=xlab_m_logisticregressi_20317_v0
    -DoutputTableName=pai_temp_2252_20321_1
    -DlabelColName=y
    -DfeatureColNames=pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign
-DenableSparse=false -DinputTableName=pai_dense_10_9;|
Parámetro |
Obligatorio |
Descripción |
Valor predeterminado |
|
inputTableName |
Sí |
Nombre de la tabla de entrada. |
Ninguna |
|
outputTableName |
Sí |
Nombre de la tabla de salida. |
Ninguna |
|
labelColName |
Sí |
Nombre de la columna de etiqueta en la tabla de entrada. |
Ninguna |
|
modelName |
Sí |
Nombre del modelo de entrada. |
Ninguna |
|
featureColNames |
No |
Columnas de características que se seleccionarán de la tabla de entrada. |
Todas las columnas excepto la columna de etiqueta. |
|
inputTablePartitions |
No |
Particiones que se usarán de la tabla de entrada. |
Toda la tabla. |
|
enableSparse |
No |
Especifica si los datos de entrada tienen formato disperso. |
false |
|
itemDelimiter |
No |
Delimitador entre pares clave-valor para datos de entrada en formato disperso. |
Espacio |
|
kvDelimiter |
No |
Delimitador entre una clave y su valor para datos de entrada en formato disperso. |
Dos puntos (:) |
|
lifecycle |
No |
Ciclo de vida de la tabla de salida, en días. |
No especificado |
|
coreNum |
No |
Número de núcleos. |
Automático |
|
memSizePerCore |
No |
Cantidad de memoria por núcleo, en MB. |
Automático |
Ejemplo
Cree una tabla llamada
bank_datae importe datos en ella. Para obtener más información, consulte Create a table y Import data.-
Ejecute la siguiente sentencia SQL para generar datos de entrenamiento.
create table if not exists pai_dense_10_9 as select age,campaign,pdays, previous, emp_var_rate, cons_price_idx, cons_conf_idx, euribor3m, nr_employed, fixed_deposit from bank_data limit 10; -
Construya y ejecute un pipeline. Para obtener más información, consulte Algorithm modeling. Para conectar los componentes, vincule la salida de Read Table-1 a las entradas de Logistic Regression for Multiclass Classification y Linear Model Feature Importance. Después, conecte la salida de Logistic Regression for Multiclass Classification a la entrada de Linear Model Feature Importance.
Arrastre los componentes Read Table, Logistic Regression for Multiclass Classification y Linear Model Feature Importance desde la lista de componentes en Machine Learning Designer hacia el lienzo.
Conecte los componentes para construir el pipeline.
-
Configure los parámetros de cada componente.
En el lienzo, haga clic en el componente Read Table-1. En el panel derecho, dentro de la pestaña Select Table, establezca Table Name como
bank_data.En el lienzo, haga clic en el componente Logistic Regression for Multiclass Classification-1. En el panel derecho, dentro de la pestaña Fields Setting, configure Feature Columns con
age,campaign,pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3mynr_employed. Establezca Target Column comofixed_deposit. Use los valores predeterminados para los demás parámetros.En el lienzo, haga clic en el componente Linear Model Feature Importance-1. En el panel derecho, dentro de la pestaña Fields Setting, establezca Target Column como
fixed_deposit. Use los valores predeterminados para los demás parámetros.
Una vez configurados los parámetros, haga clic en el botón Run
 .
-
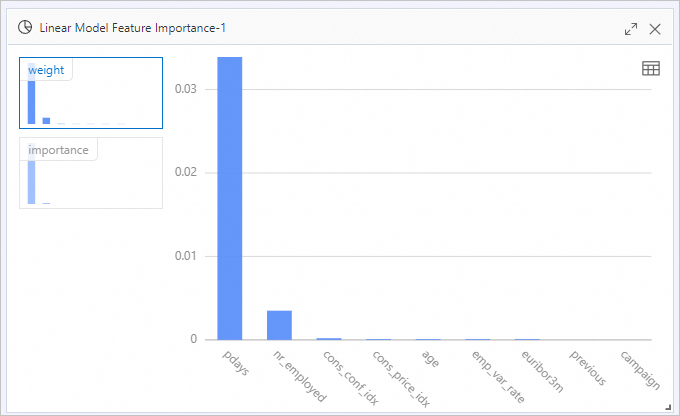
Cuando el pipeline se ejecute correctamente, haga clic con el botón derecho en el componente Linear Model Feature Importance-1 y seleccione . El componente Linear Model Feature Importance genera una tabla que muestra colname, weight e importance de cada característica. Los valores se presentan en notación científica. Por ejemplo, el peso de la característica
agees9.61816270808075E-5.Las fórmulas de las métricas son las siguientes.
Nombre de columna
Fórmula
weight
abs(w_)
importance
abs(w_j) * STD(f_i)
Notaabs(w_j)es el valor absoluto del coeficiente de la característica ySTD(f_i)es la desviación estándar de los datos de entrenamiento. Haga clic con el botón derecho en el componente Linear Model Feature Importance-1 y seleccione View Analytics Report.
Documentos relacionados
Para obtener más información sobre los componentes de Machine Learning Designer, consulte Overview of Machine Learning Designer.
Para explorar otros componentes de algoritmos integrados según su caso de uso, consulte Component Reference: All Components.