K-means Clustering es un algoritmo de aprendizaje no supervisado que divide un conjunto de datos en K clústeres mediante la minimización de la suma de errores cuadráticos (SSE) dentro de cada clúster. El algoritmo asigna iterativamente los puntos de datos al centroide del clúster más cercano y luego recalcula las posiciones de los centroides hasta que las asignaciones se estabilizan o se alcanza el número máximo de iteraciones.
Funcionamiento
Seleccione los centroides iniciales. Tome una muestra aleatoria de K puntos de datos como centroides iniciales o utilice uno de los métodos de inicialización compatibles (aleatorio, topk, k-means++, uniforme o una tabla de centroides externa).
Asigne los puntos de datos a los clústeres. Calcule la distancia desde cada punto de datos hasta cada centroide y asigne cada punto al centroide más cercano.
Actualice los centroides. Recalcule la posición de cada centroide como el promedio de todos los puntos asignados a ese clúster.
Repita hasta la convergencia. Repita los pasos 2 y 3 hasta que el valor de la función objetivo cambie menos que el umbral de convergencia entre iteraciones, o hasta alcanzar el número máximo de iteraciones.
K-means Clustering trata los puntos de datos como vectores espaciales. Se admiten columnas de tipo INT o DOUBLE. Cuando la entrada tiene formato disperso, también se admiten columnas de tipo STRING.
Configuración del componente
Método 1: Configurar en Machine Learning Designer
En la página de detalles del pipeline en Machine Learning Designer, agregue el componente K-means Clustering al pipeline y configure los siguientes parámetros.
| Pestaña | Parámetro | Descripción |
|---|---|---|
| Fields Setting | Feature Columns | Columnas de la tabla de entrada utilizadas para el entrenamiento. Separe los nombres de las columnas con comas (,). Se admiten los tipos INT y DOUBLE. Para entradas dispersas, también se admite el tipo STRING. |
| Appended Columns | Columnas de entrada que se agregarán a la tabla de resultados del clúster. Separe los nombres de las columnas con comas (,). | |
| Input Sparse Matrix | Indica si los datos de entrada tienen formato disperso. Los datos dispersos se representan como pares clave-valor. | |
| KV Pair Delimiter | Delimitador entre pares clave-valor. Valor predeterminado: coma (,). | |
| KV Delimiter | Delimitador entre claves y valores dentro de un par. Valor predeterminado: dos puntos (:). | |
| Parameters Setting | Clusters | Número de centroides del clúster. Valores válidos: 1–1000. |
| Distance Measurement Method | Métrica de distancia. Valores válidos: Euclidean, Cosine, Cityblock. | |
| Centroid Initialization Method | Método para inicializar centroides. Valores válidos: Random, First K, Uniform, K-means++, Use Initial Centroid Table. | |
| Maximum Iterations | Número máximo de iteraciones. Valores válidos: 1–1000. | |
| Convergence Criteria | Umbral para detener las iteraciones. El algoritmo se detiene cuando la diferencia de la función objetivo entre dos iteraciones consecutivas cae por debajo de este valor. | |
| Initial Random Seed | Semilla para la inicialización aleatoria. Valor predeterminado: hora actual. Establezca un valor fijo para obtener resultados estables y reproducibles. | |
| Tuning | Cores | Número de núcleos de cómputo. Valor predeterminado: determinado por el sistema. |
| Memory Size per Core | Memoria por núcleo. Unidad: MB. |
Método 2: Usar comandos de PAI
Pase los parámetros mediante comandos de PAI. Utilice el componente SQL Script para ejecutar comandos de PAI. Para obtener más información, consulte Scenario 4: Execute PAI commands within the SQL script component.
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=random
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
-DcenterTableName=pai_kmeans_test_output_center;|
**Parámetro** |
**Obligatorio** |
**Valor predeterminado** |
**Descripción** |
||
|
|
Sí |
— |
Nombre de la tabla de entrada. |
||
|
|
No |
Todas las columnas |
Columnas de la tabla de entrada utilizadas para el entrenamiento. Separe los nombres de las columnas con comas (,). Se admiten los tipos INT y DOUBLE. Para entradas dispersas, también se admite el tipo STRING. |
||
|
|
No |
Todas las particiones |
Particiones de la tabla de entrada utilizadas para el entrenamiento. Formatos admitidos: |
||
|
|
No |
— |
Columnas de entrada que se agregarán a la tabla de resultados del clúster. Separe los nombres de las columnas con comas (,). |
||
|
|
No |
|
Indica si los datos de entrada tienen formato disperso. Valores válidos: |
||
|
|
No |
|
Delimitador entre pares clave-valor. |
||
|
|
No |
|
Delimitador entre claves y valores dentro de un par. |
||
|
|
Sí |
10 |
Número de centroides del clúster. Valores válidos: 1–1000. |
||
|
|
No |
|
Métrica de distancia. Valores válidos: |
x - c |
` |
|
|
No |
|
Método de inicialización de centroides. Valores válidos:- |
||
|
|
No |
— |
Nombre de la tabla que contiene los centroides iniciales. Solo tiene efecto cuando |
||
|
|
No |
100 |
Número máximo de iteraciones. Valores válidos: 1–1000. |
||
|
|
No |
0.1 |
Umbral de convergencia. El algoritmo se detiene cuando la diferencia de la función objetivo entre dos iteraciones consecutivas es menor que este valor. |
||
|
|
No |
Hora actual |
Semilla aleatoria inicial. Establezca un valor fijo para obtener resultados estables y reproducibles. |
||
|
|
No |
— |
Nombre del modelo sin conexión de salida. |
||
|
|
Sí |
— |
Nombre de la tabla de resultados del clúster, que contiene la asignación de clúster para cada registro. |
||
|
|
No |
— |
Partición en la tabla de resultados del clúster. |
||
|
|
No |
— |
Nombre de la tabla de estadísticas del clúster, que contiene el número de puntos de datos en cada clúster. |
||
|
|
No |
— |
Nombre de la tabla de centroides del clúster. |
||
|
|
No |
Valor predeterminado del sistema |
Número de núcleos de cómputo. Valores válidos: 1–9999. Debe especificarse junto con |
||
|
|
No |
Valor predeterminado del sistema |
Memoria por núcleo. Valores válidos: 1024–65536. Unidad: MB. |
||
|
|
No |
— |
Ciclo de vida de la tabla de salida. Unidad: días. |
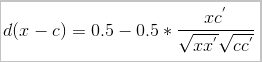 - Cityblock (distancia de Manhattan):
Salida
El componente genera tres tablas de salida.
Tabla de resultados del clúster (idxTableName)
|
Columna |
Descripción |
|
|
Columnas agregadas de la tabla de entrada. |
|
|
ID del clúster asignado a cada punto de datos. |
|
|
Distancia desde cada punto de datos hasta el centroide de su clúster asignado. |
Tabla de estadísticas del clúster (clusterCountTableName)
|
Columna |
Descripción |
|
|
ID del clúster. |
|
|
Número de puntos de datos en el clúster. |
Tabla de centroides del clúster (centerTableName)
|
Columna |
Descripción |
|
|
ID del clúster. |
|
|
Coordenadas del centroide para cada columna de función seleccionada durante el entrenamiento. |
Ejemplos
Entrada densa
Paso 1: Cree datos de prueba.
Cree una tabla opcional de centroides iniciales:
create table pai_kmeans_test_init_center as
select * from
(
  select 1 as f0, 2 as f1
  union all
  select 1 as f0, 3 as f1
  union all
  select 1 as f0, 4 as f1
) tmp;
Cree la tabla de entrada:
create table pai_kmeans_test_input as
select * from
(
  select 'id1' as id, 1 as f0, 2 as f1
  union all
  select 'id2' as id, 1 as f0, 3 as f1
  union all
  select 'id3' as id, 1 as f0, 4 as f1
  union all
  select 'id4' as id, 0 as f0, 3 as f1
  union all
  select 'id5' as id, 0 as f0, 4 as f1
) tmp;
Paso 2: Envíe el trabajo de clústeres.
Con una tabla de centroides externa:
drop table if exists pai_kmeans_test_output_idx;
yes
drop table if exists pai_kmeans_test_output_couter;
yes
drop table if exists pai_kmeans_test_output_center;
yes
drop offlinemodel if exists pai_kmeans_test_output_model_;
yes
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DinitCenterTableName=pai_kmeans_test_init_center
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=external
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
    -DcenterTableName=pai_kmeans_test_output_center;
Con centroides iniciales seleccionados aleatoriamente:
drop table if exists pai_kmeans_test_output_idx;
yes
drop table if exists pai_kmeans_test_output_couter;
yes
drop table if exists pai_kmeans_test_output_center;
yes
drop offlinemodel if exists pai_kmeans_test_output_model_;
yes
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=random
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
    -DcenterTableName=pai_kmeans_test_output_center;
Paso 3: Consulte los resultados.
Tabla de resultados del clúster (idxTableName):
+------------+------------+---------------+------------+
| f0         | f1         | cluster_index | distance   |
+------------+------------+---------------+------------+
| 1          | 2          | 0             | 0.0        |
| 1          | 3          | 1             | 0.5        |
| 1          | 4          | 2             | 0.5        |
| 0          | 3          | 1             | 0.5        |
| 0          | 4          | 2             | 0.5        |
+------------+------------+---------------+------------+
Tabla de estadísticas del clúster (clusterCountTableName):
+---------------+---------------+
| cluster_index | cluster_count |
+---------------+---------------+
| 0             | 1             |
| 1             | 2             |
| 2             | 2             |
+---------------+---------------+
Tabla de centroides del clúster (centerTableName):
+---------------+------------+------------+
| cluster_index | f0         | f1         |
+---------------+------------+------------+
| 0             | 1.0        | 2.0        |
| 1             | 0.5        | 3.0        |
| 2             | 0.5        | 4.0        |
+---------------+------------+------------+
Entrada dispersa
Paso 1: Cree datos de prueba.
create table pai_kmeans_test_sparse_input as
select * from
(
  select 1 as id, "s1" as id_s, "0:0.1,1:0.2" as kvs0, "2:0.3,3:0.4" as kvs1
  union all
  select 2 as id, "s2" as id_s, "0:1.1,2:1.2" as kvs0, "4:1.3,5:1.4" as kvs1
  union all
  select 3 as id, "s3" as id_s, "0:2.1,3:2.2" as kvs0, "6:2.3,7:2.4" as kvs1
  union all
  select 4 as id, "s4" as id_s, "0:3.1,4:3.2" as kvs0, "8:3.3,9:3.4" as kvs1
  union all
  select 5 as id, "s5" as id_s, "0:5.1,5:5.2" as kvs0, "10:5.3,6:5.4" as kvs1
) tmp;
Cuando se usan varias columnas dispersas como entrada, estas se fusionan. Por ejemplo, cuando se seleccionan tanto kvs0 como kvs1, la primera fila se expande a:
0:0.1,1:0.2,2:0.3,3:0.4,4:0,5:0,6:0,7:0,8:0,9:0,10:0Los valores faltantes se rellenan con 0. La matriz dispersa resultante tiene 5 filas y 11 columnas (indexadas de 0 a 10). Si un ID de columna es grande (por ejemplo, 123456789:0.1), las dimensiones de la matriz crecen proporcionalmente, lo que consume una cantidad significativa de CPU y memoria. Renumerar las columnas secuencialmente desde 0 o 1 reduce el tamaño de la matriz.
Paso 2: Envíe el trabajo de clústeres.
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_sparse_input
    -DenableSparse=true
    -DselectedColNames=kvs0,kvs1
    -DappendColNames=id,id_s
    -DitemDelimiter=,
    -DkvDelimiter=:
    -DcenterCount=3
    -Dloop=100
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=topk
    -Dseed=1
    -DmodelName=pai_kmeans_test_input_sparse_output_model
    -DidxTableName=pai_kmeans_test_sparse_output_idx
    -DclusterCountTableName=pai_kmeans_test_sparse_output_couter
    -DcenterTableName=pai_kmeans_test_sparse_output_center;
Paso 3: Consulte los resultados.
Tabla de resultados del clúster (idxTableName):
+------------+------------+---------------+---------------------------+
| id         | id_s       | cluster_index | distance                  |
+------------+------------+---------------+---------------------------+
| 4          | s4         | 0             | 2.90215437218629          |
| 5          | s5         | 1             | 0.0                       |
| 1          | s1         | 2             | 0.7088723439378913        |
| 2          | s2         | 2             | 1.1683321445547923        |
| 3          | s3         | 0             | 2.0548722588034516        |
+------------+------------+---------------+---------------------------+
Tabla de estadísticas del clúster (clusterCountTableName):
+---------------+---------------+
| cluster_index | cluster_count |
+---------------+---------------+
| 0             | 2             |
| 1             | 1             |
| 2             | 2             |
+---------------+---------------+
Tabla de centroides del clúster (centerTableName):
+---------------+----------------------------------------+----------------------------------+
| cluster_index | kvs0                                   | kvs1                             |
+---------------+----------------------------------------+----------------------------------+
| 0             | 0:2.6,1:0,2:0,3:1.1,4:1.6,5:0         | 6:1.15,7:1.2,8:1.65,9:1.7,10:0  |
| 1             | 0:5.1,1:0,2:0,3:0,4:0,5:5.2           | 6:5.4,7:0,8:0,9:0,10:5.3        |
| 2             | 0:0.6,1:0.1,2:0.75,3:0.2,4:0.65,5:0.7 | 6:0,7:0,8:0,9:0,10:0            |
+---------------+----------------------------------------+----------------------------------+
Solución de problemas
Algo Job Failed-System Error-Null feature value found
La tabla de entrada contiene valores NULL o vacíos. Rellene los valores faltantes con los valores de imputación predeterminados antes de ejecutar el trabajo.
Algo Job Failed-System Error-Feature count can't be more than 2000000
La entrada dispersa tiene un ID de columna que supera 2,000,000. Renumerar las columnas secuencialmente comenzando desde 0 o 1.
Algo Job Failed-System Error-kIOError:Write failed for message: comparison_measure
El modelo de centroides es demasiado grande para escribirse. Renumerar las columnas dispersas comenzando desde 0 o 1 para reducir el tamaño del modelo. Si el valor de col * centerCount supera 270,000,000, elimine el parámetro modelName del comando y ejecute el trabajo nuevamente.
FAILED: Failed Task createCenterTable:kOtherError:ODPS-0130161:[1,558] Parse exception - invalid token ',', expect ")"
Un nombre de columna en la tabla de entrada es una palabra clave reservada de SQL. Cambie el nombre de la columna para evitar conflictos con palabras clave de SQL.
La distancia coseno produce menos de K clústeres
Al usar la distancia coseno, algunos clústeres pueden estar vacíos porque los K centroides iniciales pueden incluir vectores paralelos. Los vectores paralelos se tratan como el mismo centroide, por lo que algunos puntos de datos nunca se les asignan. Para evitar esto, proporcione centroides iniciales explícitos mediante una tabla de centroides externa (initCenterMethod=external) para garantizar K puntos de inicio distintos.