El componente de clasificación de imágenes (Torch) en Platform for AI (PAI) le permite entrenar modelos de clasificación de imágenes con PyTorch dentro de un flujo de trabajo visual sin código en Machine Learning Designer. Este componente es compatible con arquitecturas backbone populares y se integra con Object Storage Service (OSS) para el almacenamiento de datos y modelos.
Requisitos previos
Antes de empezar, asegúrese de que cuenta con lo siguiente:
Un bucket de OSS activado en la misma región que su espacio de trabajo de Designer
Machine Learning Designer autorizado para acceder a OSS. Consulte Activate OSS y Grant permissions
Limitaciones
Este componente solo está disponible en Machine Learning Designer.
El único motor de cómputo compatible es Deep Learning Container (DLC).
Funcionamiento
El componente admite dos enfoques de entrenamiento:
Aprendizaje por transferencia (recomendado): El componente comienza con el modelo predeterminado preentrenado de ImageNet y lo ajusta con sus datos etiquetados. Este enfoque requiere menos datos de entrenamiento y converge más rápido. Para usar un modelo preentrenado personalizado, especifique su ruta de OSS en el parámetro oss path for pretrained model.
Uso del modelo preentrenado predeterminado de PAI: Si deja en blanco la ruta del modelo preentrenado, el componente utiliza el modelo predeterminado proporcionado por PAI.
Todo el entrenamiento se ejecuta en DLC. Una vez finalizado, el artefacto del modelo se guarda en el directorio de OSS que usted especifique y puede pasarse directamente al componente General Image Prediction para realizar inference por lotes.
Preparación de datos
El componente acepta datos de entrenamiento y evaluación etiquetados en dos formatos:
|
Formato |
Descripción |
|
|
Un archivo de anotaciones TXT donde cada línea tiene el formato |
|
|
Datos etiquetados con iTAG, la herramienta de anotación de datos integrada de PAI |
Ejemplo de archivo de anotaciones (ClsSourceImageList):
oss://examplebucket/data/images/cat001.jpg 0
oss://examplebucket/data/images/dog001.jpg 1
oss://examplebucket/data/images/bird001.jpg 2Separe la ruta de la imagen y label_id con un solo espacio. No use tabuladores ni otros delimitadores. El valor label_id es un índice entero basado en cero que corresponde a la posición de la clase en su class list file.
Para preparar datos etiquetados con iTAG, consulte iTAG overview.
Configuración del componente
Localice el componente de clasificación de imágenes (Torch) en la biblioteca de componentes bajo Video Algorithm > Offline Training. Después de agregarlo a su flujo de trabajo, configure las siguientes pestañas.
Puertos de entrada
Conecte los componentes Read OSS data anteriores a los puertos de entrada para pasar los datos etiquetados directamente al flujo de trabajo.
|
Puerto de entrada |
Tipo de datos |
Obligatorio |
|
Data annotation path for training |
OSS |
No |
|
Data annotation path for evaluation |
OSS |
No |
Si conecta datos mediante un puerto de entrada y también establece el parámetro de ruta de anotación correspondiente, el valor del puerto de entrada tiene prioridad.
Pestaña Fields Setting
|
Parámetro |
Obligatorio |
Descripción |
Valor predeterminado |
|
model type |
Sí |
El tipo de tarea de clasificación. Solo se admite |
|
|
oss dir to save model |
Sí |
El directorio de OSS donde se guarda el modelo entrenado. Ejemplo: |
— |
|
oss annotation path for training data |
No |
Ruta de OSS del archivo de anotaciones de entrenamiento etiquetado. Es obligatorio si no hay ningún puerto de entrada de entrenamiento conectado. Ejemplo: |
— |
|
oss annotation path for evaluation data |
No |
Ruta de OSS del archivo de anotaciones de evaluación etiquetado. Es obligatorio si no hay ningún puerto de entrada de evaluación conectado. Ejemplo: |
— |
|
class list file |
Sí |
Especifica los nombres de las categorías de imágenes. Acepta tres formatos: una lista delimitada por corchetes (por ejemplo, |
— |
|
Data Source Type |
Sí |
El formato de anotación de sus datos de entrada. Valores válidos: |
|
|
oss path for pretrained model |
No |
Ruta de OSS de un modelo preentrenado personalizado. Si se deja en blanco, se utiliza el modelo preentrenado predeterminado proporcionado por PAI. |
— |
Pestaña Parameters Setting
Los tres parámetros con mayor impacto en la calidad del entrenamiento son backbone, initial learning rate y optimizer. Configure estos valores con cuidado; los demás parámetros pueden mantenerse en sus valores predeterminados durante las ejecuciones iniciales.
|
Parámetro |
Obligatorio |
Descripción |
Valor predeterminado |
|
backbone |
Sí |
La arquitectura backbone para la extracción de características. Valores válidos: |
|
|
num classes |
Sí |
El número de categorías de imágenes en su conjunto de datos. |
— |
|
image size after resizing |
Sí |
La dimensión en píxeles a la que se redimensionan las imágenes (cuadrada). |
|
|
optimizer |
Sí |
El algoritmo de optimización. Valores válidos: |
|
|
initial learning rate |
Sí |
La tasa de aprendizaje inicial. |
|
|
learning rate policy |
Sí |
La estrategia para ajustar la tasa de aprendizaje durante el entrenamiento. Solo se admite |
|
|
lr step |
Sí |
Los números de época en los que la tasa de aprendizaje decae un 90 %. Separe varios valores con comas. Ejemplo: |
|
|
train batch size |
Sí |
Número de muestras por iteración de entrenamiento. |
|
|
eval batch size |
Sí |
Número de muestras por iteración de evaluación. |
|
|
total train epochs |
Sí |
Número total de pasadas de entrenamiento sobre el conjunto de datos completo. |
|
|
save checkpoint epoch |
No |
Intervalo (en épocas) en el que se guarda un punto de control. Establezca este valor en |
|
|
Exported model type |
Sí |
Formato del modelo exportado. Valores válidos: |
|
Elección de un backbone:
Elija según el tamaño de su conjunto de datos, los requisitos de precisión y los recursos de cómputo disponibles. Los backbones más grandes y potentes requieren más memoria GPU y mayor tiempo de entrenamiento.
|
Backbone |
Recomendado para |
|
ResNet |
Uso general; línea base sólida para la mayoría de los conjuntos de datos |
|
ResNeXt |
Mayor precisión que ResNet, con un costo adicional moderado |
|
HRNet |
Tareas que requieren detalle espacial fino |
|
ViT (Vision Transformer) |
Conjuntos de datos grandes; excelente precisión pero intensivo en cómputo |
|
Swin Transformer (SwinT) |
Características jerárquicas; buen equilibrio entre precisión y eficiencia |
|
MobileNetV2 |
Entornos con recursos limitados; inference rápida |
|
InceptionV4 |
Alta precisión en tareas de clasificación diversas |
Pestaña Tuning
|
Parámetro |
Obligatorio |
Descripción |
Valor predeterminado |
|
number process of reading data per gpu |
No |
Número de hilos de carga de datos por GPU. |
|
|
use fp 16 |
No |
Habilita el entrenamiento FP16 (semiprecisión) para reducir el uso de memoria GPU. |
— |
|
single worker or distributed on DLC |
Sí |
Modo de cómputo. Use |
|
|
number of worker |
No |
Número de nodos worker. Obligatorio cuando se usa |
|
|
cpu machine type |
No |
Tipo de instancia de CPU. Obligatorio cuando se usa |
|
|
gpu machine type |
Sí |
Tipo de instancia de GPU. |
|
Puerto de salida
|
Puerto de salida |
Tipo de datos |
Componente posterior |
|
Output model |
Ruta de OSS |
La salida es la ruta del directorio de OSS configurada en el parámetro oss dir to save model. Conecte este puerto al componente General Image Prediction para ejecutar inference por lotes en su modelo entrenado.
Ejemplo: flujo de trabajo de clasificación de imágenes de extremo a extremo
La siguiente figura muestra un flujo de trabajo de ejemplo que entrena un clasificador de imágenes y ejecuta inference por lotes.
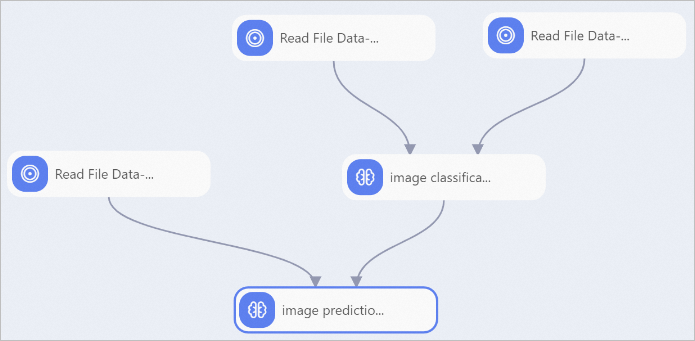
Pasos:
Preparar y etiquetar datos. Etiquete sus imágenes con iTAG. Para más detalles, consulte iTAG overview.
-
Leer datos de entrenamiento y evaluación. Agregue dos componentes Read File Data al lienzo. Establezca el parámetro OSS Data Path de cada componente en la ruta de OSS de sus datos de entrenamiento etiquetados y datos de evaluación, respectivamente.
ImportanteEstablezca Data Source Type en
ClsSourceItagcuando utilice datos etiquetados con iTAG. Configurar el componente de clasificación de imágenes (Torch). Conecte los dos componentes Read File Data a los puertos de entrada de entrenamiento y evaluación del componente image classification (Torch)-1. Configure los parámetros como se describe en Configure the component.
Leer datos de predicción. Agregue un tercer componente Read File Data y establezca su OSS Data Path en la ruta de OSS de las imágenes que desea clasificar.
-
Ejecutar inference por lotes. Agregue un componente image prediction y configure los siguientes parámetros: Para obtener todos los detalles de configuración, consulte image prediction.
model type:
torch_classifieross path for model: Establezca este valor igual al parámetro oss dir to save model del componente image classification (Torch)-1.
Pasos siguientes
General Image Prediction — Ejecute inference por lotes en su modelo entrenado
Read OSS data — Cargue datos en su flujo de trabajo de Designer
iTAG overview — Etiquete datos de entrenamiento con la herramienta de anotación de PAI