En el aprendizaje automático, el algoritmo de pivote de datos es un método para visualizar conjuntos de datos y realizar análisis exploratorios. Utiliza gráficos, tablas y otras herramientas de visualización para revelar la estructura, distribución y relaciones de los datos, lo que ayuda a los usuarios a comprender las funciones, identificar patrones y descubrir anomalías. Este algoritmo es fundamental durante las etapas de preprocesamiento de datos e ingeniería de funciones, ya que guía el modelado y análisis posteriores.
Configuración del componente
Método 1: Uso de la consola
En Machine Learning Designer, agregue el componente Data Pivoting a un pipeline y configure sus parámetros en el panel derecho.
|
Tipo de parámetro |
Parámetro |
Descripción |
|
Fields Setting |
Feature Columns |
Especifica las columnas de funciones para la visualización y el análisis. El componente muestra sus distribuciones y relaciones en gráficos o tablas. |
|
Target Column |
Especifica la variable objetivo, que generalmente es una etiqueta o variable de respuesta, para predicción o análisis. |
|
|
Enumeration Features |
Trata las funciones seleccionadas como funciones de enumeración. |
|
|
k:v,k:v sparse data format |
Especifica si se usarán datos dispersos en formato clave-valor. |
|
|
Parameter Settings |
Number of bins for continuous features |
Especifica el número de intervalos discretos (bins) para dividir las funciones continuas con fines de visualización y análisis. |
|
Tuning |
Number of cores |
Número de núcleos para el cómputo. El valor debe ser un entero positivo. |
|
Memory per core |
Cantidad de memoria para cada núcleo, en MB. El valor debe ser un entero entre 1 y 65536. |
Método 2: Uso de comandos de PAI
Configure los parámetros del componente Data Pivoting al ejecutar un comando de PAI en un componente SQL Script. Para obtener más información, consulte Scenario 4: Execute PAI commands in the SQL Script component.
PAI
-name fe_meta_runner
-project algo_public
-DinputTable="pai_dense_10_10"
-DoutputTable="pai_temp_2263_20384_1"
-DmapTable="pai_temp_2263_20384_2"
-DselectedCols="pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign,poutcome"
-DlabelCol="y"
-DcategoryCols="previous"
-Dlifecycle="28"-DmaxBins="5" ;|
Parámetro |
Obligatorio |
Predeterminado |
Descripción |
|
inputTable |
Sí |
Ninguna |
Nombre de la tabla de entrada. |
|
inputTablePartitions |
No |
Ninguna |
Particiones de la tabla de entrada para el entrenamiento. Se admiten los siguientes formatos:
Nota
Para especificar varios valores para una sola clave de partición, sepárelos con una coma (,); por ejemplo, name1=value1,value2. |
|
outputTable |
Sí |
Ninguna |
Nombre de la tabla de salida. |
|
mapTable |
Sí |
Ninguna |
Tabla de asignación de salida. Para preparar los datos para el entrenamiento de aprendizaje automático, Data Pivoting recopila estadísticas de las funciones STRING y las asigna a identificadores enteros (codificación de etiquetas). |
|
selectedCols |
Sí |
Ninguna |
Nombres de las columnas para seleccionar de la tabla de entrada. |
|
labelCol |
No |
Ninguna |
Columna de etiqueta. |
|
categoryCols |
No |
Ninguna |
Especifica las columnas numéricas (INT o DOUBLE) que se tratarán como funciones de enumeración. |
|
maxBins |
No |
100 |
Especifica el número máximo de intervalos para la discretización equidistante de funciones continuas. |
|
isSparse |
No |
false |
Especifica si los datos de entrada tienen formato disperso. Los valores válidos son true y false. |
|
itemSpliter |
No |
Una coma (,) |
Especifica el delimitador que separa los pares clave-valor si los datos de entrada tienen formato disperso. |
|
kvSpliter |
No |
Dos puntos (:) |
Especifica el delimitador que separa claves y valores si los datos de entrada tienen formato disperso. |
|
lifecycle |
No |
28 |
Ciclo de vida de la tabla. |
|
coreNum |
No |
Determinado por el sistema |
Número de núcleos de CPU para el trabajo. Debe ser un entero positivo. Valores válidos: [1, 9999]. |
|
memSizePerCore |
No |
Determinado por el sistema |
Cantidad de memoria para cada núcleo, en MB. El valor debe ser un entero entre 1 y 65536. |
Ejemplo
-
Prepare los datos de prueba como se muestra en la siguiente tabla.
Age
Workclass
Fwlght
Edu
Edu_num
Married
C
Family
Race
Sex
Gail
Loss
Work_year
Country
Income
39
State-gov
77516
Bachelors
13
Never-married
Adm-clerical
Not-in-family
White
Male
2174.0
0.0
40.0
United-States
<=50K
50
Self-emp-not-inc
83311
Bachelors
13
Married-civ-spouse
Exec-managerial
Husband
White
Male
0.0
0.0
13.0
United-States
<=50K
38
Private
215646
HS-grad
9
Divorced
Handlers-cleaners
Not-in-family
White
Male
0.0
0.0
40.0
United-States
<=50K
53
Private
234721
11th
7
Married-civ-spouse
Handlers-cleaners
Husband
Black
Male
0.0
0.0
40.0
United-States
<=50K
28
Private
338409
Bachelors
13
Married-civ-spouse
Prof-specialty
Wife
Black
Female
0.0
0.0
40.0
Other
<=50K
37
Private
284582
Masters
14
Married-civ-spouse
Exec-managerial
Wife
White
Female
0.0
0.0
40.0
United-States
<=50K
49
Private
160187
9th
5
Married-spouse-absent
Other-service
Not-in-family
Black
Female
0.0
0.0
16.0
Jamaica
<=50K
52
Self-emp-not-inc
209642
HS-grad
9
Married-civ-spouse
Exec-managerial
Husband
White
Male
0.0
0.0
45.0
United-States
>50K
31
Private
45781
Masters
14
Never-married
Prof-specialty
Not-in-family
White
Female
14084.0
0.0
50.0
United-States
>50K
42
Private
159449
Bachelors
13
Married-civ-spouse
Exec-managerial
Husband
White
Male
5178.0
0.0
40.0
United-States
>50K
-
Agregue los componentes Read Table y Data Pivoting al pipeline y conéctelos.
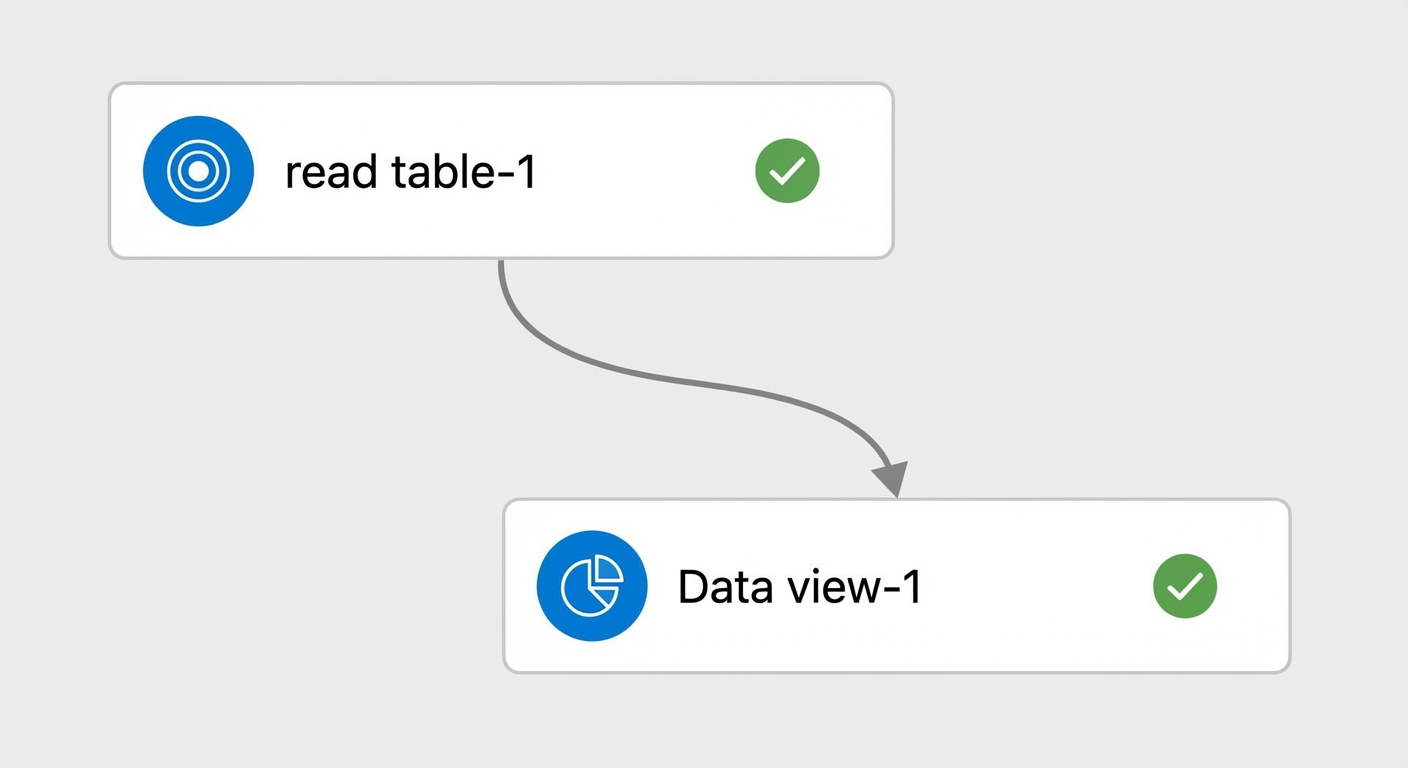
En la pestaña Fields Setting del componente Data Pivoting, seleccione income como columna objetivo y los otros 14 campos como columnas de funciones. Trate el campo edu_num de tipo BIGINT como una función de enumeración. La pestaña Fields Setting del componente Data Pivoting mostrará que Feature Columns, Target Column y Enumeration Features tienen 14, 1 y 1 campo seleccionado, respectivamente.
Haga clic en
 en la esquina superior izquierda para ejecutar el pipeline.
-
Una vez finalizado el pipeline, haga clic con el botón derecho en el componente Data Pivoting y seleccione View Data para consultar los resultados:
Output: Para preparar los datos para los algoritmos de aprendizaje automático, las columnas STRING como family, race, sex y income se asignan a valores numéricos. La tabla de datos de entrenamiento resultante contiene 15 columnas: age, fwlght, edu_num, edu, workclass, married, c, family, race, sex, country, gail, loss, work_year e income. La columna country se resalta para indicar que es una columna de función STRING.
-
String Column Feature Mapping Table
NotaSi no se seleccionan columnas de funciones de tipo STRING, la String Column Feature Mapping Table estará vacía.
La String Column Feature Mapping Table contiene tres columnas: feature_name, feature_value y map_id. Cada fila asigna un valor de función categórica a un ID numérico. Por ejemplo, para la función
edu_num, el valor 13 se asigna a 1 y 14 se asigna a 2. Para la funciónedu, el valor '11th' se asigna a 1, y 'Bachelors' se asigna a 3, y así sucesivamente. Output Meta Table: La tabla de metadatos de funciones de salida contiene 10 columnas (feature_name, feature_id, feature_type, feature_value, mean, std, min_value, max_value, label_num y distribute_info) y 15 filas de datos de funciones. El feature_type puede ser
label(para income),enum(para edu_num, edu, workclass, married, c, family, race, sex y country), onum(para age, fwlght, gail, loss y work_year). Para las funciones numéricas (num), las columnas mean, std, min_value y max_value contienen valores estadísticos específicos. Para las funciones de enumeración (enum) y de etiqueta, estas columnas contienen-1.0. La columna feature_value muestra los valores enumerados o el rango numérico de cada función, y la columna distribute_info muestra la distribución de los valores de la función. distribute_info indica el recuento de registros para cada intervalo tras dividir el rango de valores de la función en intervalos iguales.