Evalúa el rendimiento de un modelo de agrupamiento mediante datos sin procesar y resultados de agrupamiento para generar métricas de evaluación.
Limitaciones
Los informes de visualización de este componente solo están disponibles en la versión original de Machine Learning Studio.
Contexto
El índice de Calinski-Harabasz, también conocido como criterio de razón de varianza (VRC), es una métrica de evaluación que se calcula con la siguiente fórmula.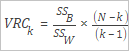
|
Parámetro |
Descripción |
|
SSB |
Varianza entre clústeres, definida como sigue.
|
|
SSW |
Varianza dentro de los clústeres, definida como sigue.
|
|
N |
Número total de registros. |
|
k |
Número de centros de clúster. |
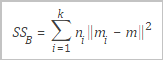 where:
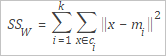 where:
Configuración del componente
Puede configurar el componente de evaluación de modelos de agrupamiento mediante cualquiera de los siguientes métodos.
Método 1: Interfaz gráfica
Configure los parámetros del componente en la página de canalización de Machine Learning Designer.
|
Pestaña |
Parámetro |
Descripción |
|
Field Settings |
Evaluation Columns |
Columnas por evaluar. |
|
Input is Sparse Format |
Indica si los datos de entrada tienen formato disperso de clave-valor (KV). |
|
|
Key-Value Pair Delimiter |
Valor predeterminado: coma (,). |
|
|
Key-Value Inner Delimiter |
Valor predeterminado: dos puntos (:). |
|
|
Execution Tuning |
Number of Cores |
Utilícelo junto con Memory per Core. Debe ser un entero positivo. |
|
Memory per Core |
Utilícelo junto con Number of Cores. Unidad: MB. |
Método 2: Comando PAI
Ejecute un comando PAI en el componente SQL Script para configurar los parámetros del componente. Para obtener más información, consulte SQL Script.
PAI -name cluster_evaluation
    -project algo_public
    -DinputTableName=pai_cluster_evaluation_test_input
    -DselectedColNames=f0,f3
    -DmodelName=pai_kmeans_test_model
-DoutputTableName=pai_ft_cluster_evaluation_out;|
Parámetro |
Obligatorio |
Descripción |
Valor predeterminado |
|
inputTableName |
Sí |
Nombre de la tabla de entrada. |
Ninguna |
|
selectedColNames |
No |
Columnas de la tabla de entrada por evaluar. Para especificar varias columnas, separe los nombres con comas (,). |
Todas las columnas |
|
inputTablePartitions |
No |
Particiones de la tabla de entrada para la evaluación. Se admiten los siguientes formatos:
Nota
Si especifica varias particiones, sepárelas con comas (,). |
Toda la tabla |
|
enableSparse |
No |
Indica si los datos de entrada tienen formato disperso. Valores válidos: |
false |
|
itemDelimiter |
No |
Delimitador entre pares clave-valor en formato disperso. |
Coma (,). |
|
kvDelimiter |
No |
Delimitador entre clave y valor en formato disperso. |
Dos puntos (:). |
|
modelName |
Sí |
Modelo de agrupamiento de entrada. |
Ninguna |
|
outputTableName |
Sí |
Tabla de salida. |
Ninguna |
|
lifecycle |
No |
Ciclo de vida de la tabla de salida. |
Ninguna |
Ejemplo
-
Genere datos de prueba mediante una sentencia SQL.
create table if not exists pai_cluster_evaluation_test_input as select * from ( select 1 as id, 1 as f0,2 as f3 union all select 2 as id, 1 as f0,3 as f3 union all select 3 as id, 1 as f0,4 as f3 union all select 4 as id, 0 as f0,3 as f3 union all select 5 as id, 0 as f0,4 as f3 )tmp; -
Cree un modelo de agrupamiento mediante un comando PAI. Este ejemplo utiliza agrupamiento k-means.
PAI -name kmeans -project algo_public -DinputTableName=pai_cluster_evaluation_test_input -DselectedColNames=f0,f3 -DcenterCount=3 -Dloop=10 -Daccuracy=0.00001 -DdistanceType=euclidean -DinitCenterMethod=random -Dseed=1 -DmodelName=pai_kmeans_test_model -DidxTableName=pai_kmeans_test_idx -
Use un comando PAI para ejecutar el componente de evaluación de modelos de agrupamiento.
PAI -name cluster_evaluation -project algo_public -DinputTableName=pai_cluster_evaluation_test_input -DselectedColNames=f0,f3 -DmodelName=pai_kmeans_test_model -DoutputTableName=pai_ft_cluster_evaluation_out; -
Consulte la tabla de salida pai_ft_cluster_evaluation_out. Tras la ejecución del componente, la tabla de salida contiene un valor
calinharade3, un valorcenterCountde3y un valorcountde5. La siguiente tabla describe los campos de la tabla de salida.Campo
Descripción
count
Número total de registros.
centerCount
Número de centros de clúster.
calinhara
Índice de Calinski-Harabasz.