AIMaster mejora la estabilidad y continuidad de los trabajos de aprendizaje profundo distribuido a gran escala. Resuelve problemas como excepciones de software y hardware, bloqueos de trabajos y fallos de instancia mediante el monitoreo de trabajos, decisiones de tolerancia a fallos y control de recursos.
Contexto
El aprendizaje profundo tiene un uso muy extendido. A medida que crecen los modelos y los datos, el entrenamiento distribuido se convierte en una práctica común. Conforme aumenta el número de instancias de trabajo, las excepciones de software y hardware pueden provocar fallos en los trabajos.
Para garantizar un funcionamiento estable en los trabajos de aprendizaje profundo distribuido a gran escala, DLC ofrece una función de monitoreo de tolerancia a fallos basada en AIMaster. AIMaster es un componente a nivel de trabajo. Al habilitar esta función, se ejecuta una instancia de AIMaster junto con las demás instancias del trabajo para proporcionar monitoreo, decisiones de tolerancia a fallos y control de recursos.
Limitaciones
Actualmente, AIMaster admite los siguientes frameworks: PyTorch, MPI, TensorFlow y ElasticBatch.
Paso 1: Habilitar el monitoreo de tolerancia a fallos
Puede habilitar la función de monitoreo de tolerancia a fallos en la consola o mediante un SDK al enviar un trabajo de entrenamiento de DLC.
En la consola
Al enviar un trabajo de entrenamiento de DLC en la consola, vaya a la sección Fault Tolerance and Diagnosis, active el interruptor Automatic Fault Tolerance y configure los parámetros adicionales. Para obtener más información, consulte Create a training job. DLC inicia entonces un rol adicional de AIMaster para monitorear el trabajo durante todo su ciclo de vida y aplicar la tolerancia a fallos cuando ocurren errores.

Detalles:
Configure parámetros adicionales en el cuadro de texto Other Cofiguration. Para obtener detalles sobre los parámetros, consulte Appendix: Fault tolerance parameters.
-
Después de habilitar Hanging Detection, puede activar la función C4D Detection. C4D (Calibrating Collective Communication over Converged ethernet - Diagnosis) es una herramienta de diagnóstico desarrollada por Alibaba Cloud para identificar trabajos lentos o bloqueados en el entrenamiento de modelos grandes. Para obtener más información, consulte Use C4D.
NotaC4D depende de ACCL (biblioteca de comunicación colectiva de alto rendimiento de Alibaba Cloud). Asegúrese de que ACCL esté instalado. Para obtener más información, consulte ACCL: Alibaba Cloud high-performance collective communication library.
Actualmente, la detección C4D está disponible para trabajos de DLC que utilizan Lingjun AI Computing Service.
Después de habilitar Hanging Detection, utilice la herramienta de análisis de instantáneas de pila de llamadas de funciones para localizar la línea exacta de código donde ocurre un bloqueo del trabajo. Debe configurar el umbral de detección de bloqueos para que esta herramienta funcione correctamente. Para obtener más información, consulte "Use the function call stack snapshot analysis tool".
Via the DLC SDK
Paso 2: Configurar funciones avanzadas
Seleccione entre las siguientes funciones avanzadas según sus necesidades de monitoreo.
Configurar notificaciones de tolerancia a fallos
Una vez habilitado el monitoreo de tolerancia a fallos para un trabajo, configure las notificaciones para eventos de tolerancia a fallos. En la página Workspace Details, seleccione Configure Workspace > Configure Event Notification. Luego, haga clic en Create Event Rule y establezca el tipo de evento en DLC task > Automatic Fault Tolerance. Para obtener más información, consulte Workspace Event Center.
Cuando un trabajo de entrenamiento encuentra una excepción, como una pérdida NaN, utilice el SDK de AIMaster en su código para enviar un mensaje de notificación personalizado:
Para usar esta función, debe instalar el paquete wheel de AIMaster. Para obtener más información, consulte FAQ.
from aimaster import job_monitor as jm

job_monitor_client = jm.Monitor(config=jm.PyTorchConfig())

...

if loss == Nan and rank == 0:
  st = job_monitor_client.send_custom_message(content="The training loss of the job is NaN.")
  if not st.ok():
      print('failed to send message, error %s' % st.to_string())
Configurar palabras clave personalizadas de errores reintentables
El monitoreo de tolerancia a fallos incluye detección integrada para errores reintentables comunes. Si desea que AIMaster aplique la tolerancia a fallos cuando aparezcan palabras clave específicas en los registros de una instancia con errores, configúrelas en su código. Tras la configuración, el módulo de monitoreo examina el final del registro de la instancia fallida en busca de estas palabras clave.
La política de tolerancia a fallos debe establecerse en ExitCodeAndErrorMsg.
-
Ejemplo de configuración de palabras clave personalizadas de errores reintentables para un trabajo de PyTorch
from aimaster import job_monitor as jm

jm_config_params = {}
jm_config = jm.PyTorchConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)
monitor.set_retryable_errors(["connect timeout", "error_yyy", "error_zzz"])
Los parámetros configurados en monitor.set_retryable_errors son las palabras clave personalizadas de errores reintentables.
-
Ejemplo de configuración de palabras clave personalizadas de errores reintentables para un trabajo de TensorFlow
from aimaster import job_monitor as jm

jm_config_params = {}
jm_config = jm.TFConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)
monitor.set_retryable_errors(["connect timeout", "error_yyy", "error_zzz"])
Configurar la detección de bloqueos por etapas
De forma predeterminada, la configuración de detección de bloqueos se aplica a todo el trabajo. Sin embargo, los trabajos suelen ejecutarse en etapas distintas. Por ejemplo, la comunicación entre nodos durante la inicialización puede tardar más que durante la etapa de entrenamiento, donde los registros se actualizan con mayor frecuencia. Para detectar rápidamente un bloqueo durante el proceso de entrenamiento, DLC proporciona una función de detección de bloqueos por etapas. Esto permite configurar diferentes intervalos de detección para distintas fases del trabajo. Configúrelo de la siguiente manera:
monitor.reset_config(jm_config_params)

# Example:
#     monitor.reset_config(job_hang_interval=10)
#     or
#     config_params = {"job_hang_interval": 10, }
#     monitor.reset_config(**config_params)
A continuación se muestra un ejemplo de detección de bloqueos por etapas para un trabajo de PyTorch.
import torch
import torch.distributed as dist
from aimaster import job_monitor as jm

jm_config_params = {
    "job_hang_interval": 1800 # Global 30-minute detection.
}
jm_config = jm.PyTorchConfig(**jm_config_params)
monitor = jm.Monitor(config=jm_config)

dist.init_process_group('nccl')

...

# impl these two funcs in aimaster sdk
# user just need to add annotations to their func
def reset_hang_detect(hang_seconds):
    jm_config_params = {
        "job_hang_interval": hang_seconds
    }
    monitor.reset_config(**jm_config_params)

def hang_detect(interval):
    reset_hang_detect(interval)
    ...

@hang_detect(180) # Reset hang detection to 3 minutes, for this function's scope only.
def train():
    ...

@hang_detect(-1) # Disable hang detection temporarily, for this function's scope only.
def test():
    ...

for epoch in range(0, 100):
    train(epoch)
    test(epoch)
    self.scheduler.step()
Usar C4D
C4D (Calibrating Collective Communication over Converged ethernet - Diagnosis) es una herramienta desarrollada por Alibaba Cloud para diagnosticar trabajos lentos o bloqueados en el entrenamiento de modelos grandes. C4D depende de la biblioteca de comunicación colectiva de alto rendimiento de Alibaba Cloud (ACCL). Asegúrese de que ACCL esté instalado y de que las variables de entorno estén configuradas correctamente. Para obtener más información, consulte ACCL: Alibaba Cloud high-performance collective communication library. Actualmente, puede utilizar la función de detección C4D al seleccionar Lingjun AI Computing Service para un trabajo de DLC.
Descripción general de la función
C4D agrega información de estado de todos los nodos de un trabajo para determinar si un nodo presenta problemas en la capa de comunicación o en otro lugar.

Todos los parámetros
Después de habilitar la función de detección C4D, configure los siguientes parámetros en el cuadro de texto Other Configurations:
Parámetro | Descripción | Valor de ejemplo |
--c4d-log-level | Establece el nivel de registro de salida de C4D. Valores válidos:
El valor predeterminado es Warning, que genera registros en los niveles Warning y Error. Se recomienda usar el valor predeterminado para operaciones normales. Para solucionar problemas de rendimiento, establezca el nivel en Info. |
|
--c4d-common-envs | Establece las variables de entorno para la ejecución de C4D. El formato es
|
|
Para registros de nivel de error, AIMaster aísla automáticamente el nodo correspondiente y reinicia el trabajo. La lógica de manejo para cada nivel de registro es la siguiente:
Nivel de error | Descripción | Acciones |
Error | De forma predeterminada, un bloqueo del trabajo en la capa de comunicación que excede los tres minutos provoca el fallo del trabajo. Puede modificar este comportamiento predeterminado al configurar los parámetros C4D_HANG_TIMEOUT y C4D_HANG_TIMES. | AIMaster aísla automáticamente el nodo reportado en el registro. |
Warning | De forma predeterminada, un bloqueo del trabajo en la capa de comunicación que excede los 10 segundos afecta el rendimiento pero no provoca el fallo del trabajo. Puede modificar este comportamiento predeterminado al configurar el parámetro C4D_HANG_TIMEOUT. | No hay aislamiento automático de nodos. Se requiere confirmación manual. |
Un bloqueo del trabajo fuera de la capa de comunicación que excede los 10 segundos podría provocar el fallo del trabajo. | No hay aislamiento automático de nodos. Se requiere confirmación manual. | |
Info | Lentitud en la capa de comunicación y fuera de ella. | Estos registros de diagnóstico son principalmente para problemas de rendimiento y requieren confirmación manual. |
Si observa que un trabajo de DLC se ejecuta lentamente o está bloqueado, vaya a la lista de trabajos de DLC y haga clic en el nombre del trabajo para abrir la página de descripción general del trabajo. En la sección Instances, consulte el registro del nodo AIMaster para ver los resultados del diagnóstico de C4D. Para obtener más información sobre los resultados del diagnóstico, consulte Diagnostic result examples.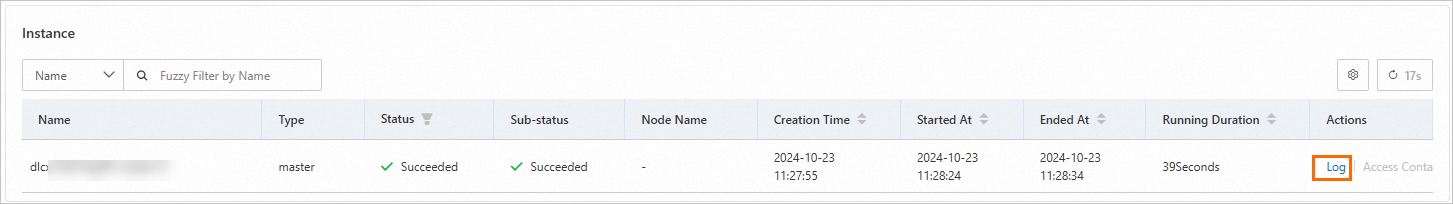
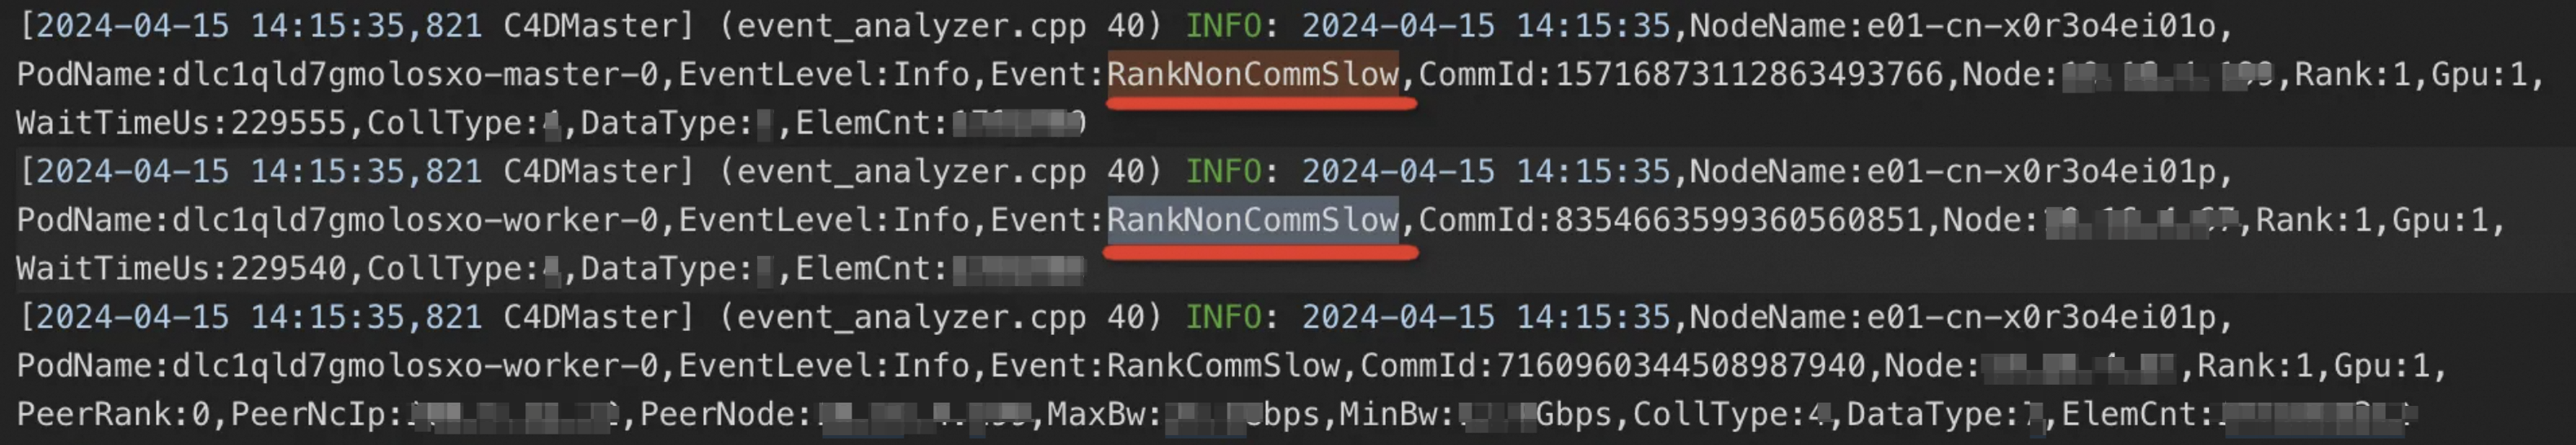
Ejemplos de resultados de diagnóstico
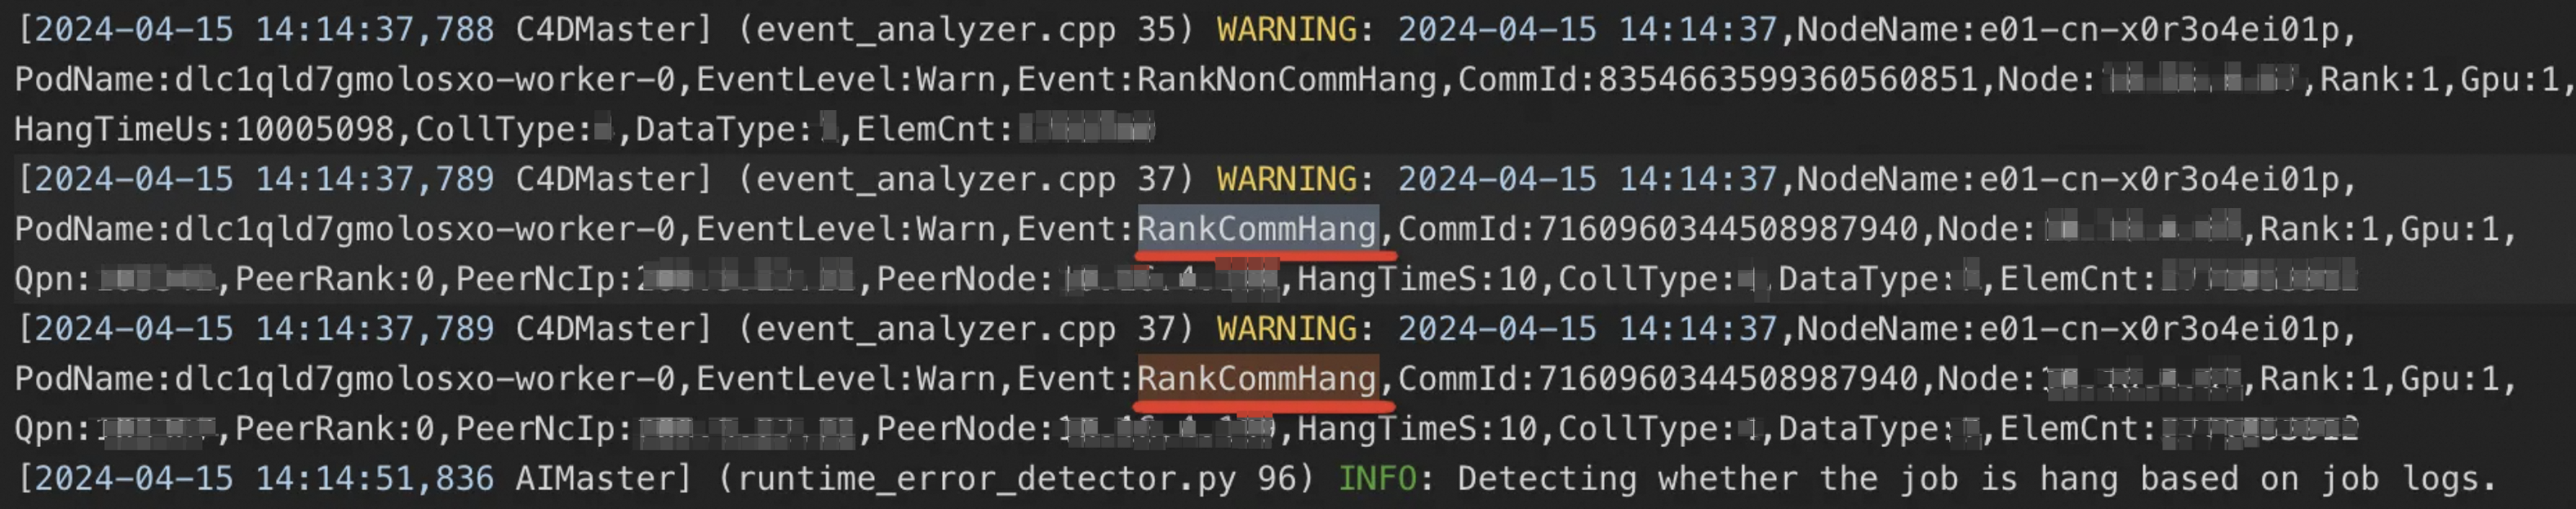
RankCommHang: indica que un nodo tiene un bloqueo en la capa de comunicación.
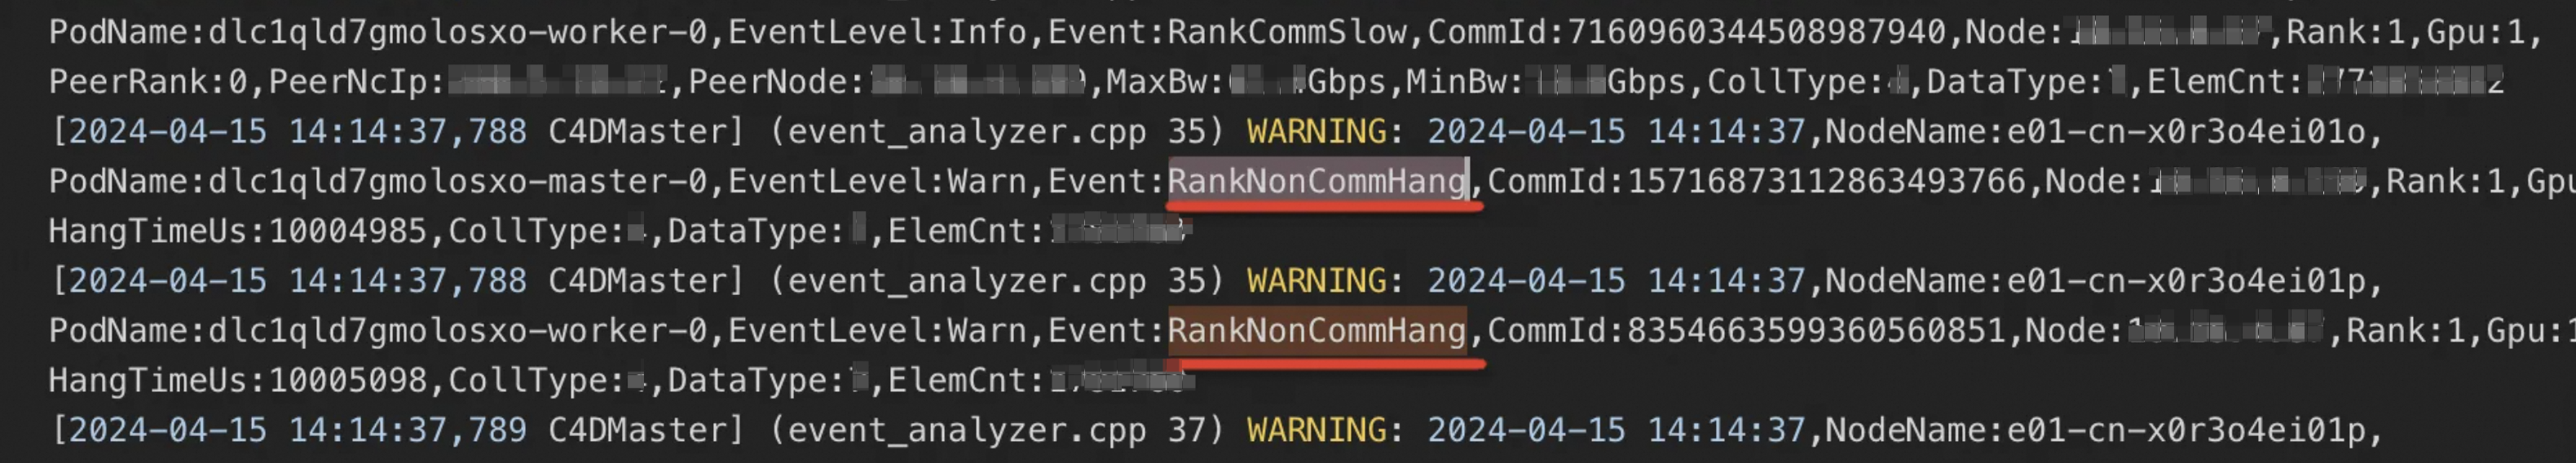
RankNonCommHang: indica que un nodo tiene un bloqueo fuera de la capa de comunicación, como un bloqueo en el proceso de cómputo.
RankCommSlow: indica que un nodo es lento en la capa de comunicación.
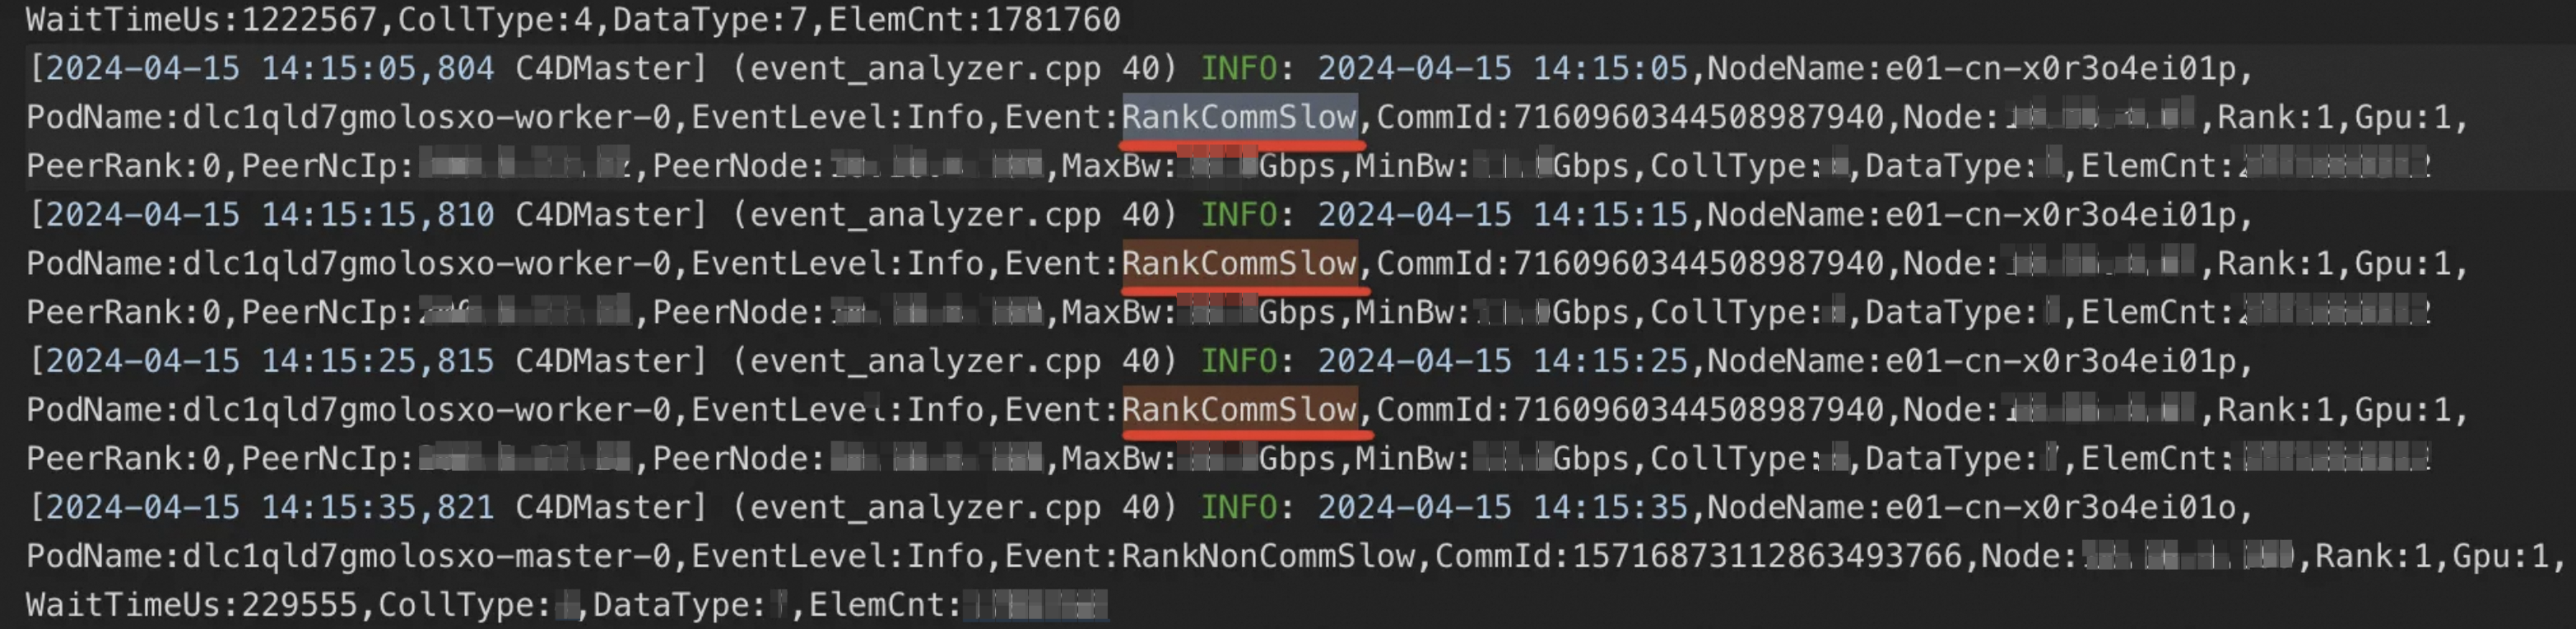
RankNonCommSlow: indica que un nodo es lento fuera de la capa de comunicación.
Analizar instantáneas de pila de llamadas
Un fallo común en el entrenamiento de modelos grandes es el bloqueo del trabajo. Un tipo frecuente es el bloqueo de NCCL, que generalmente genera una entrada de registro como "Watchdog caught collective operation timeout". Para ayudarle a identificar rápidamente la causa raíz de los bloqueos del trabajo, desarrollamos la herramienta de análisis de instantáneas de pila de llamadas de funciones. Siga estos pasos para utilizarla:
Paso 1: Instalar pystack o py-spy
Primero, confirme si pystack o py-spy está instalado en su imagen de contenedor. Si no es así, debe instalar uno de ellos. Por ejemplo, use el siguiente comando para instalar pystack:
pip install pystack -i https://mirrors.cloud.aliyuncs.com/pypi/simple/ --trusted-host mirrors.cloud.aliyuncs.comPaso 2: Habilitar la detección de bloqueos
Para obtener instrucciones sobre cómo habilitar la detección de bloqueos, consulte In the console. Para que la herramienta de análisis de instantáneas de pila de llamadas de funciones opere correctamente, también debe establecer un valor adecuado para el umbral de detección de bloqueos. Primero, determine el valor de tiempo de espera para su trabajo de modelo. Normalmente puede encontrar esto en el registro de errores después de que se bloquea un trabajo. Por ejemplo:
Watchdog caught collective operation timeout: WorkNCCL(SeqNum=2143, OpType=ALLREDUCE, NumelIn=659, NumelOut=659, Timeout(ms)=600000) ran for 600535 milliseconds before timing outEn el campo Timeout de este registro de error, puede ver que el tiempo de espera del trabajo es de 600,000 milisegundos (600 segundos o 10 minutos). En este caso, se recomienda establecer el umbral de detección de bloqueos en 450 segundos. Si el valor de Timeout en su registro es de 1,800 segundos, se recomienda establecer el umbral en 1,500 segundos. Como regla general, el umbral de detección de bloqueos debe ser aproximadamente de 150 a 200 segundos menor que el valor de tiempo de espera del trabajo.
Después de configurar correctamente la detección de bloqueos, AIMaster recopila y analiza automáticamente la pila de llamadas de funciones del proceso del trabajo cuando ocurre un bloqueo. Consulte el resultado del análisis en el registro del nodo AIMaster. A continuación se muestra un ejemplo del resultado de análisis de la herramienta tras un bloqueo del trabajo:

En el resultado del análisis, el campo stack muestra la pila de llamadas de funciones, el campo threads enumera los subprocesos donde ocurrió esta pila, y el campo count indica el número de subprocesos con esta pila. Las pilas con un count de 1 tienen una alta probabilidad de ser la causa del bloqueo del trabajo y deben investigarse primero.
Paso 3: Consultar motivos de reinicio
-
Consultar rondas de reinicio: La información de reinicio del trabajo se organiza por rondas. En la página de detalles del trabajo, expanda los detalles de una ronda para consultar información como el tiempo empleado en cada etapa. Esto le ayuda a comprender con mayor precisión el estado de ejecución del trabajo.

-
Consultar historial de reinicios: Haga clic en el número de reinicios o en la pestaña Restart records para consultar la información relevante de reinicio, incluido el motivo, el resultado y la duración.

Procedimiento:
En la lista Restart records, haga clic en Description para consultar información detallada de un reinicio específico, incluidos Restarts, Restart Time, Node Name, Instance Name, Error Code, Error Message y Error Source.
-
Haga clic en View Aggregation Fault Details para expandir la lista completa de detalles de todos los registros de reinicio.

Apéndice: Parámetros de tolerancia a fallos
Esta sección describe todos los parámetros de la función de monitoreo de tolerancia a fallos. Consulte los ejemplos comunes de configuración de parámetros para planificar sus ajustes. Al habilitar el monitoreo de tolerancia a fallos, configure estos parámetros en la sección Other Cofiguration según sea necesario.
Todos los parámetros
Configuración general
Función | Parámetro | Descripción | Predeterminado |
Modo de ejecución del trabajo | --job-execution-mode | El modo de ejecución del trabajo. Valores válidos:
El comportamiento de tolerancia a fallos difiere según el tipo de trabajo para errores reintentables:
| Sync |
Configuración de reinicio del trabajo | --enable-job-restart | Especifica si se permite que el trabajo se reinicie cuando se cumplen las condiciones de tolerancia a fallos o se detecta una excepción en tiempo de ejecución. Valores válidos:
| False |
--max-num-of-job-restart | El número máximo de veces que el trabajo puede reiniciarse. Si se supera este número, el trabajo falla. | 3 |
Configuración de tiempo de ejecución
Aplica a escenarios donde ninguna instancia ha fallado.
Función | Parámetro | Descripción | Predeterminado |
Detección de bloqueos del trabajo | --enable-job-hang-detection | Especifica si se debe habilitar la detección de bloqueos en tiempo de ejecución para el trabajo. Esta función solo admite trabajos síncronos. Valores válidos:
| False |
--job-hang-interval | La duración en segundos que un trabajo puede estar suspendido. Debe ser un entero positivo. Si la duración de la suspensión excede este valor, el trabajo se considera anómalo y se reinicia. | 1800 | |
--enable-c4d-hang-detection | Especifica si se debe habilitar la detección C4D para diagnosticar y localizar rápidamente nodos lentos y nodos defectuosos que causan un bloqueo del trabajo durante la ejecución. Nota Este parámetro solo surte efecto cuando el parámetro --enable-job-hang-detection también está habilitado. | False | |
Detección de bloqueos al salir del trabajo | --enable-job-exit-hang-detection | Especifica si se debe habilitar la detección de bloqueos durante la salida del trabajo. Esta función solo admite trabajos síncronos. Valores válidos:
| False |
--job-exit-hang-interval | La duración en segundos que un trabajo puede estar suspendido durante la salida. Debe ser un entero positivo. Si la duración de la salida excede este valor, el trabajo se considera anómalo y se reinicia. | 600 |
Configuración de tolerancia a fallos
Aplica a escenarios donde al menos una instancia ha fallado.
Función | Parámetro | Descripción | Predeterminado |
Política de tolerancia a fallos | --fault-tolerant-policy | La política de tolerancia a fallos. Valores válidos:
| ExitCodeAndErrorMsg |
Ocurrencias máximas del mismo error | --max-num-of-same-error | El número máximo de veces que el mismo error puede ocurrir en una sola instancia. Si el conteo de errores excede este valor, el trabajo falla. | 10 |
Tasa de fallos máxima tolerada | --max-tolerated-failure-rate | La tasa máxima de fallos tolerada. Si la proporción de instancias fallidas excede este valor, el trabajo falla. El valor predeterminado de -1 deshabilita esta función. Por ejemplo, un valor de 0.3 significa que el trabajo falla si más del 30% de los workers encuentran un error. | -1 |
Ejemplos de configuración de parámetros
Los siguientes ejemplos muestran configuraciones comunes de parámetros para diferentes trabajos de entrenamiento.
-
Trabajo de entrenamiento síncrono (común en trabajos de PyTorch)
Cuando una instancia falla y cumple las condiciones de tolerancia a fallos, el trabajo se reinicia.
--job-execution-mode=Sync --enable-job-restart=True --max-num-of-job-restart=3 --fault-tolerant-policy=ExitCodeAndErrorMsg -
Trabajo de entrenamiento asíncrono (común en trabajos de TensorFlow)
Para errores reintentables, se reinician las instancias Worker fallidas. Si falla una instancia PS o Chief, el trabajo no se reinicia de forma predeterminada. Para habilitar los reinicios del trabajo, establezca --enable-job-restart=True.
--job-execution-mode=Async --fault-tolerant-policy=OnFailure -
Trabajo de inference sin conexión (común en trabajos de ElasticBatch)
Las instancias son independientes, similar a un trabajo asíncrono. Cuando una instancia falla, solo esa instancia se reinicia.
--job-execution-mode=Async --fault-tolerant-policy=OnFailure
Preguntas frecuentes
P: ¿Cómo instalo el SDK de AIMaster?
Utilice el comando correspondiente a su versión de Python para instalar el paquete wheel.
# Python 3.6
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp36-cp36m-linux_x86_64.whl

# Python 3.8
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp38-cp38-linux_x86_64.whl

# Python 3.10
pip install -U http://odps-release.cn-hangzhou.oss.aliyun-inc.com/aimaster/pai_aimaster-1.2.1-cp310-cp310-linux_x86_64.whl