La aceleración de caché local de Lingjun almacena los datos de entrenamiento en la caché de los nodos de cómputo. Esto elimina las lecturas repetidas desde el almacenamiento remoto en cada epoch y mejora significativamente el rendimiento de lectura de datos. Esta función es ideal para entrenamientos de múltiples epochs y conjuntos de datos a gran escala que requieren acceso reiterado a la información.
Conceptos clave
La caché local incluye las siguientes capacidades:
Caché de alta velocidad: Utiliza los discos locales de los nodos de cómputo para crear una caché de lectura, lo que acelera el acceso a conjuntos de datos y puntos de control, además de reducir la latencia de acceso a los datos.
Escalabilidad horizontal: El rendimiento de la caché escala linealmente con la cantidad de nodos de cómputo y admite clústeres de cientos a miles de nodos.
Aceleración de ancho de banda alto mediante RDMA: Usa el protocolo RDMA (Remote Direct Memory Access) para maximizar el ancho de banda de la red de alta velocidad durante lecturas de datos con alta concurrencia, lo que aumenta el rendimiento.
Precalentamiento de datos: Carga datos específicos en la caché local antes de que inicie un trabajo de entrenamiento, lo que evita retrasos por arranque en frío durante el primer epoch.
Limitación de ancho de banda del lado del cliente: Establece un límite máximo de ancho de banda de lectura por cliente de trabajo DLC para evitar que un solo trabajo consuma demasiado ancho de banda de almacenamiento y afecte a otros trabajos.
Operación serverless: Habilite o deshabilite la función con un solo clic. No se requieren cambios en el código. La función no es intrusiva y no necesita mantenimiento operativo.
Casos de uso
La caché local es adecuada para trabajos de entrenamiento de múltiples epochs donde el conjunto de datos es mucho mayor que lo leído en una sola pasada y se accede a los datos repetidamente. La aceleración RDMA, el precalentamiento de datos y la limitación de ancho de banda del lado del cliente abordan diferentes características de entrenamiento y pueden combinarse según sea necesario:
|
Escenario |
Funciones recomendadas |
Resultado esperado |
|
Lecturas de datos con alta concurrencia (num_workers o batch_size grandes) |
Caché local + aceleración RDMA |
Los nodos de caché distribuidos transfieren datos mediante RDMA, aprovechan al máximo el ancho de banda de la red de alta velocidad y aumentan significativamente el rendimiento bajo alta concurrencia. |
|
Primer epoch sensible a la latencia |
Caché local + precalentamiento de datos |
Los datos se cargan en la caché antes de que inicie el trabajo, lo que elimina el retraso por arranque en frío en el primer epoch. |
|
Varios trabajos que comparten el mismo almacenamiento, o ancho de banda de caché RDMA que compite con el entrenamiento distribuido |
Caché local + limitación de ancho de banda del lado del cliente |
Un límite de ancho de banda de lectura por trabajo garantiza una ejecución paralela estable en todo el clúster. |
|
Entrenamiento de múltiples epochs en grandes conjuntos de datos de video o imágenes |
Caché local + RDMA + precalentamiento de datos |
Los conjuntos de datos de video generan una carga de E/S elevada. RDMA aumenta el rendimiento y el precalentamiento de datos elimina el arranque en frío. |
|
Entrenamiento estándar con muchos epochs y recorrido repetido de datos |
Caché local |
Los datos se leen del almacenamiento y se escriben en la caché durante el primer epoch; los epochs posteriores leen directamente desde la caché local, y la velocidad de lectura mejora con cada epoch subsiguiente. |
Si su trabajo tiene una presión de lectura de alta concurrencia, habilite la aceleración RDMA. Si la latencia del primer epoch es crítica, combine la caché local con el precalentamiento de datos. Si varios trabajos en su clúster comparten el mismo almacenamiento, habilite la limitación de ancho de banda del lado del cliente para proteger el ancho de banda.
Limitaciones
Compatibilidad de almacenamiento: Se admiten Object Storage Service (OSS) y CPFS (Cloud Parallel File System).
Recursos aplicables: Solo recursos de cómputo Lingjun. Cuando se habilita, se consumen recursos del nodo de cómputo: montar un sistema de archivos o un bucket de OSS utiliza 4 vCPU y 14 GB de memoria por nodo; cada montaje adicional usa 1 vCPU y 2 GB de memoria. Reserve recursos antes de habilitar la función.
Consumo de recursos RDMA: En modo RDMA, montar un sistema de archivos o un bucket de OSS utiliza 8 vCPU y 16 GB de RAM por nodo; cada montaje adicional usa 1 vCPU y 2 GB de memoria. Los nodos deben tener tarjetas de red RDMA; los nodos Lingjun de altas especificaciones son compatibles con esto de forma predeterminada.
Capacidad y política de desalojo: La capacidad máxima de la caché depende del tipo de instancia Lingjun. La política de desalojo es LRU (Least Recently Used).
Alcance de la aceleración: Solo aceleración de lectura. Las operaciones de escritura no se aceleran.
Disponibilidad de datos: No se garantiza la alta disponibilidad. Los datos en caché pueden perderse. Realice copias de seguridad de los datos de entrenamiento importantes de manera oportuna.
Rendimiento del primer epoch: El primer epoch lee desde la instancia de almacenamiento (como OSS o CPFS) y escribe en la caché, lo cual es ligeramente más lento que leer directamente del almacenamiento. Los epochs posteriores leen directamente desde la caché local a mayor velocidad. Para evitar la desaceleración del primer epoch, utilice el precalentamiento de datos.
Habilitar la aceleración de caché local
Para habilitar la aceleración de caché local, complete los siguientes pasos:
Habilite la caché local para una cuota de recursos.
Configure las reglas de entrada del security group.
Cree un trabajo DLC con la caché habilitada.
-
Opcionalmente, configure la aceleración RDMA, la limitación de ancho de banda del lado del cliente y el precalentamiento de datos.
Paso 1: Habilitar la caché local para una cuota de recursos
-
En el panel de navegación izquierdo, haga clic en Resource Quota > Intelligent Computing LINGJUN Resources, busque el nombre de la cuota objetivo y haga clic en él para abrir la página de administración.
NotaPara cuotas anidadas de varios niveles, solo la cuota de nivel superior admite la habilitación de la caché local.
-
Cambie a la pestaña Local cache, active Local cache acceleration y establezca las rutas de almacenamiento para la caché. Las rutas de la caché deben apuntar a los directorios de almacenamiento donde residen sus datos de entrenamiento.
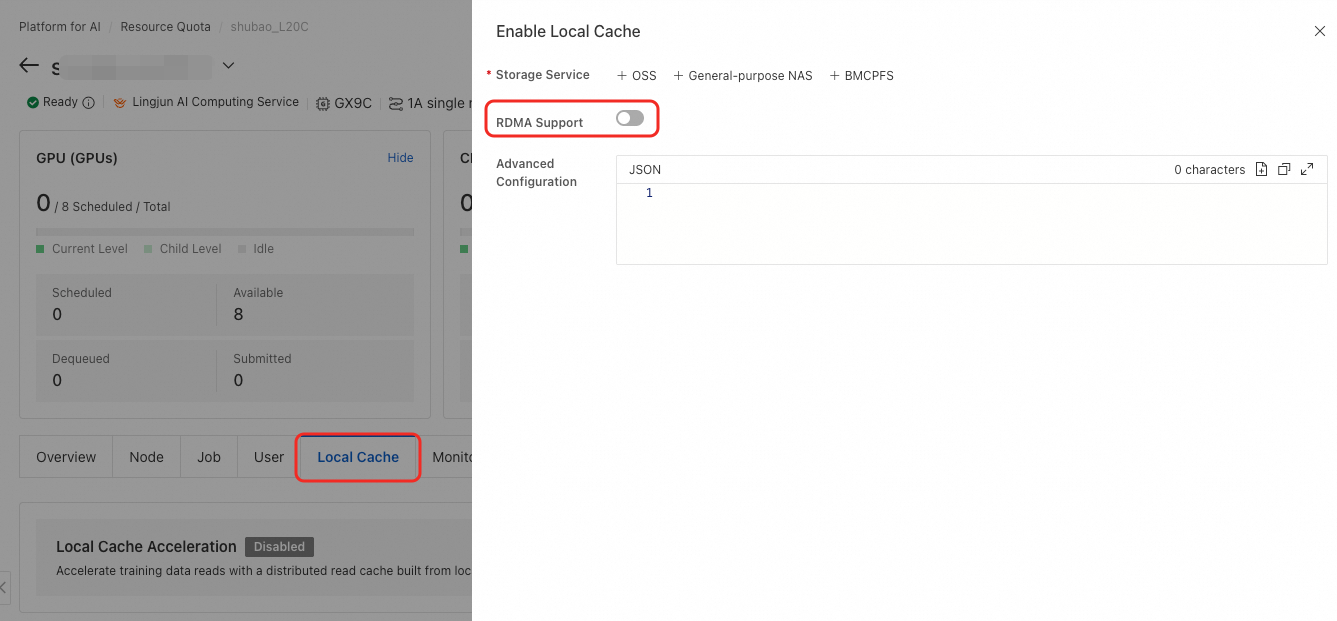
Para usar la aceleración RDMA, active el interruptor Supports RDMA en la página de configuración de la caché.
Paso 2: Configurar las reglas de entrada del security group
Para security groups empresariales, configure una regla de entrada para permitir que el servicio de caché se comunique a través de la red VPC.
En la página de cuota de recursos, busque el nombre o ID del security group en la sección de información de red.
-
Vaya a ese security group. Si el tipo de security group es Enterprise, agregue una regla de inbound con la siguiente configuración:
Establezca la política de autorización en Allow.
Establezca la prioridad en 1.
Establezca el protocolo en Custom TCP.
Establezca el origen en IPv4 e introduzca el bloque CIDR de la VPC, por ejemplo
10.0.0.0/8.Establezca el rango de puertos de destino en
10080/(10080+n-1)y10070/(10070+n-1), donde n es la cantidad de entradas de servicio de almacenamiento (n ≤ 10). Por ejemplo, con 4 servicios de almacenamiento configurados, abra los puertos10080/10083y10070/10073.
NotaEstablezca el origen en el bloque CIDR del vSwitch utilizado por la cuota de recursos. La cantidad de puertos de destino debe coincidir con la cantidad de servicios de almacenamiento en la configuración de la caché.
Paso 3: Crear un trabajo DLC con la caché habilitada
Cree un trabajo DLC (Distributed Learning Container) utilizando los recursos Lingjun de la cuota de recursos objetivo.
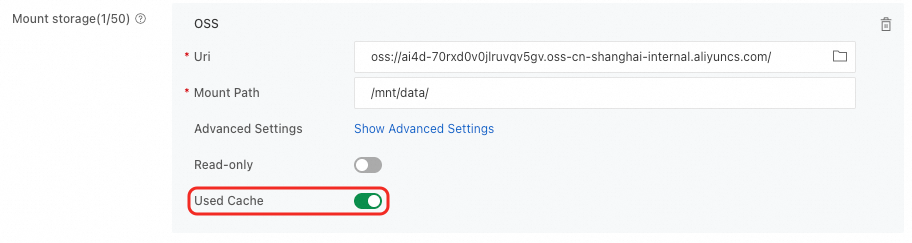
Al configurar el parámetro Storage Mount para el trabajo DLC, seleccione el URI de montaje de OSS y la ruta de montaje (por ejemplo,
/mnt/data/).-
Cuando la dirección de almacenamiento montada coincide con una ruta de caché configurada, el interruptor Use Cache se activa automáticamente (puede desactivarlo si es necesario).
Paso 4: Configurar la limitación de ancho de banda del lado del cliente (opcional)
Al crear el trabajo DLC, agregue el parámetro
mountOptionsen la configuración avanzada del conjunto de datos para limitar el ancho de banda de lectura por cliente:{ "mountOptions": "-o g_tier_DadiSdkGetTrafficLimit=3221225472" }Descripción del parámetro:
g_tier_DadiSdkGetTrafficLimit: Umbral de límite de tasa de lectura del cliente, en B/s (bytes por segundo). El valor predeterminado es3221225472(3 GB/s).
Valores comunes de límite de tasa:
Límite objetivo
Valor (B/s)
1 GB/s
1073741824
3 GB/s (predeterminado)
3221225472
4 GB/s
4294967296
5 GB/s
5368709120
Paso 5: Configurar el precalentamiento de datos (opcional)
Antes de que inicie un trabajo de entrenamiento, utilice el precalentamiento de datos para cargar datos específicos en la caché local y evitar un retraso por arranque en frío en el primer epoch.
Console
Crear una tarea de precalentamiento
-
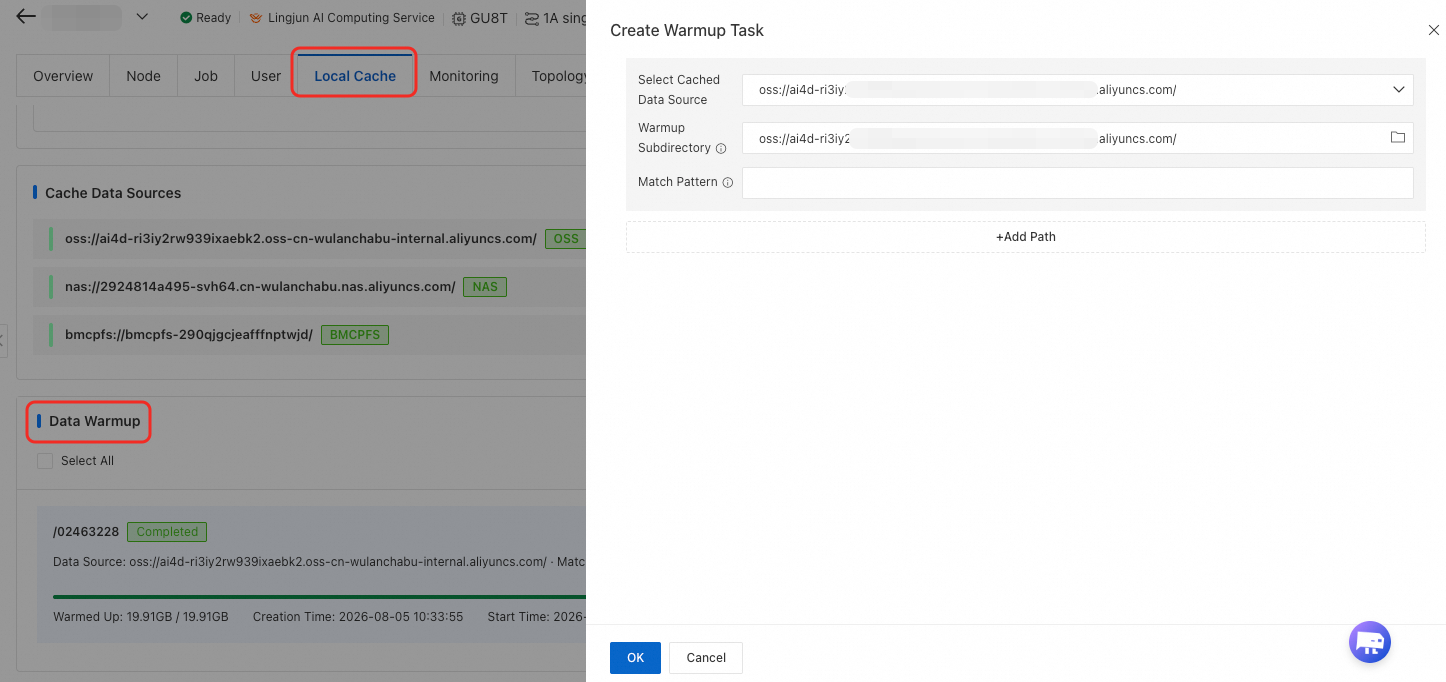
En la pestaña Local cache, desplácese hasta la sección Data warm-up y haga clic en + Create warm-up task en la esquina superior derecha.
-
En el cuadro de diálogo, complete los siguientes campos según sea necesario:
Campo
Obligatorio
Descripción
Recomendación
Cache data source
Sí
Seleccione en la lista desplegable. Solo están disponibles las instancias de almacenamiento configuradas en el Paso 1.
Seleccione el bucket desde el cual lee su trabajo de entrenamiento.
Warm-up subdirectory
No
Especifique un subdirectorio dentro del origen de datos seleccionado. Introduzca una ruta manualmente o haga clic en el icono de carpeta para navegar. Déjelo en blanco para precalentar todo el origen de datos.
Especifique el subdirectorio del conjunto de datos o punto de control para reducir el tráfico innecesario.
Match pattern
No
Una expresión regular relativa al subdirectorio. El valor predeterminado es
.*(coincidir con todos).Por ejemplo, para precalentar solo archivos JPEG:
.*\.jpg$. Para precalentar varias ubicaciones, haga clic en + Add path en la parte inferior para agregar otra entrada. Haga clic en el icono de eliminación al inicio de una fila para quitarla.
Haga clic en OK para enviar. La tarea aparece inmediatamente en la lista de precalentamiento de datos.
Solo se ejecuta una tarea de precalentamiento a la vez por instancia de caché. Las tareas adicionales se ponen en cola en orden FIFO y permanecen en estado Creating. El volumen total de precalentamiento no debe exceder la capacidad de la caché, de lo contrario los datos serán desalojados por la política LRU.
Ver el progreso del precalentamiento
La lista de tareas de precalentamiento muestra la siguiente información: ID de tarea, ruta (origen de datos + subdirectorio + patrón de coincidencia), estado, hora de creación, hora de finalización, cantidad de archivos coincidentes/bytes y motivo de error.
Descripciones de estado:
Creating: Enviada y en cola para ejecución.
Running: Extrayendo datos hacia la caché local.
Completed: Precalentamiento completado y caché cargada.
Cancelled: Cancelada manualmente.
Failed: Error en el precalentamiento. Compruebe el motivo del error. Causas comunes: la ruta no existe o ningún archivo coincidió con el patrón.
Cancelar o eliminar una tarea de precalentamiento
Para tareas en estado Creating o Running, haga clic en Cancel al final de la fila para detener la tarea.
Los registros Completed o Failed se conservan solo con fines de auditoría y pueden eliminarse directamente.
ImportanteAsegúrese de que ningún trabajo de entrenamiento en ejecución dependa de la caché actual antes de desactivar el interruptor principal de aceleración de caché local. Desactivar este interruptor borra todos los registros de precalentamiento y los datos en caché.
API
Determinar el puerto de precalentamiento
Cada entrada de configuración de caché tiene un puerto de precalentamiento dedicado en el rango 10070–10079:
Índice de caché
Puerto de precalentamiento
1.ª caché
10070
2.ª caché
10071
3.ª caché
10072
Iniciar el precalentamiento de datos
Ejecute el siguiente comando en una instancia DSW (Data Science Workshop) o DLC bajo la misma cuota para iniciar el precalentamiento:
Nota: La API de precalentamiento solo puede invocarse desde instancias DSW o DLC bajo la misma cuota que el servicio de caché. Las instancias DSW tienen los permisos de rol necesarios de forma predeterminada y no requieren configuración adicional.
# If isShareded = true in the getDataCacheService response, use this command:
curl -s "http://<CacheServiceId>-svc-0.t<AccountId>.svc.cluster.local.<clusterId>.t<AccountId>:<Port>/v1/warmup/load?target_path=<path1>,<path2>&pattern=<glob_pattern>"

# Otherwise, use this command:
curl -s "http://<CacheServiceId>.t<AccountId>.svc.cluster.local.<clusterId>.t<AccountId>:<Port>/v1/warmup/load?target_path=<path1>,<path2>&pattern=<glob_pattern>"
Descripciones de parámetros:
isShareded: En la página de detalles de la cuota en la consola, vaya a la pestaña Local cache, abra las herramientas de desarrollador del navegador (F12) y compruebe el campoisSharededen la respuesta de la APIgetDataCacheService.CacheServiceId: Invoque la API GetQuota para consultar la cuota de recursos objetivo. ObtengaCacheServiceIdde la respuesta de la cuota de nivel superior (cuota de recursos de primer nivel).<primary account ID>: En la consola, haga clic en su avatar de usuario en la esquina superior derecha para ver su ID de cuenta principal.clusterId: Igual queisShareded— compruebe la respuesta de la APIgetDataCacheService.Port: El puerto de precalentamiento determinado en el paso anterior.target_path: Rutas para precalentar, con múltiples rutas separadas por comas. Deben ser rutas relativas bajo el directorio de montaje. Por ejemplo, para precalentar/path1/path2en BMCPFS, establezcatarget_path=path1/path2.pattern(opcional): Un patrón de coincidencia de archivos que admite expresiones regulares. Por ejemplo,pattern=.*.txtprecalienta solo archivos.txt.
Ejemplo:
# Warm up all .txt files under dataset/train in the mount directory
curl -s "http://cacheservice-xxxx:t10953*******.svc.cluster.local.ca076dea628***********.t10953*******:10070/v1/warmup/load?target_path=dataset/train&pattern=.*.txt"
Comprobar el estado del precalentamiento
Ejecute el siguiente comando para comprobar el progreso del precalentamiento:
# If isShareded = true in the getDataCacheService response, use this command:
curl -s "http://<CacheServiceId>-svc-0.t<AccountId>.svc.cluster.local.<clusterId>.t<AccountId>:<Port>/v1/warmup/stat?target_path=<path1>,<path2>&preceding_time=<minutes>"

# Otherwise, use this command:
curl -s "http://<CacheServiceId>.t<AccountId>.svc.cluster.local.<clusterId>.t<AccountId>:<Port>/v1/warmup/stat?target_path=<path1>,<path2>&preceding_time=<minutes>"
Descripciones de parámetros:
target_path: La misma ruta utilizada en la solicitud de precalentamiento.preceding_time: Consulta el estado del precalentamiento de los últimos N minutos.
Ejemplo:
# Check warm-up status for dataset/train over the last 10 minutes
curl -s "http://cacheservice-xxxx:t10953*******.svc.cluster.local.ca076dea628***********.t10953*******:10070/v1/warmup/stat?target_path=dataset/train&preceding_time=10"
Notas de uso
La API de precalentamiento solo puede invocarse desde instancias DSW o DLC bajo la misma cuota que el servicio de caché.
target_pathdebe usar rutas relativas al directorio de montaje. No use rutas absolutas.Para cuotas de recursos anidadas de varios niveles, asegúrese de que
CacheServiceIdprovenga de la cuota de recursos de nivel superior (primer nivel).El precalentamiento se ejecuta de forma asíncrona. Rastree el progreso con la API
/v1/warmup/stat.
-
Preguntas frecuentes
P: ¿La aceleración RDMA acelera el primer epoch?
Sin el precalentamiento de datos, el primer epoch lee datos de la instancia de almacenamiento y los escribe en la caché, por lo que el rendimiento es ligeramente más lento que leer directamente del almacenamiento. La aceleración es más notable en los epochs posteriores cuando los datos se sirven desde la caché. En modo RDMA, incluso la extracción inicial de datos se beneficia de una mayor eficiencia de transferencia de red que TCP, por lo que el primer epoch también puede experimentar alguna mejora. Para garantizar la aceleración en el primer epoch, utilice el precalentamiento de datos.
P: ¿Cuántos recursos adicionales consume habilitar la caché local?
Montar un sistema de archivos o un bucket de OSS consume 4 vCPU y 14 GB de memoria por nodo en modo estándar, u 8 vCPU y 16 GB de memoria en modo RDMA. Cada montaje de almacenamiento adicional usa 1 vCPU y 2 GB de memoria. Reserve recursos antes de habilitar la función.
P: ¿El precalentamiento de datos es compatible con todos los tipos de instancia?
La API de precalentamiento puede invocarse desde instancias DSW o DLC bajo la misma cuota. Las instancias DSW tienen los permisos de rol necesarios de forma predeterminada y no requieren configuración adicional.