Este tema describe cómo agregar una tabla que utiliza MaxCompute como origen de datos.
Requisitos previos
MaxCompute se conocía anteriormente como ODPS. Para obtener más información, consulte What is MaxCompute.
La cuenta de Alibaba Cloud que utiliza para iniciar sesión en OpenSearch debe tener los permisos obligatorios sobre la tabla de MaxCompute. Estos permisos incluyen
describe,select,downloady permisos de etiqueta para los campos.
A continuación se muestran las sentencias para otorgar permisos:
-- Add a user.
add user ****@aliyun.com;

-- Grant the required table permissions to the user.
GRANT describe,select,download ON TABLE table_xxx TO USER ****@aliyun.com
GRANT describe,select,download ON TABLE table_xxx_done TO USER ****@aliyun.com

-- MaxCompute enables field-level permission verification. This may prevent you from accessing high-privilege fields when pulling data, which causes the index build to fail. In this case, you must grant field-level access permissions to the user.
-- Grant permissions on the entire project.
SET LABEL 3 to USER ****@aliyun.com

-- Grant permissions on a single table.
GRANT LABEL 3 ON TABLE table_xxx(col1, col2) TO ****@aliyun.com
El motor de Vector Search Edition admite los siguientes tipos de campo para las tablas de MaxCompute: STRING, BOOLEAN, DOUBLE, BIGINT y DATETIME.
Para obtener más información sobre las sentencias CREATE TABLE y la configuración de parámetros, consulte CREATE TABLE statements for a MaxCompute data source.
Agregar una tabla
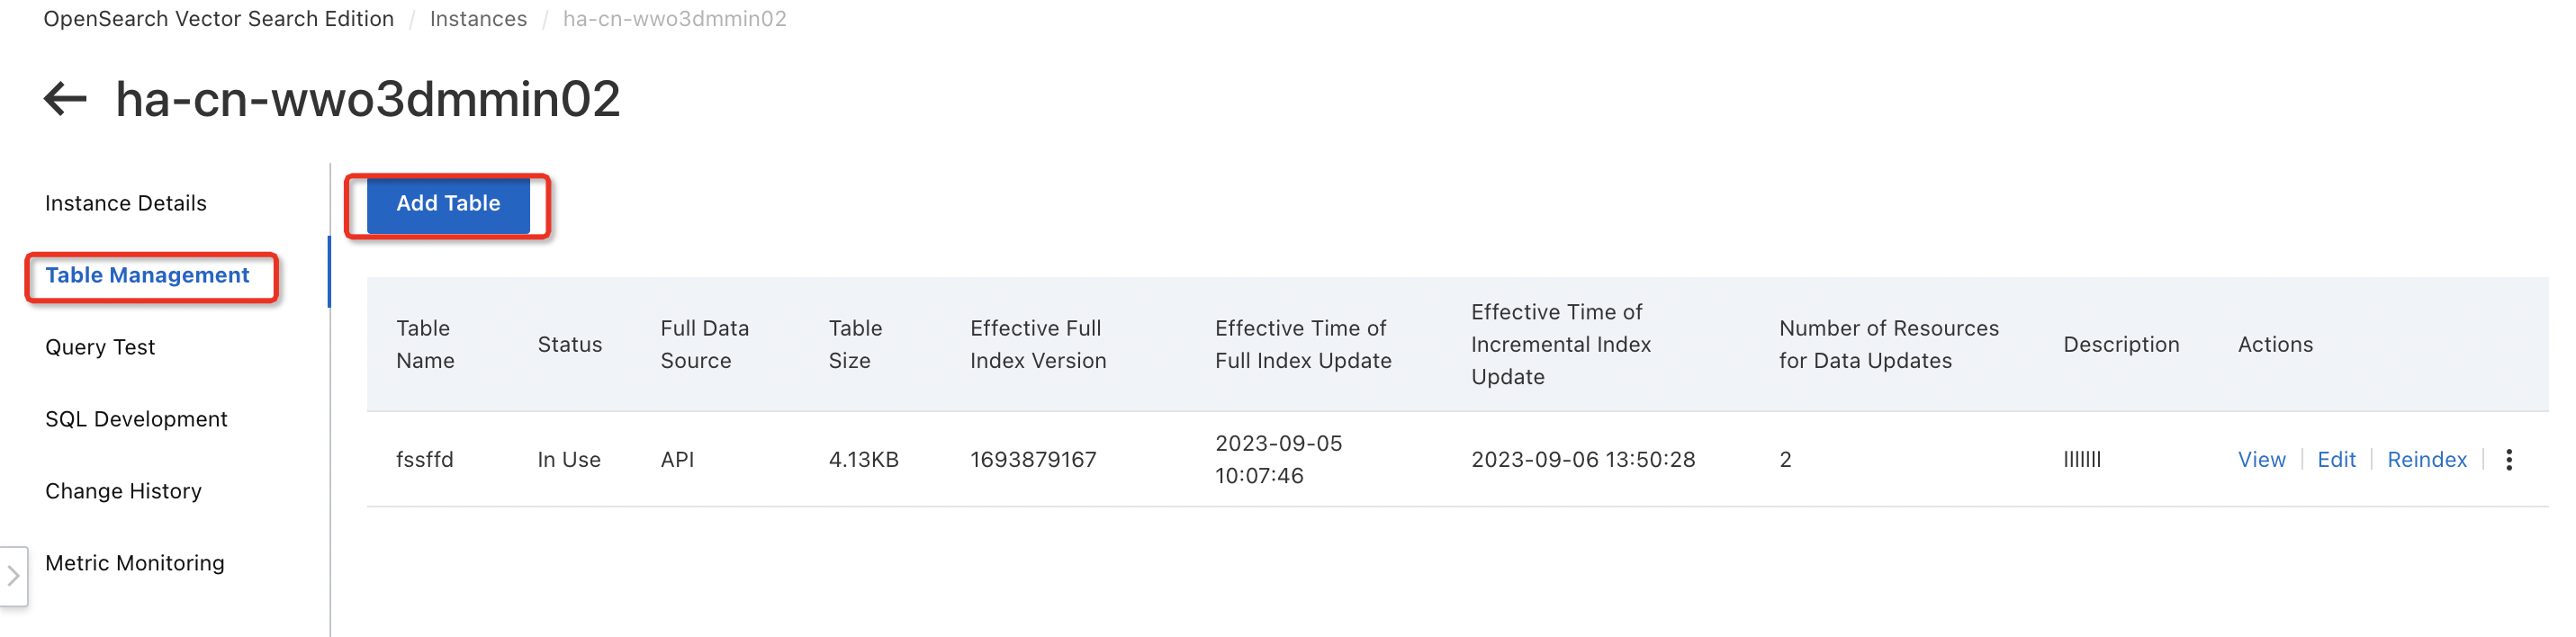
En la página Instance Details > Table Management, haga clic en Add Table.
Introduzca la información básica de la tabla y haga clic en Next.
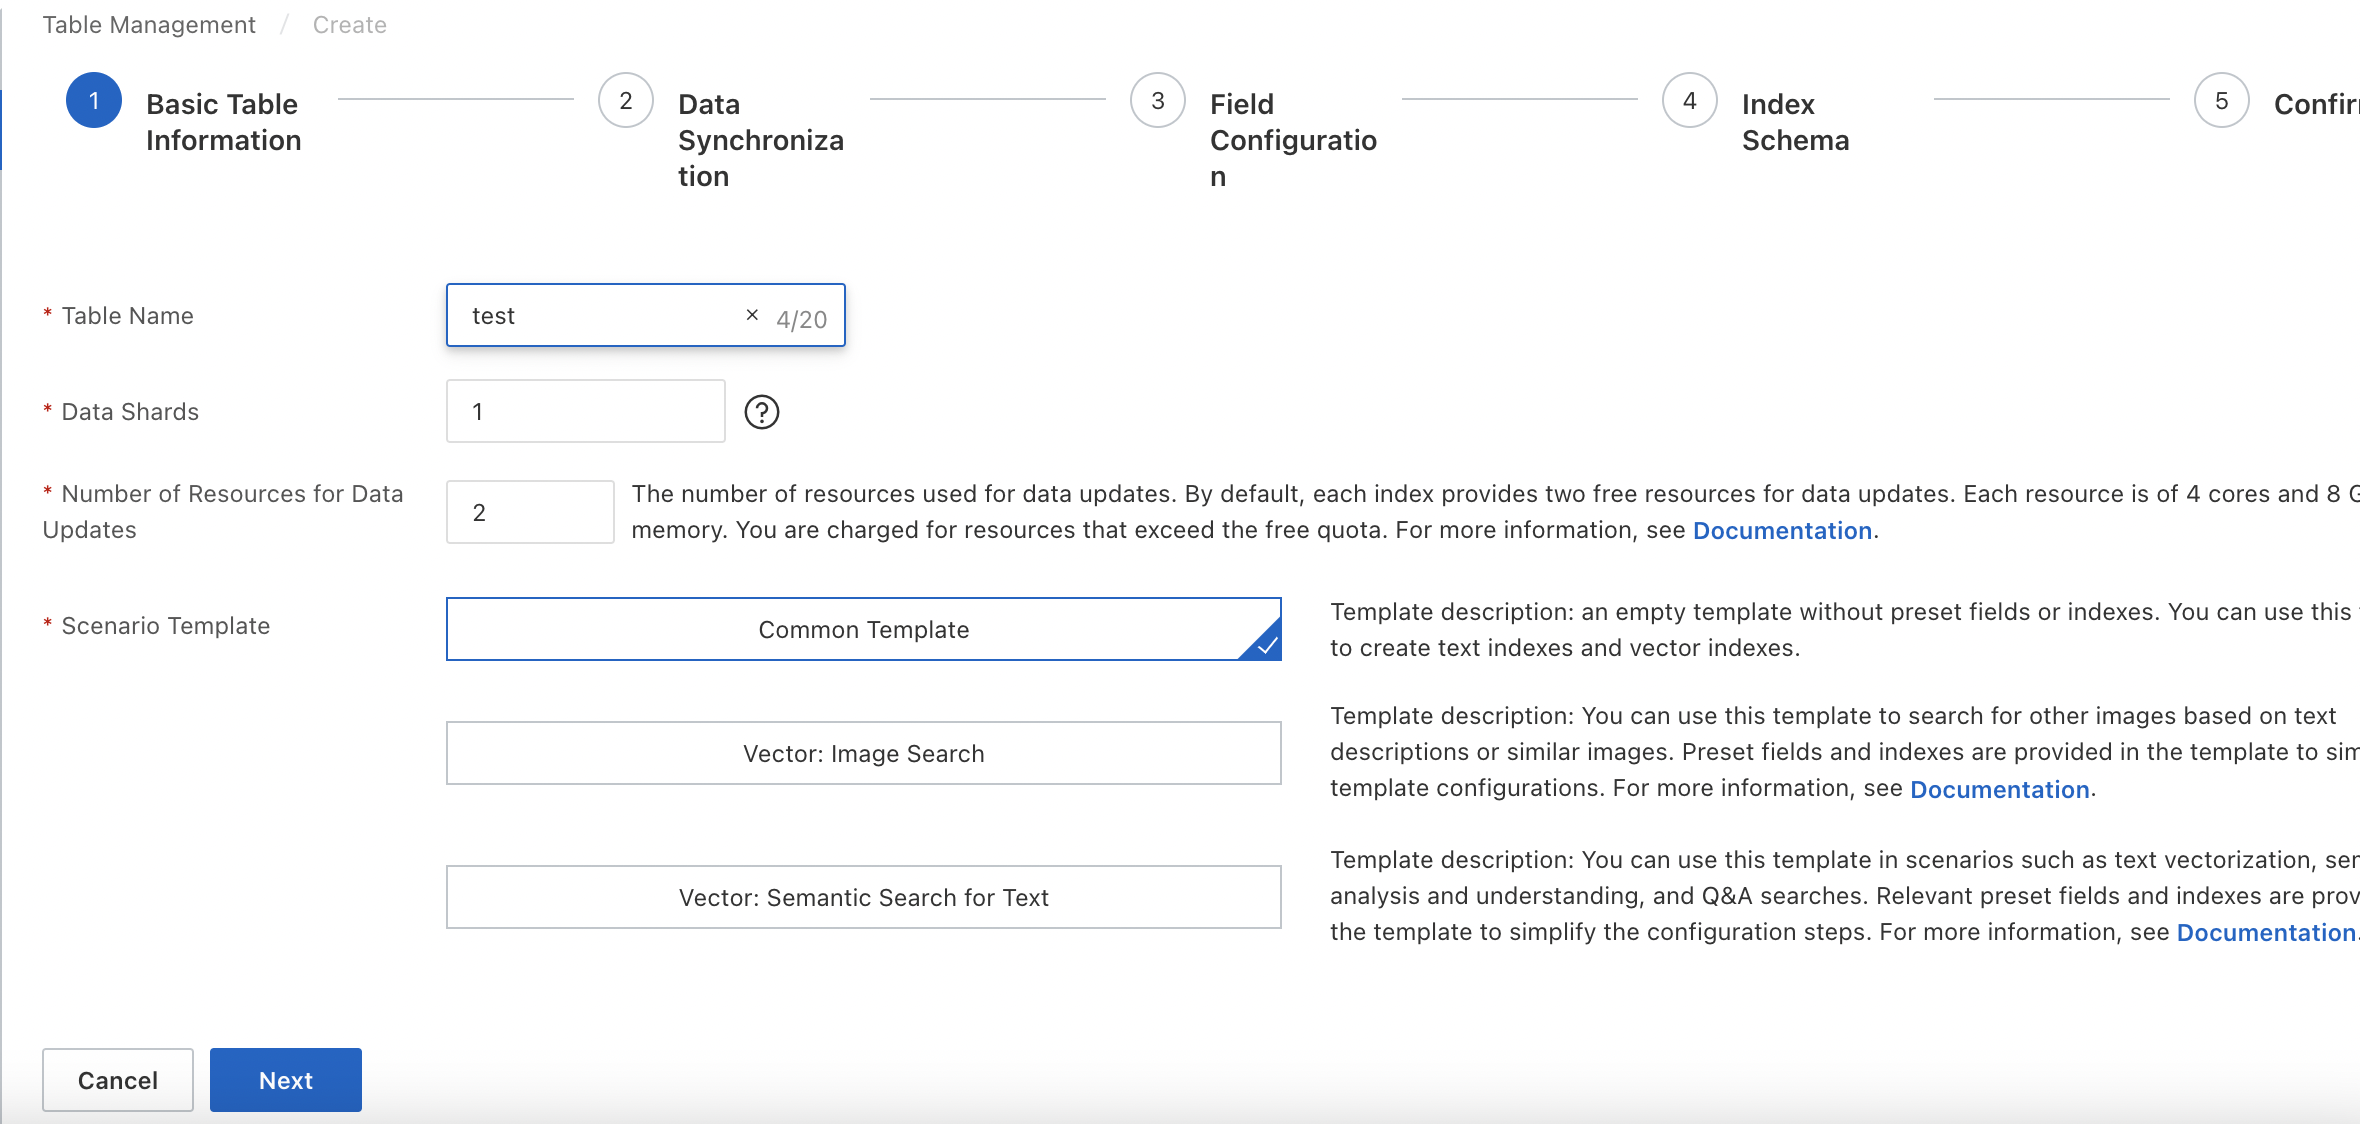
Descripción de parámetros:
Table Name: Nombre personalizado para la tabla.
Number of Shards: Introduzca un número entero positivo de hasta 256. Los shards mejoran la velocidad de las compilaciones completas y el rendimiento de las consultas individuales. En algunas instancias existentes, el número de shards debe ser idéntico para todas las tablas de índice. Como alternativa, una tabla de índice puede tener un solo shard mientras que las demás comparten la misma cantidad.
Data Update Resources: Cantidad de recursos utilizados para las actualizaciones de datos. De forma predeterminada, cada índice incluye una cuota gratuita de dos recursos de actualización de 4 núcleos y 8 GB. Los recursos que excedan esta cuota gratuita se facturan. Para obtener más información, consulte .
Scenario Template: Vector Search Edition proporciona tres plantillas integradas: General, Vector - Image Search y Vector - Text Semantics.
Configure el origen de datos para la sincronización. Una vez validada la configuración, haga clic en Next.
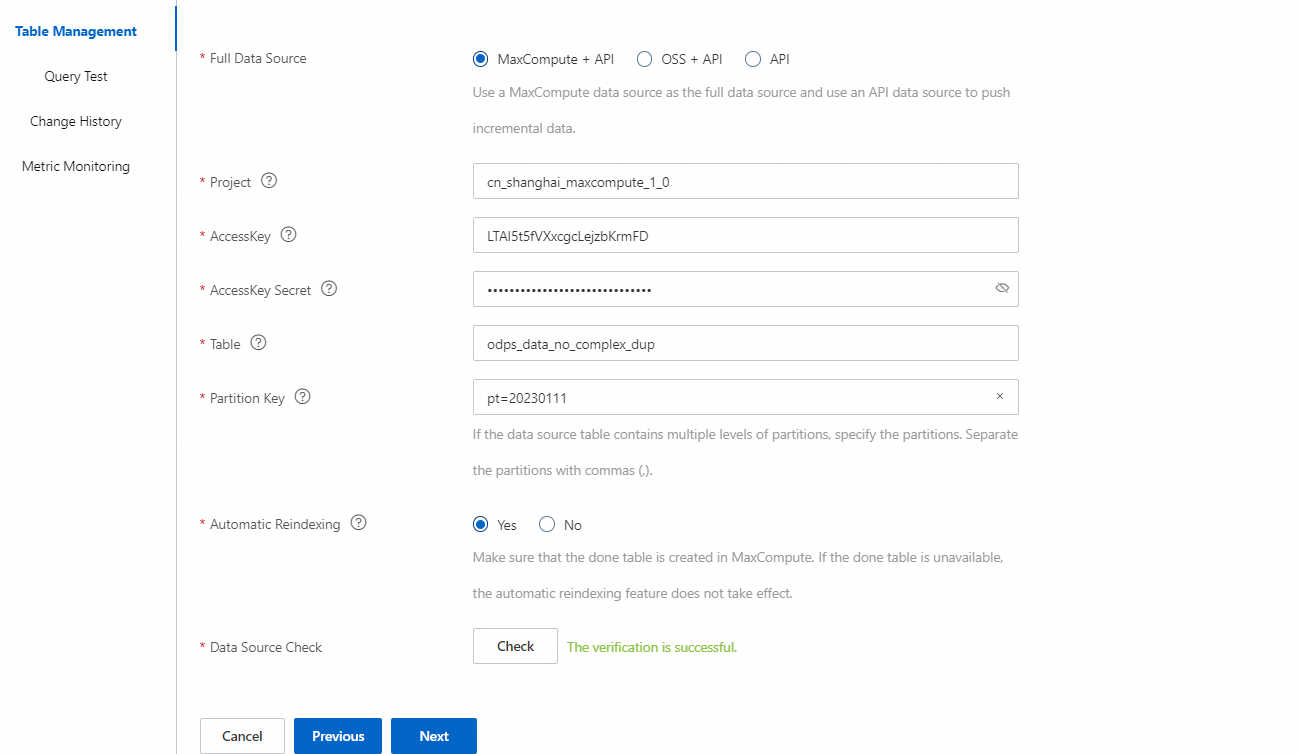
Descripción de parámetros:
Data Source Type: Seleccione MaxCompute.
Project: Nombre del proyecto de MaxCompute de destino.
accesskeyId: AccessKey ID de su cuenta de Alibaba Cloud o usuario de Resource Access Management (RAM).
accesskeySecret: AccessKey secret correspondiente al AccessKey ID.
Table: Nombre de la tabla de MaxCompute de destino.
Partition Key (partition): Debe establecer una clave de partición para un origen de datos de MaxCompute. Por ejemplo: ds=20170626.
Timestamp: Especifica el intervalo de tiempo para recuperar datos incrementales desde una API. El sistema puede recuperar datos incrementales de la API de los últimos tres días.
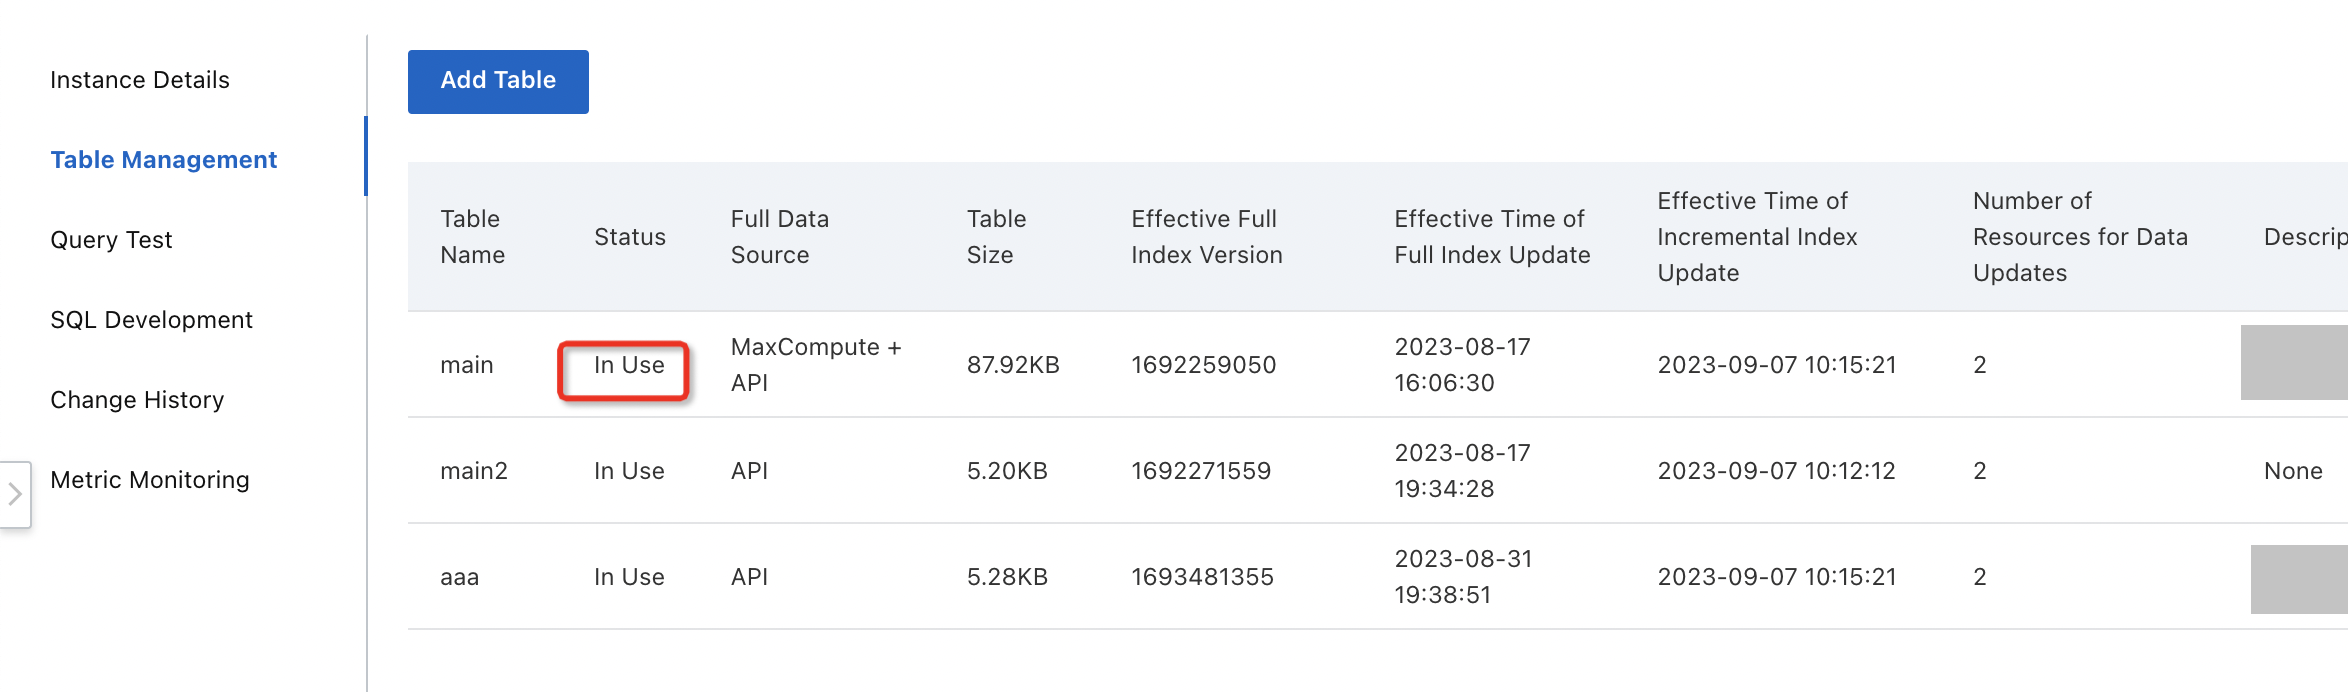
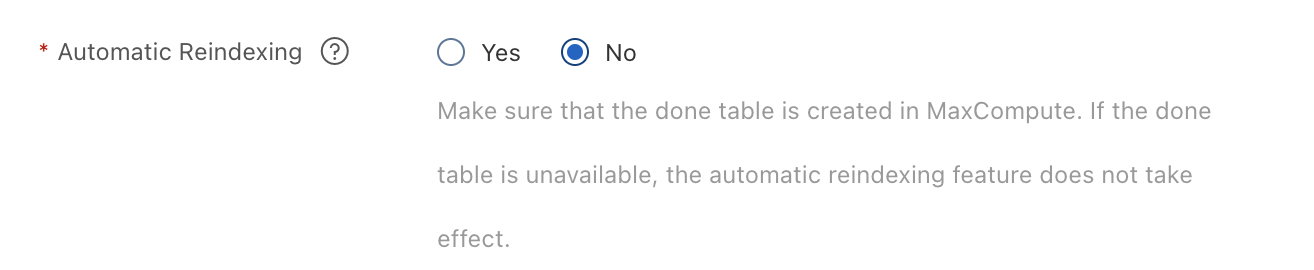
Auto Index Rebuild: Indica si se habilita la reconstrucción automática de índices. Si se habilita, el sistema reconstruye automáticamente el índice de las tablas que referencian este origen de datos al detectar cambios.
Si habilita la reconstrucción automática de índices, debe crear una tabla done. Para consultar las instrucciones, véase Auto index rebuild a continuación.
Configure los campos y haga clic en Next.
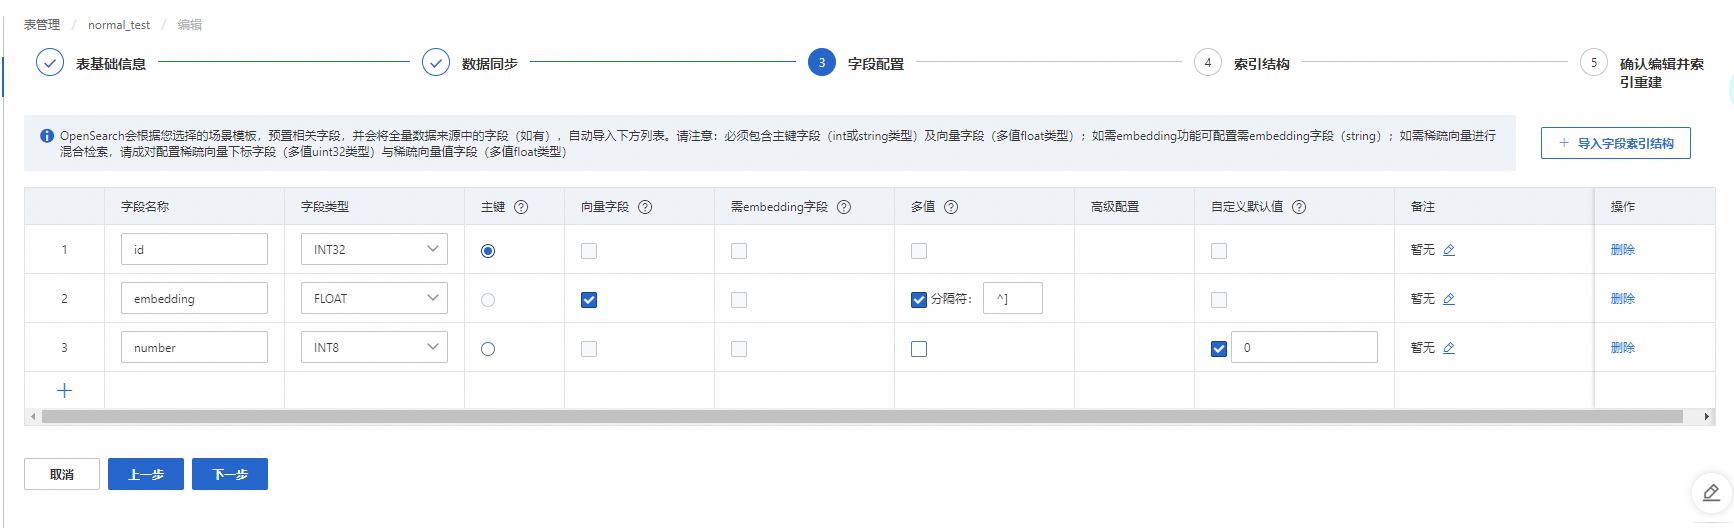
El campo de clave primaria y el campo vectorial son obligatorios. El campo de clave primaria debe ser de tipo INT o STRING, y debe seleccionar la casilla Primary Key para dicho campo. El campo vectorial debe ser de tipo FLOAT, y debe seleccionar la casilla Vector Field para ese campo.
De forma predeterminada, el campo vectorial es de tipo FLOAT con múltiples valores. El separador predeterminado para múltiples valores es el separador ha3
^](codificación UTF-8:\x1D). También puede introducir un separador personalizado para múltiples valores.Si un campo falta o está vacío en los datos, el sistema lo completa automáticamente con un valor predeterminado. Este valor es 0 para tipos numéricos y una cadena vacía para el tipo STRING. También puede especificar un valor predeterminado personalizado.
Configure el esquema de índice y haga clic en Next.
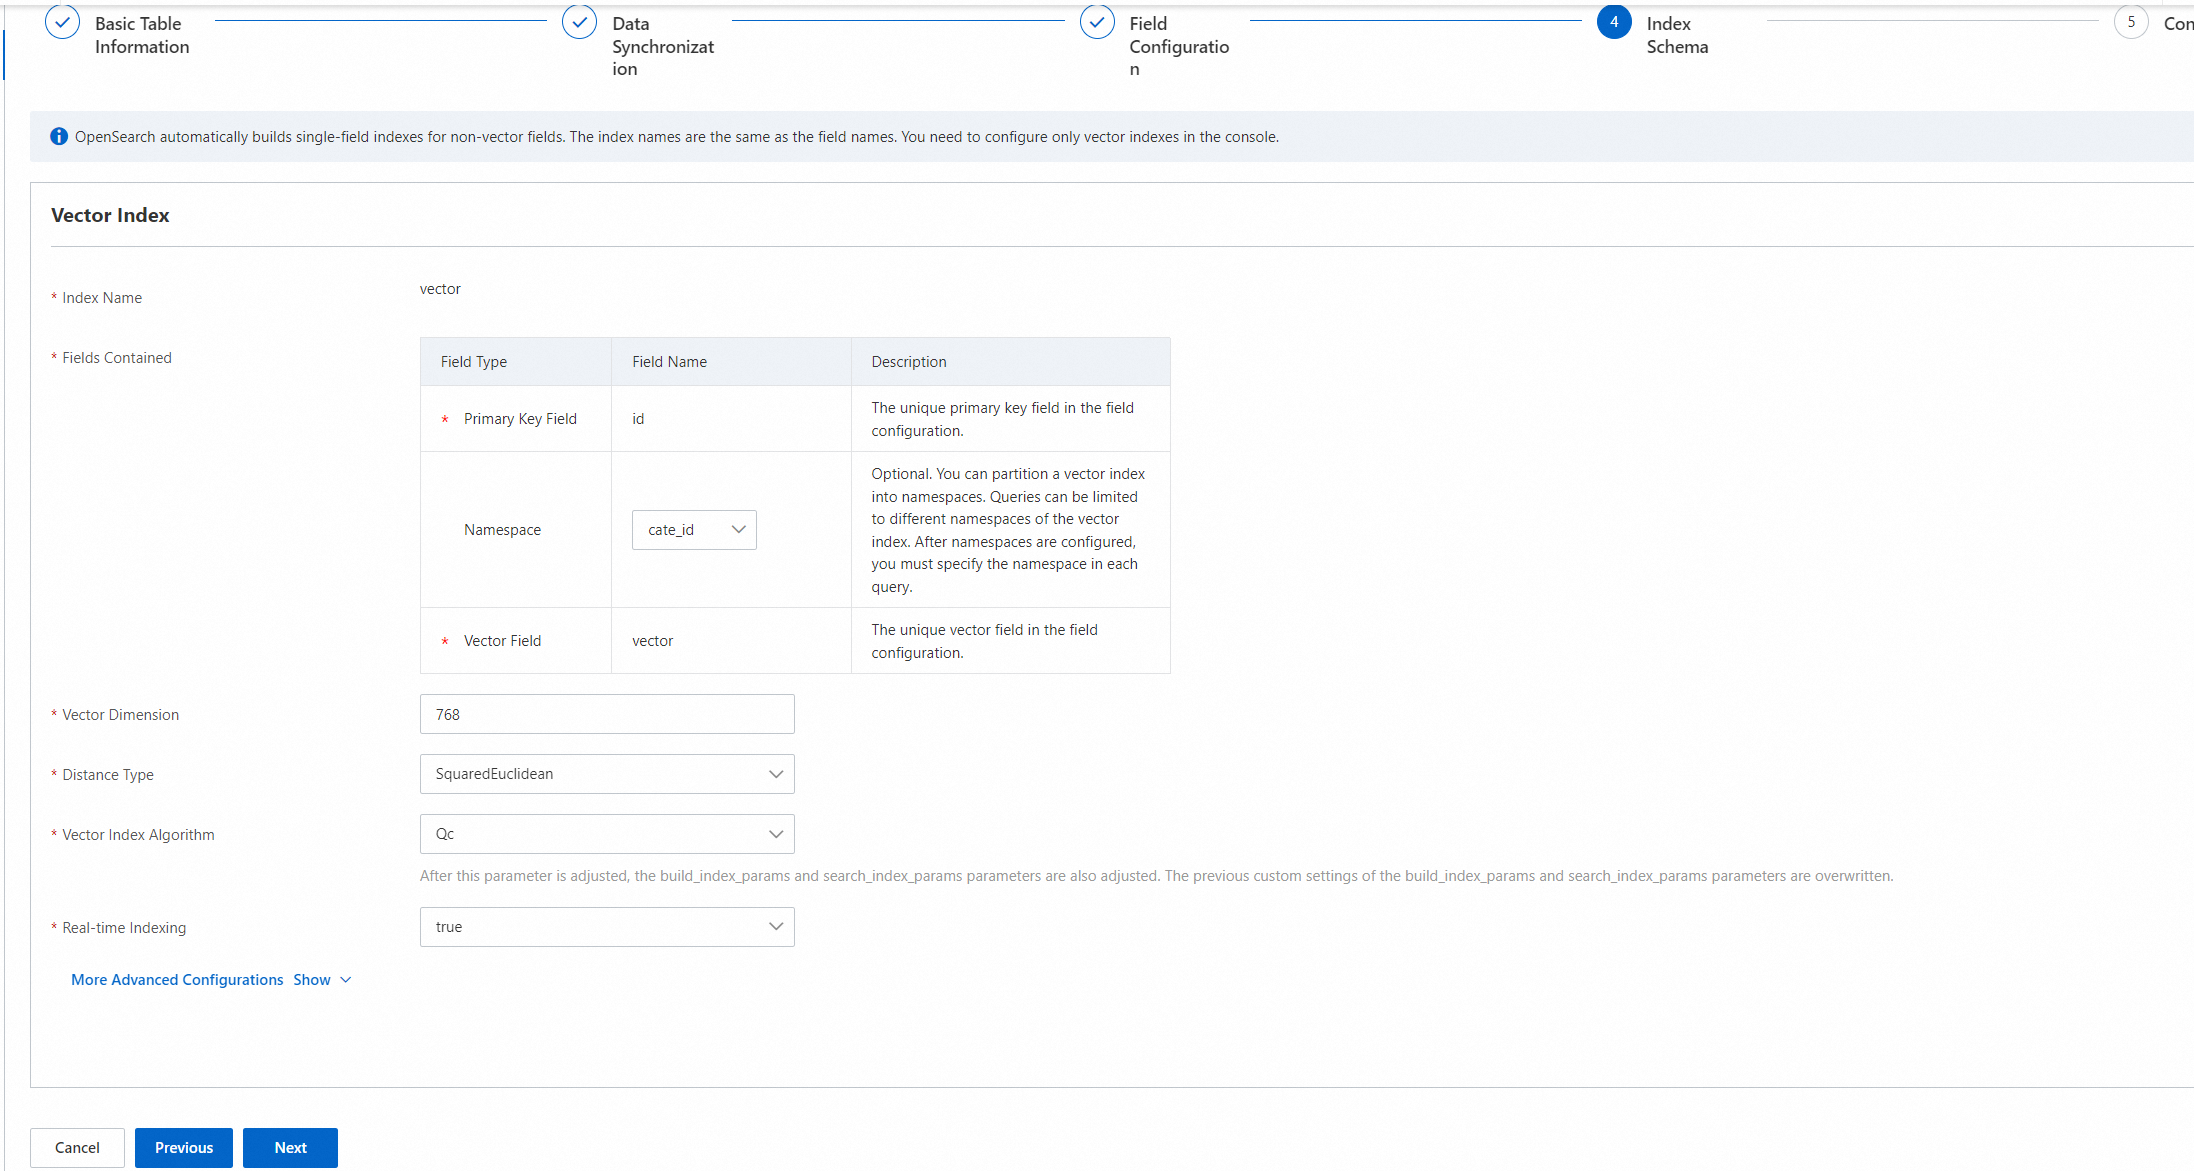
Esta sección describe cómo configurar el índice vectorial:
El campo de clave primaria y el campo vectorial son obligatorios. El campo namespace es opcional y puede dejarse vacío.
Solo puede seleccionar entre estos tres campos fijos. No es posible agregar nuevos campos.
Vector Dimensions: Seleccione las dimensiones según los vectores generados por su modelo.
Distance Metric: Seleccione la métrica según los vectores generados por su modelo. El sistema admite dos métricas de distancia: SquareEuclidean e InnerProduct.
Vector Index Algorithm: Seleccione el algoritmo según los vectores generados por su modelo. El sistema admite los siguientes algoritmos de índice vectorial: Quantized Clustering, linear y HNSW (Hierarchical Navigable Small World).
Real-time Index: Indica si se construye un índice vectorial en tiempo real para los datos incrementales provenientes de la API. El valor predeterminado es true.
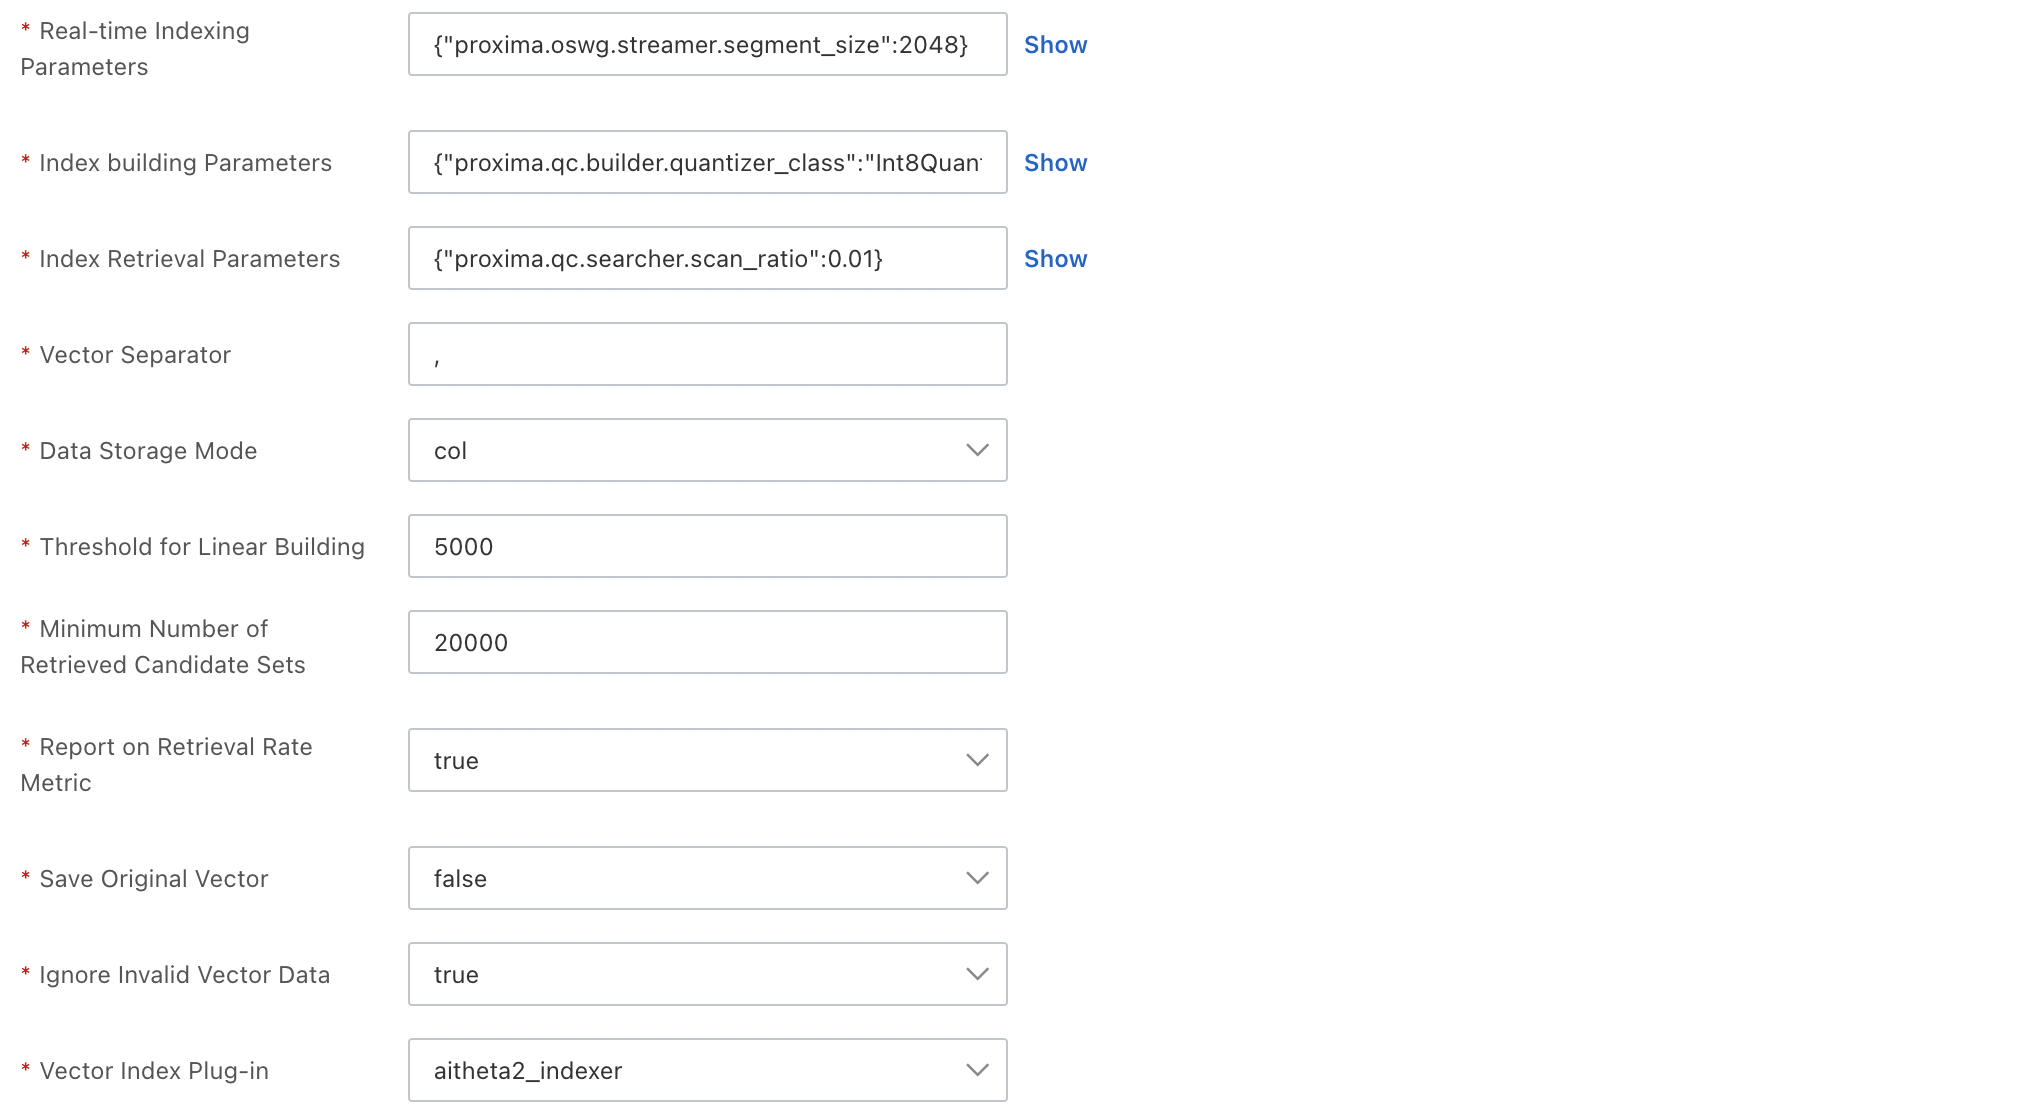
Para configurar otros ajustes avanzados, haga clic para expandir la sección. Para consultar las descripciones de los parámetros, véase General configurations for vector indexes.
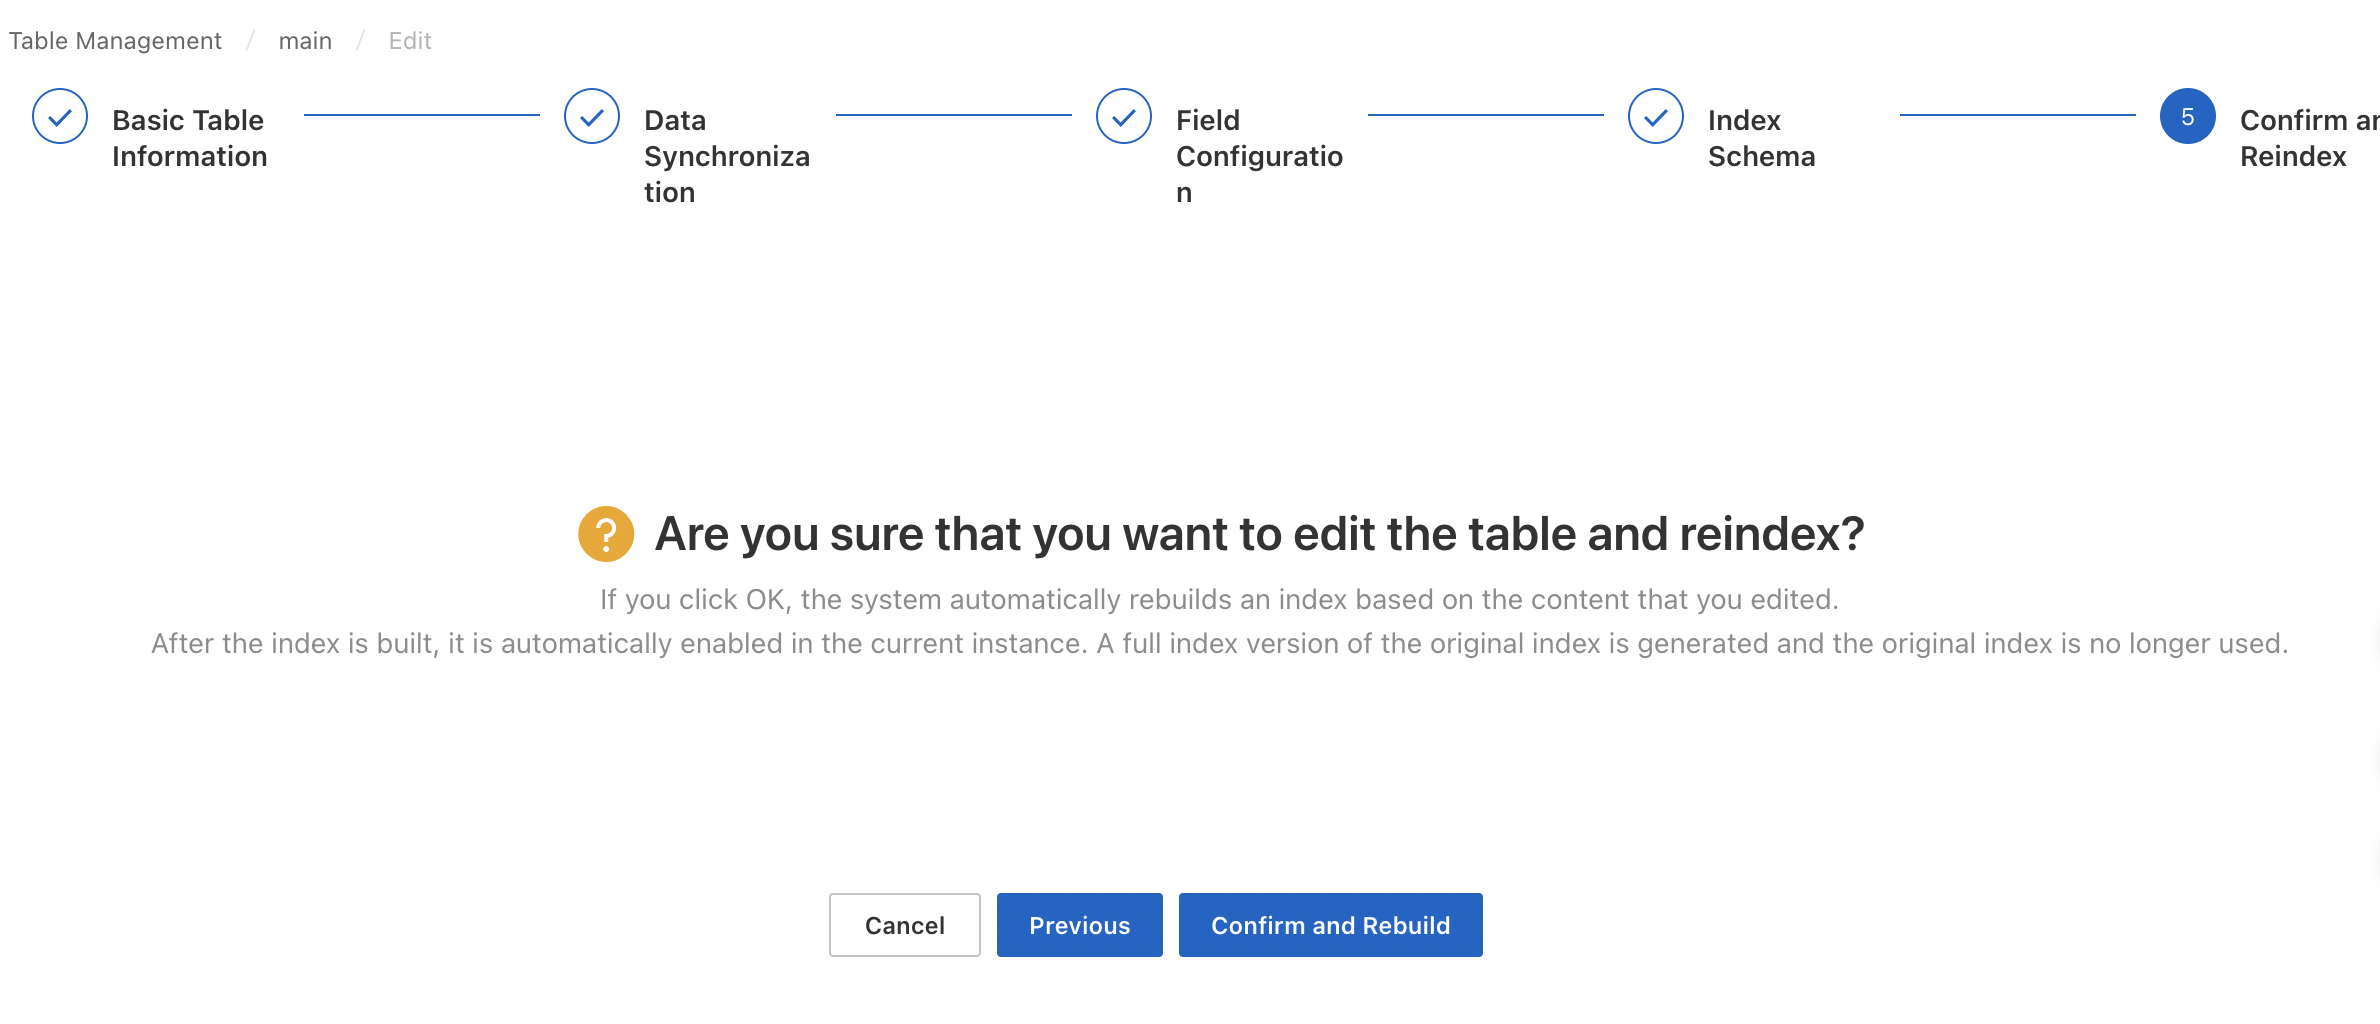
Revise y confirme la configuración. Después de hacer clic en Confirm Creation, el sistema crea la tabla automáticamente.
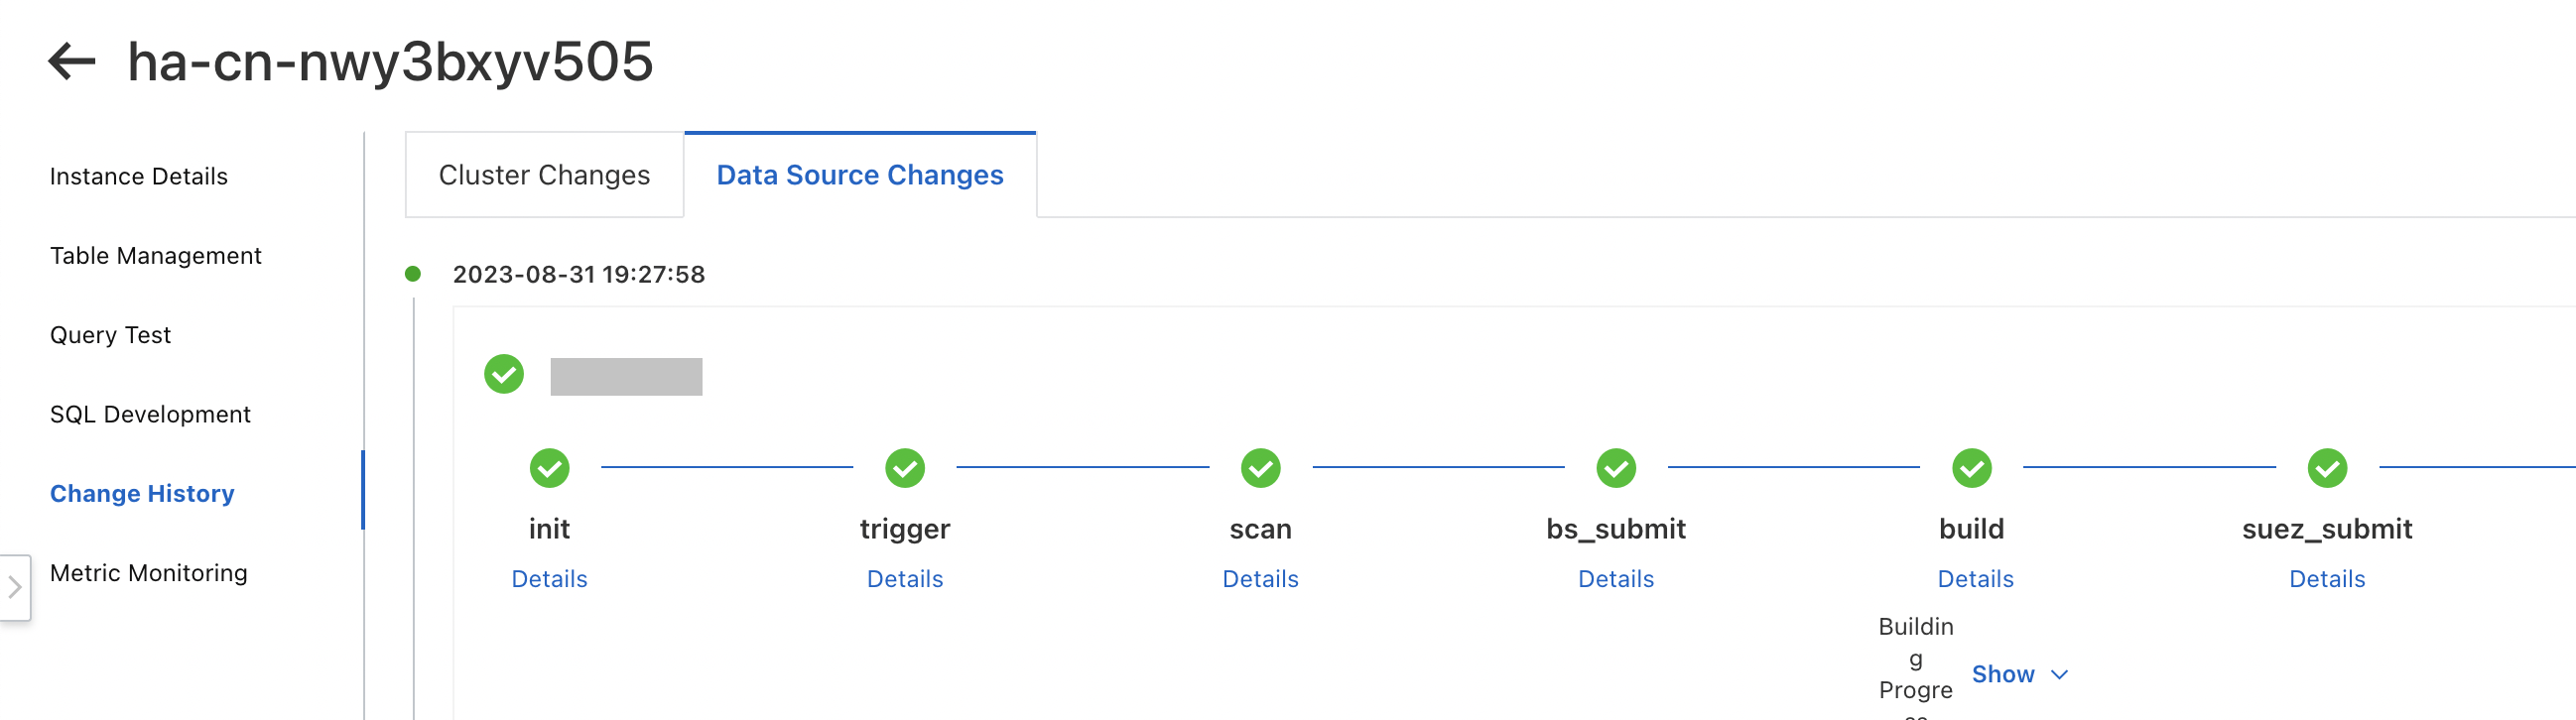
Puede consultar el progreso de creación en el historial de cambios.
Cuando el estado de la tabla cambie a In Use, podrá probar consultas en la página Query Test.
Reconstrucción automática de índices
Propósito de la tabla done: Al habilitar la reconstrucción automática de índices para un origen de datos, la instancia de Vector Search Edition reconstruye automáticamente el índice basándose en los cambios de su tabla done.
Por ejemplo, suponga que su tabla de datos de MaxCompute se llama mytable y está particionada por ds=20220113. Tras configurar el origen de datos y reconstruir el índice por primera vez, se genera diariamente una nueva partición que contiene los datos completos. Si desea que la instancia de Vector Search Edition detecte la nueva partición y reconstruya automáticamente el índice para incorporar los nuevos datos, debe utilizar la función de reconstrucción automática de índices junto con una tabla done.
Procedimiento:
Al agregar el origen de datos, habilite Auto Index Rebuild.
En MaxCompute, cree una tabla done. Si la tabla de datos se llama
mytabley la clave de partición esds, la tabla done debe llamarsemytable_doney su clave de partición también debe serds. Las dos tablas se muestran en MaxCompute de la siguiente manera:
odps:sql:xxx> show tables;
InstanceId: xxx
SQL: .

ALIYUN$****@aliyun.com:mytable          # The full data source table
ALIYUN$****@aliyun.com:mytable_done     # The done table that controls automatic full rebuilds
La siguiente figura muestra la tabla done:
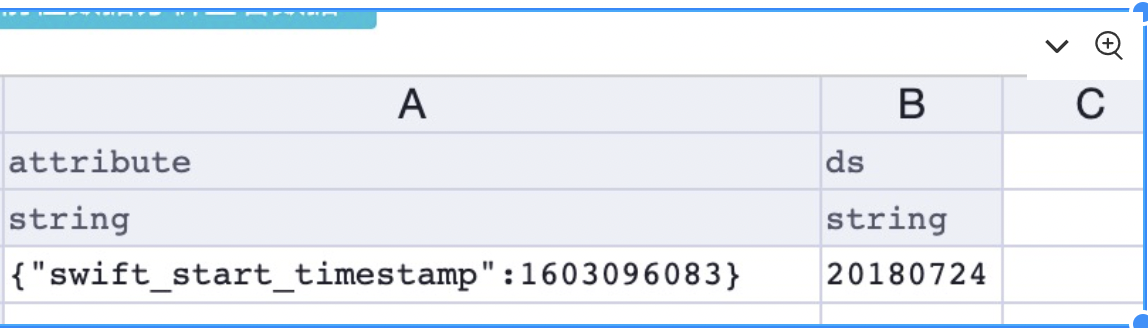
Sentencia para crear la tabla done:
create table mytable_done (attribute string) partitioned by (ds string);Una vez generados los datos para la partición
ds=20220114demytable, configure la tabla done para desencadenar una reconstrucción de índice en la instancia de Vector Search Edition.
-- Add a partition.
alter table mytable_done add if not exists partition (ds="20220114");

-- Insert the signal data for the automatic full rebuild.
insert into table mytable_done partition (ds="20220114") select '{"swift_start_timestamp":1642003200}';
El contenido final de la tabla done es el siguiente:
odps:sql:xxx> select * from mytable_done where ds=20220114 limit 1;
InstanceId: xxx
SQL: .
+-----------+----+
| attribute | ds |
+-----------+----+
| {"swift_start_timestamp":1642003200} | 20220114 |
+-----------+----+
Después de insertar los datos de señal en la tabla done, la instancia de Vector Search Edition detecta dicha señal y desencadena automáticamente una reconstrucción de índice.
La tabla done debe tener como mínimo una clave de partición, y el nombre de la clave de partición debe coincidir con el de la tabla de datos. Por ejemplo, si la clave de partición de la tabla de datos es
ds, la clave de partición de la tabla done también debe serds.La tabla done debe tener únicamente un campo de tipo STRING, y el nombre del campo debe ser
attribute.La partición agregada a la tabla done debe existir en la tabla de datos. Por ejemplo, si la tabla de datos tiene las particiones
ds="20220114",ds="20220115"yds="20220116", la nueva partición agregada a la tabla done debe ser una de estas.Al insertar datos en la tabla done, el valor del campo
attributedebe ser una cadena JSON, como {"swift_start_timestamp":1642003200}. La marca de tiempo indica el desplazamiento inicial para recuperar datos incrementales en tiempo real.
Notas
MaxCompute no admite tablas externas. Debe crear una tabla interna.
La tabla configurada para el origen de datos de MaxCompute debe ser una tabla particionada.
La tabla generada en MaxCompute se utiliza para compilaciones de datos completos. El origen de datos de API se usa para enviar datos en tiempo real.