AI Search Open Platform ofrece un servicio de análisis de documentos mediante API. Puede integrar este servicio en su flujo de trabajo de procesamiento empresarial para convertir datos no estructurados en datos estructurados y utilizarlos en sus aplicaciones de negocio.
|
Nombre del servicio |
ID del servicio |
Descripción |
Límite de QPS de la API |
|
Document Analysis Service |
ops-document-analyze-001 |
Extrae estructuras jerárquicas lógicas (como títulos y párrafos), texto, tablas e imágenes de documentos no estructurados, y devuelve el resultado en un formato estructurado. Tipos de documentos compatibles: TXT, PDF, HTML, DOC, DOCX, PPT y PPTX. |
10 Nota
Para solicitar un límite de QPS de API mayor, envíe un ticket al soporte técnico. |
|
ops-document-analyze-002 |
Analiza múltiples formatos de documentos no estructurados, como archivos PDF e imágenes. Destaca por identificar elementos complejos como tablas, fórmulas y gráficos, además de ofrecer una alta velocidad de inference. Límites de uso: los archivos PDF están limitados a 400 páginas. El cuerpo de la solicitud no puede superar los 8 MB. |
Requisitos previos
-
Obtenga las credenciales de autenticación
La plataforma abierta AI Search requiere una clave de API para la autenticación. Para obtener instrucciones, consulte Get an API key.
-
Obtenga el endpoint del servicio
Puede invocar el servicio a través de la red pública o mediante una VPC. Para más detalles, consulte Get the service endpoint.
Descripción general
El cuerpo de la solicitud no debe superar los 8 MB.
Descripción general
El análisis del contenido de documentos ofrece interfaces síncronas y asíncronas. No se recomienda usar la interfaz síncrona en entornos de producción debido al riesgo de tiempos de espera HTTP, aunque es útil para depuración. Para entornos de producción, se recomienda la interfaz asíncrona. Este proceso consta de dos pasos: primero, cree una tarea de extracción asíncrona para obtener un task_id; luego, consulte periódicamente el estado de la tarea mediante la interfaz asíncrona hasta que esta finalice.
Tarea de extracción asíncrona
Método de solicitud
POST
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/async-
host: el endpoint del servicio. Puede invocar el servicio de API a través de la red pública o mediante una VPC. Para más información, consulte Get a service endpoint.En el panel de navegación izquierdo de la consola, haga clic en API Keys, seleccione el workspace deseado (por ejemplo, default) y consulte el Public API Endpoint y el Private API Endpoint en la sección Access Endpoints.
workspace_name: el nombre del workspace. Por ejemplo,default.service_id: el ID del servicio integrado. Por ejemplo,ops-document-analyze-001.
Parámetros de solicitud
Parámetro de encabezado
Autenticación mediante clave de API
|
Parámetro |
Tipo |
Obligatorio |
Descripción |
Valor de ejemplo |
|
Content-Type |
String |
Sí |
El tipo de medio del cuerpo de la solicitud. |
application/json |
|
Authorization |
String |
Sí |
La clave de API para la autenticación. |
Bearer OS-d1**2a |
Parámetros del cuerpo
|
Parámetro |
Tipo |
Obligatorio |
Descripción |
Ejemplo |
|
service_id |
String |
Sí |
El ID del servicio integrado. |
ops-document-analyze-001 |
|
document.url |
String |
No |
La URL del documento. El archivo debe poder descargarse públicamente mediante HTTP o HTTPS sin autenticación. Debe especificar |
http://opensearch-shanghai.oss-cn-shanghai.aliyuncs.com/chatos/***/file-parser/samples/GB10767.pdf |
|
document.content |
String |
No |
El contenido del documento codificado en Base64. Debe especificar |
"aGVsbG8gd29ybGQ=" |
|
document.file_name |
String |
No |
El nombre del archivo. Si no se especifica este parámetro, el sistema lo infiere a partir de la URL. Este parámetro es obligatorio si proporciona el contenido del documento directamente mediante |
test.pdf |
|
document.file_type |
String |
No |
El tipo de archivo. Si no se especifica este parámetro, el sistema lo infiere a partir de la extensión del Tipos de archivo compatibles: TXT, PDF, HTML, DOC, DOCX, PPT y PPTX. Al utilizar el servicio |
|
|
output.image_storage |
String |
No |
Especifica cómo almacenar las imágenes extraídas del documento.
|
url |
|
strategy.enable_semantic |
Boolean |
No |
Habilita la extracción semántica de estructuras jerárquicas en documentos TXT y otros formatos no estructurados.
|
false |
En documentos donde el índice y el cuerpo no están claramente diferenciados, como se muestra en la siguiente figura, esta función genera una estructura jerárquica más precisa.
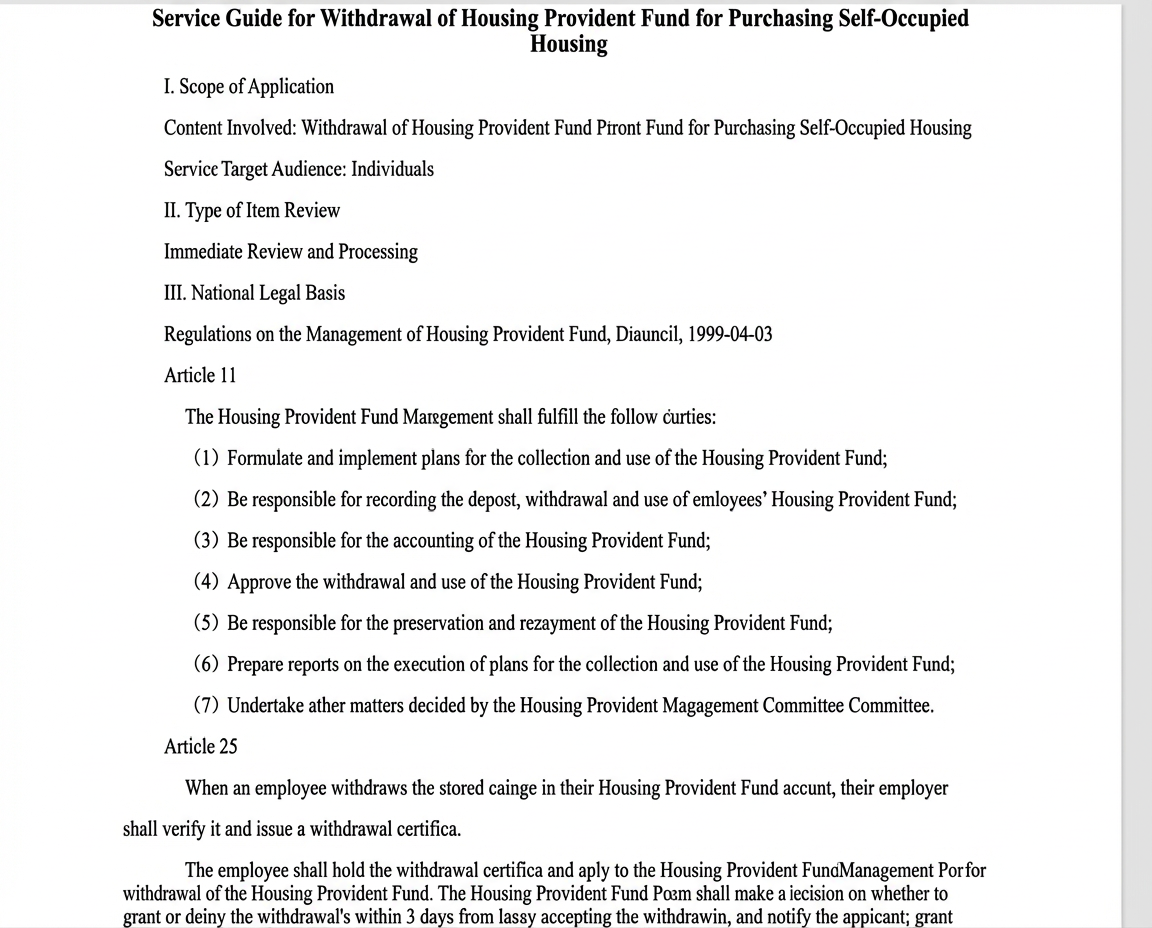
-
Con la extracción de estructura semántica deshabilitada:
curl -XGET -H"Content-Type: application/json" "http://xxx.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/task-status?task_id=f6122788-30e2-4/t8-8d18-33217f6a5e7c" -H "Authorization: Bearer OS xxx" {"request_id":"63877CEA-BB65-43E3-806B-DE4710DEDA98","latency":"3.0","http_code":200,"result":{"status":"SUCCESS","data":"{xxx","事项前置\n10024910010024251717233000000\n\n购买自住住房提取住房公积金 事项前置\n\n购买自住住房提取住房公积金\n金 基金 指南\n\n一、适用范围\n\n及的内容。购买自住住房提取住房公积金\n\n服务对象:\n个人\n二、事项前置类型\n\n即配即办\n\n三、国家/省/市依据\n\n住房公积金相关条例\n\n1999-04-03\n\n第十一条 \n\n住房公积金管理中心履行下列职责:\n\n...(后续为住房公积金管理条例详细内容)\n\n购买1 购买自住住房提取住房公积金流程福利\n\n[IMO]:data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAYABeAAD..."}} -
Cuando la extracción de estructura semántica está habilitada, el ejemplo de respuesta es el siguiente. Los marcadores Markdown
##y###en el campocontentindican la estructura jerárquica de directorios reconocida, mientras que\nrepresenta un salto de línea.{"request_id":"9F7B4F1A-4EE0-4430-A537-2C21B01E3676","latency":3.0,"http_code":200,"result":{"status":"SUCCESS","data":{"content":"... 事项编码:1\n## 适用范围\n及的内容:购买自住住房提取住房公积金\n(含购买自住住房提取住房公积金和购服务指南)的制定和发布 事项名称:购买自住住房提取住房公积金 适用范围\n及的内容:购买自住住房提取住房公积金\n\n### 二 事项审查类型\n即时即办\n### 三 国家法律依据\n住房公积金管理条例(国务院 1999-04-03...\n(二)购买自住住房的提取...住房公积金的保值和归集...\n使用等情况...在住房公积金的核算...使用...住房公积金的保值和归集...\n...管理中心应当...提取住房公积金...自3日内作出准予提取或者不准提取的决定,并通知申请人;准予提取的,由受委托银行办理支付手续...\n...建设住房公积金...储存余额的存储方式...建设住房公积金...\n...住房公积金流程...相关申请材料文件\n...\n附录3 帮助购趣群答..."}}}NotaSi
usage.semantic_token_countdevuelve un valor, la extracción de la estructura semántica se realizó correctamente y se cobra la tarifa de tokens correspondiente a este elemento de facturación. Si no se devuelve ningún valor, la extracción falló y no se aplica ningún cargo.
La siguiente tabla muestra la duración estimada y el recuento de tokens semánticos tras habilitar la extracción de resultados semánticos.
|
Páginas del PDF |
Tokens |
Sin jerarquía semántica |
Con jerarquía semántica |
|
|
Tiempo (s) |
Tiempo (s) |
Tokens semánticos |
||
|
7 |
11504 |
2 |
49 |
36243 |
|
25 |
10375 |
1 |
33 |
59332 |
|
42 |
41435 |
5 |
68 |
130717 |
Parámetros de respuesta
|
Parámetro |
Tipo |
Descripción |
Ejemplo |
|
result.task_id |
String |
El ID de la tarea asíncrona para el análisis del documento. |
d5a4019e-853a-****-b5b6-8053d9f5a9fc |
Ejemplo con cURL
curl --location 'http://****shanghai.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/' \
--header 'Authorization: Bearer your API key' \
--header 'Content-Type: application/json' \
--data '{
  "document":{
      "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241018/jahnyn/%E8%A7%A3%E6%9E%90%E6%B5%8B%E8%AF%95.doc"
    },
    "output" :{
      "image_storage":"base64"
    },
    "strategy": {
      "enable_semantic":true
    }
}'
Ejemplos de respuesta
Respuesta correcta
{
    "request_id": "D5A4019E-853A-4E20-****-8053D9F5A9FC",
    "latency": 5.0,
    "http_code": 200,
    "result": {
        "task_id": "d5a4019e-853a-****-b5b6-8053d9f5a9fc"
    }
}
Respuesta de error
Si una solicitud falla, la respuesta describe el error en los campos code y message.
{
    "request_id": "590A7EB8-AA84-****-AF31-8C35DC965972",
    "latency": 0.0,
    "code": "InvalidParameter",
    "http_code": 400,
    "message": "document.file_name required"
}
Consulta de tareas asíncronas
Método de solicitud
GET
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/async/task-status?task_id=${task_id}host: el endpoint del servicio. Puede invocar el servicio de API a través de la red pública o mediante una VPC. Para más información, consulte Get a service endpoint.workspace_name: el nombre del workspace. Por ejemplo,default.service_id: el ID del servicio integrado. Por ejemplo,ops-document-analyze-001.task_id: el ID de la tarea asíncrona devuelto por la solicitud de creación de la tarea. Por ejemplo,d5a4019e-853a-****-b5b6-8053d9f5a9fc.
Parámetros de solicitud
Parámetros de encabezado
Autenticación mediante clave de API
|
Parámetro |
Tipo |
Obligatorio |
Descripción |
Ejemplo |
|
Content-Type |
String |
Sí |
El tipo de medio de la solicitud. El valor debe ser application/json. |
application/json |
|
Authorization |
String |
Sí |
La clave de API para la autenticación, con el prefijo Bearer . |
Bearer OS-d1**2a |
Parámetros de respuesta
|
Parámetro |
Tipo |
Descripción |
Valor |
|
result.task_id |
String |
El ID de la tarea asíncrona de análisis de documentos. |
24c3ad59-****-40cf-974b-b63d63e0571 |
|
result.status |
String |
El estado de la tarea. Los valores posibles son:
|
PENDING |
|
result.error |
String |
El mensaje de error para una tarea fallida. De lo contrario, este parámetro está vacío. |
Failed to decrypt the document. |
|
result.data |
Object |
El resultado del análisis del documento. |
markdown |
|
result.data.content |
String |
El contenido analizado del documento.
|
"XXX" |
|
result.data.content_type |
String |
El formato del contenido analizado.
|
markdown |
|
result.data.page_num |
Int |
El número de páginas del documento. |
15 |
|
request_id |
String |
El identificador único para esta llamada a la API. |
B4AB89C8-B135-****-A6F8-2BAB8018688 |
|
latency |
Float/Int |
La latencia de la solicitud en milisegundos (ms). |
10 |
|
usage |
Object |
La información de medición para esta llamada a la API. |
"usage": { "token_count": 123, "table_count": 5, "image_count": 6, "semantic_token_count":3068 } |
|
usage.token_count |
Int |
El recuento de caracteres en el documento. |
1234 |
|
usage.table_count |
Int |
El recuento de tablas en el documento. |
5 |
|
usage.image_count |
Int |
El recuento de imágenes en el documento. |
6 |
|
usage.semantic_token_count |
Int |
El recuento de caracteres en la entrada del modelo de extracción semántica. |
3068 |
Solicitud con cURL
curl -XGET -H"Content-Type: application/json" \
"http://****-hangzhou.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/task-status?task_id=110d6349-2e51-****-8bfb-25e5de434686" \
-H "Authorization: Bearer Your API key"
Ejemplos de respuesta
Respuesta correcta
{
    "request_id": "27F9CEC3-9052-****-83FF-E7957B680492",
    "latency": 13.0,
    "http_code": 200,
    "result": {
        "status": "SUCCESS",
        "data": {
            "content": "Provided proper attribution is provided, Alibaba hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works....",
            "content_type": "markdown",
            "page_num": 15
        },
        "task_id": "24c3ad59-b196-****-974b-b63d63e05895"
    },
    "usage": {
        "token_count": 31867,
        "table_count": 4,
        "image_count": 8,
        "semantic_token_count":3068
    }
}
Respuesta de error
Si una solicitud de acceso falla, los campos code y message de la respuesta explican el error.
Creación de una tarea de análisis síncrona
Evite usar la interfaz síncrona en un entorno de producción debido al riesgo de tiempos de espera HTTP. En su lugar, utilícela para depuración.
Método de solicitud
POST
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/syncParámetros
host: el endpoint del servicio. Puede invocar el servicio de API a través de la red pública o mediante una VPC. Para más información, consulte Get a service endpoint.workspace_name: el nombre del workspace. Por ejemplo,default.service_id: el ID del servicio integrado. Por ejemplo,ops-document-analyze-001.
Parámetros de solicitud
Parámetro de encabezado
Autenticación mediante clave de API
|
Parámetro |
Tipo |
Obligatorio |
Descripción |
Valor |
|
Content-Type |
String |
Sí |
El tipo de solicitud. |
application/json |
|
Authorization |
String |
Sí |
Su clave de API. |
Bearer OS-d1**2a |
Parámetro del cuerpo
|
Parámetro |
Tipo |
Obligatorio |
Descripción |
Valor de ejemplo |
|
document.url |
String |
No |
La URL pública del documento. Debe ser accesible mediante HTTP o HTTPS sin autenticación. Debe especificar |
http://opensearch-shanghai.oss-cn-shanghai.aliyuncs.com/chatos/***/file-parser/samples/GB10767.pdf |
|
document.content |
String |
No |
El contenido del documento codificado en Base64. Debe especificar |
"aGVsbG8gd29ybGQ=" |
|
document.file_name |
String |
No |
El nombre del archivo. Si se omite este parámetro, el sistema infiere el nombre a partir de document.url. Este parámetro es obligatorio cuando se especifica document.content. |
test.pdf |
|
document.file_type |
String |
No |
El tipo de archivo. Si se omite este parámetro, el sistema infiere el tipo de archivo a partir de la extensión del Tipos de archivo compatibles: TXT, PDF, HTML, DOC, DOCX, PPT y PPTX. |
|
|
output.image_storage |
String |
No |
El método de almacenamiento de imágenes.
|
url |
|
strategy.enable_semantic |
Boolean |
No |
Especifica si se debe habilitar la extracción de estructura semántica. El valor predeterminado es |
false |
Parámetros de respuesta
|
Parámetro |
Tipo |
Descripción |
Ejemplo |
|
result.status |
String |
El estado de la tarea. Los valores válidos incluyen:
|
PENDING |
|
result.error |
String |
El mensaje de error devuelto cuando el estado es |
Document decryption failed |
|
result.data |
Object |
El resultado del análisis del documento. |
markdown |
|
result.data.content |
String |
El contenido analizado del documento.
|
"XXX" |
|
result.data.content_type |
String |
El tipo de contenido del documento analizado. Los valores válidos incluyen:
|
markdown |
|
result.data.page_num |
Int |
El recuento de páginas del documento. |
15 |
|
request_id |
String |
Un identificador único para la solicitud. |
B4AB89C8-B135-****-A6F8-2BAB801A2CE4 |
|
latency |
Float/Int |
La latencia de la solicitud en milisegundos (ms). |
10 |
|
usage |
Object |
Detalles de uso de la solicitud. |
"usage": { "token_count": 123, "table_count": 5, "image_count": 6, "semantic_token_count":3068 } |
|
usage.token_count |
Int |
El número total de tokens en el documento. |
1234 |
|
usage.table_count |
Int |
El número total de tablas en el documento. |
5 |
|
usage.image_count |
Int |
El número total de imágenes en el documento. |
6 |
|
usage.semantic_token_count |
Int |
El número total de tokens semánticos utilizados como entrada para el modelo de extracción semántica. |
3068 |
cURL
curl --location 'http://****shanghai.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/sync/' \
--header 'Authorization: Bearer your API key' \
--header 'Content-Type: application/json' \
--data '{
  "document":{
      "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241018/jahnyn/%E8%A7%A3%E6%9E%90%E6%B5%8B%E8%AF%95.doc"
    },
    "output" :{
      "image_storage":"base64"
    },
    "strategy": {
      "enable_semantic":true
    }
}'
Ejemplos de respuesta
Ejemplo de respuesta correcta
{
    "request_id": "27F9CEC3-9052-****-83FF-E7957B689D04",
    "latency": 13.0,
    "http_code": 200,
    "result": {
        "status": "SUCCESS",
        "data": {
            "content": "Provided proper attribution is given, Alibaba hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works....",
            "content_type": "markdown",
            "page_num": 15
        }
    },
    "usage": {
        "token_count": 31867,
        "table_count": 4,
        "image_count": 8,
        "semantic_token_count":3068
    }
}
Ejemplo de respuesta de error
Si una solicitud de acceso falla, la respuesta indica el error en los campos code y message.
{
    "request_id": "6F33AFB6-A35C-****-AFD2-9EA16CCF4383",
    "latency": 2.0,
    "code": "InvalidParameter",
    "http_code": 400,
    "message": "JSON parse error: Cannot deserialize value of type `ImageStorage` from String \\"xxx\\"
}
Códigos de estado
|
Código de estado HTTP |
Código de error |
Descripción |
|
200 |
- |
La solicitud se realizó correctamente. Este estado se devuelve incluso si la tarea falló. Compruebe el campo |
|
404 |
BadRequest.TaskNotExist |
La tarea no existe. |
|
400 |
InvalidParameter |
La solicitud no era válida. |
|
500 |
InternalServerError |
Ocurrió un error interno. |
Para más información sobre los códigos de estado, consulte status codes.