La página Q&A Test le permite interactuar con su base de conocimientos antes de desplegarla en producción. Introduzca una pregunta para que el modelo recupere contenido relevante de los documentos cargados y genere una respuesta. Ajuste los parámetros para optimizar la precisión de la recuperación y la calidad de la respuesta; después, aplique la configuración validada en su aplicación.
Requisitos previos
Antes de empezar, asegúrese de haber cumplido con lo siguiente:
Creado una instancia de OpenSearch LLM-Based Conversational Search Edition. Consulte Create an instance.
Completado la configuración de datos. Consulte Data configuration.
Ejecutar una prueba de preguntas y respuestas
Los siguientes pasos utilizan un archivo de video como ejemplo.
Inicie sesión en OpenSearch console y seleccione LLM-Based Conversational Search Edition. En el panel de navegación izquierdo, haga clic en Instance Management, busque su instancia y haga clic en Manage en la columna Actions.
-
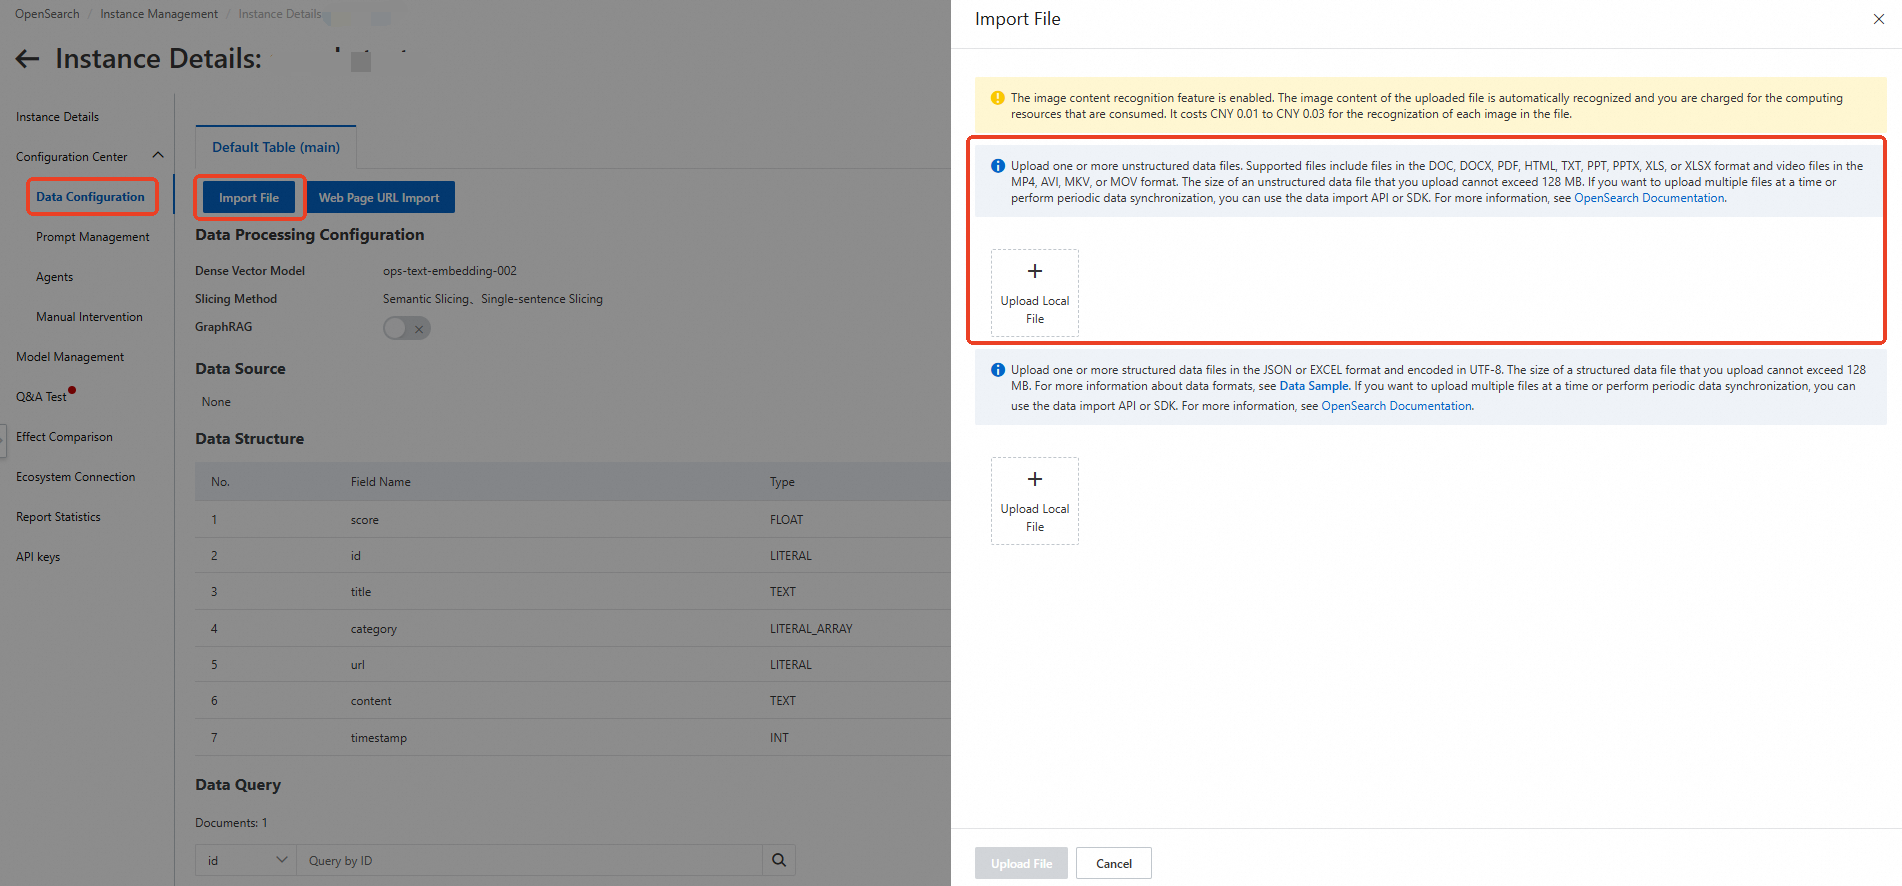
En la página Instance Details, haga clic en Configuration Center y luego en Data Configuration. Haga clic en File Import, seleccione el archivo que desea cargar y haga clic en Upload File.
-
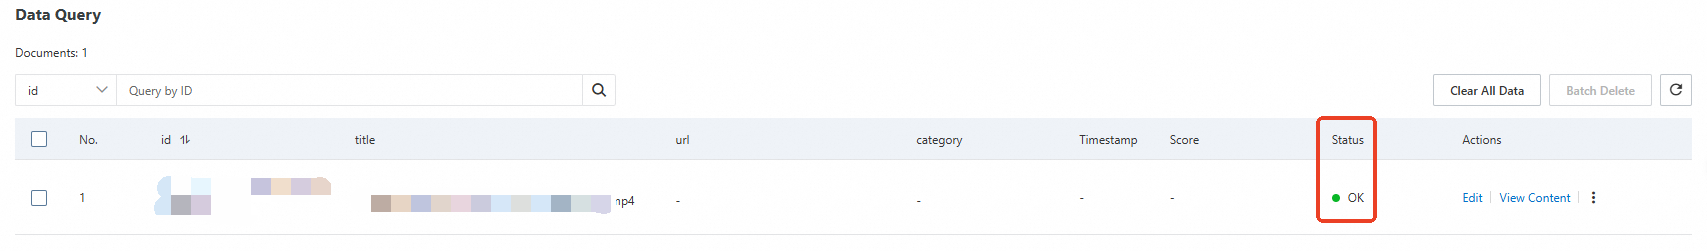
Espere a que finalice la carga. Cuando el estado de la consulta de datos muestre Completed, haga clic en Q&A Test en el panel de navegación izquierdo.
En la esquina superior derecha, haga clic en Model Configuration y establezca los parámetros según su caso de uso. Para obtener una descripción de cada parámetro, consulte Parameters.
Introduzca una pregunta en el cuadro de diálogo y haga clic en Send. La respuesta se genera con base en el contenido de su base de conocimientos.
Interpretar resultados
La respuesta se basa en los documentos de su base de conocimientos. Para ver qué documentos contribuyeron a una respuesta, establezca options.chat.link en true. La respuesta incluirá marcadores de cita en línea ([^1^], [^2^], etc.) que corresponden a los documentos recuperados listados en la sección de referencias.
Para obtener también los fragmentos de documentos recuperados sin procesar, establezca options.retrieve.return_hits en true. La respuesta incluirá un campo search_hits con los fragmentos recuperados.
Parámetros
Configure los parámetros desde el panel Model Configuration. Los parámetros se agrupan por función.
También puede ejecutar pruebas de preguntas y respuestas mediante API o SDK. Los nombres de los parámetros en las tablas siguientes corresponden directamente a los campos de solicitud de la API. Consulte API operations y OpenSearch SDKs .
Parámetros de preguntas y respuestas
| Parámetro | Tipo | Obligatorio | Predeterminado | Descripción |
|---|---|---|---|---|
options.chat.model | String | Sí | opensearch-qwen | El modelo de lenguaje grande (LLM) utilizado para generar respuestas. La longitud de contexto compatible y los tokens máximos de entrada y salida varían según el modelo. |
Prompt | String | No | Plantilla de prompt predeterminada | La plantilla de prompt utilizada para la prueba. Consulte Gestionar prompts para ver las plantillas compatibles. |
question.session | Boolean | No | true | Controla el comportamiento de la conversación multironda. false deshabilita las conversaciones multironda. true devuelve resultados basados en las rondas de conversación más recientes. session limita la conversación a una fuente específica y devuelve resultados basados en el contexto de conversaciones con la misma fuente. |
options.chat.enable_deep_search | Boolean | No | false | Habilita deep search. Cuando está habilitada, el modelo realiza inference en múltiples rondas para devolver resultados más completos, aunque esto incrementa la latencia y el uso de recursos. |
options.retrieve.web_search.enable | Boolean | No | false | Habilita la búsqueda web. Cuando está activada, las respuestas se nutren de resultados web en tiempo real además de su base de conocimientos, lo que aumenta el tiempo de respuesta y el consumo de recursos. |
options.chat.stream | Boolean | No | true | Habilita la salida en streaming. Cuando es true, la respuesta se entrega mediante codificación de transferencia fragmentada HTTP. |
Parámetros del prompt
Estos parámetros personalizan el comportamiento de la plantilla de prompt integrada.
|
Parámetro |
Tipo |
Predeterminado |
Valores válidos |
Descripción |
|
|
String |
|
|
El tono de las respuestas del modelo. |
|
|
String |
|
|
El nivel de detalle en las respuestas. |
|
|
String |
|
|
El mensaje alternativo cuando el modelo no encuentra una respuesta. |
|
|
String |
|
|
El idioma de la respuesta generada. |
|
|
Boolean |
— |
— |
Habilita un rol personalizado para responder preguntas. |
|
|
String |
— |
— |
El nombre del rol personalizado. Ejemplo: |
|
|
String |
|
|
El formato de la respuesta generada. |
Parámetros de recuperación de documentos
Estos parámetros controlan cómo busca el sistema en su base de conocimientos. Hay dos estrategias de recuperación disponibles, dependiendo de si el modelo de vectores dispersos está habilitado:
Semántica (solo densos): Utiliza incrustaciones de vectores densos para la recuperación. Establezca
options.retrieve.doc.operatorpara controlar la coincidencia de términos.Híbrida (densos + dispersos): Combina la coincidencia de vectores densos y dispersos. Utilice
options.retrieve.doc.dense_weightpara equilibrar ambas señales. El modo híbrido se aplica cuando el modelo de vectores dispersos está habilitado en su configuración de datos.
|
Parámetro |
Tipo |
Predeterminado |
Descripción |
|
|
Integer |
|
El número de fragmentos de documentos que se deben recuperar. Valores válidos: (0, 50]. Aumentar este valor proporciona más contexto al modelo, pero puede introducir ruido de fragmentos menos relevantes. |
|
|
Float |
|
El umbral de puntuación vectorial para la recuperación de documentos. Con el vector disperso deshabilitado: valores más bajos aumentan la exhaustividad pero reducen la precisión; el rango es 0–2.0. Con el vector disperso habilitado: valores más altos aumentan la precisión pero reducen la exhaustividad. |
|
|
Float |
|
El peso del vector denso cuando el modelo de vectores dispersos está habilitado. Valores válidos: (0.0, 1.0). Valores más altos favorecen la similitud semántica; valores más bajos dan mayor peso a la coincidencia dispersa (basada en palabras clave). |
|
|
String |
|
El operador aplicado entre términos tras la segmentación de texto. Solo aplica cuando el modelo de vectores dispersos está deshabilitado. |
|
|
String |
— |
Una fórmula personalizada para clasificar los documentos recuperados. Para la sintaxis, consulte Funciones de clasificación fina. No se admiten la relevancia algorítmica ni la relevancia por ubicación geográfica. |
|
|
String |
— |
Filtra documentos antes de la recuperación con base en un campo específico. Campos compatibles: |
Parámetros de imágenes de referencia
|
Parámetro |
Tipo |
Predeterminado |
Descripción |
|
|
Float |
|
El umbral de puntuación vectorial para la recuperación de imágenes. Funciona igual que |
|
|
Float |
|
El peso del vector denso durante la recuperación de imágenes cuando el modelo de vectores dispersos está habilitado. Valores válidos: (0.0, 1.0). |
Parámetros de comprensión de consultas
|
Parámetro |
Tipo |
Predeterminado |
Rango válido |
Descripción |
|
|
Boolean |
|
— |
Habilita la expansión de consultas. Cuando está activada, el sistema genera variantes adicionales de la consulta y las usa para recuperar fragmentos de documentos, lo que mejora la exhaustividad a costa de una llamada adicional al LLM y mayor latencia. Deshabilítela para aplicaciones sensibles a la latencia. |
|
|
Integer |
|
(0, +∞) |
El número máximo de consultas expandidas que se generan cuando la expansión de consultas está habilitada. |
Parámetros de intervención manual
|
Parámetro |
Tipo |
Predeterminado |
Descripción |
|
|
Float |
|
El umbral de puntuación vectorial para entradas de intervención manual. Valores válidos: [0, 2.0]. Valores más bajos amplían el rango de coincidencias; valores más altos restringen las coincidencias a entradas de alta confianza. |
Parámetros de búsqueda profunda
Estos parámetros aplican cuando options.chat.enable_deep_search es true.
|
Parámetro |
Tipo |
Descripción |
|
|
Boolean |
Indica si se muestra el proceso de razonamiento del modelo en la respuesta. |
|
|
Integer |
El número máximo de rondas de razonamiento. Valor máximo: 20. |
|
|
String |
El idioma tanto para el proceso de razonamiento como para la respuesta final. |
Otros parámetros
|
Parámetro |
Tipo |
Predeterminado |
Descripción |
|
|
Boolean |
— |
Devuelve los resultados brutos de la recuperación de documentos. Cuando es |
|
|
Integer |
|
El número de rondas de conversación anteriores que el modelo utiliza como contexto. Valor máximo: 20. Aumente este valor para conversaciones multironda más ricas; manténgalo bajo para reducir el uso de tokens y la latencia. |
|
|
Boolean |
|
Incluye marcadores de cita en la respuesta. Cuando es |
|
|
String |
— |
Controla cómo se devuelven los elementos de texto enriquecido en la respuesta. |
|
|
Boolean |
— |
Habilita la recuperación basada en relaciones de grafo. Solo aplica si GraphRAG está habilitado en las configuraciones de datos. |
|
|
Boolean |
— |
Recurre al conocimiento preentrenado del LLM cuando no se encuentran resultados de búsqueda. |