OpenSearch Industry Algorithm Edition incluye analizadores de texto integrados para distintos idiomas, industrias y escenarios de búsqueda. Cada analizador controla cómo se divide el contenido de un campo en tokens durante la indexación y cómo se compara al momento de ejecutar una consulta.
Descripción general de los analizadores
A continuación se presenta un resumen de todos los analizadores disponibles. La indicación "Solo dedicado" significa que el analizador requiere una instancia de aplicación dedicada.
|
Analizador |
Idioma o dominio |
Tipos de campo compatibles |
Solo dedicado |
|
Cualquiera |
SHORT_TEXT |
Sí |
|
|
Cualquiera |
LITERAL, INT, LITERAL_ARRAY, INT_ARRAY |
No |
|
|
Chino |
TEXT, SHORT_TEXT |
No |
|
|
Chino / Comercio electrónico |
TEXT, SHORT_TEXT |
No |
|
|
Chino |
TEXT, SHORT_TEXT |
No |
|
|
Chino |
TEXT, SHORT_TEXT |
Sí |
|
|
Chino / Pinyin |
SHORT_TEXT |
No |
|
|
Pinyin |
SHORT_TEXT |
No |
|
|
Pinyin |
SHORT_TEXT |
No |
|
|
Inglés |
TEXT, SHORT_TEXT |
No |
|
|
Inglés |
TEXT, SHORT_TEXT |
No |
|
|
Inglés |
TEXT, SHORT_TEXT |
Sí |
|
|
Tailandés |
TEXT, SHORT_TEXT |
Sí |
|
|
Tailandés / Comercio electrónico |
TEXT, SHORT_TEXT |
Sí |
|
|
Vietnamita |
TEXT, SHORT_TEXT |
Sí |
|
|
Indonesio |
TEXT, SHORT_TEXT |
Sí |
|
|
Coreano |
TEXT, SHORT_TEXT |
Sí |
|
|
Coreano / Comercio electrónico |
TEXT, SHORT_TEXT |
Sí |
|
|
Japonés |
TEXT, SHORT_TEXT |
Sí |
|
|
Japonés / Comercio electrónico |
TEXT, SHORT_TEXT |
Sí |
|
|
Cualquiera |
TEXT, SHORT_TEXT |
No |
|
|
Numérico |
INT, TIMESTAMP |
No |
|
|
Geográfico |
geo_point |
No |
|
|
Industria de TI |
TEXT, SHORT_TEXT |
No |
|
|
Comercio electrónico |
TEXT |
Sí (E-commerce Enhanced) |
|
|
Videojuegos |
TEXT, SHORT_TEXT |
Sí (Gaming Enhanced) |
|
|
Inglés / Comercio electrónico |
TEXT |
Sí (E-commerce Enhanced) |
|
|
Cualquiera |
TEXT, SHORT_TEXT |
No |
Analizador N-gram
Divide el texto en secuencias de N caracteres consecutivos. Admite tokenización 2-gram y 3-gram. Utilice este analizador en escenarios de búsqueda no semántica donde necesite comparar subcadenas a nivel de carácter.
Disponible solo para aplicaciones dedicadas. El tipo de campo debe ser SHORT_TEXT.
Ejemplo: 2-gram
Entrada: Open Search
Tokens: op, pe, en, n , s, se, ea, ar, rc, ch
Ejemplo: 3-gram
Entrada: Open Search
Tokens: ope, pen, en , n s, se, sea, ear, arc, rch
Analizador Keyword
No divide el valor del campo en tokens, sino que lo trata como uno solo. Este método es adecuado para escenarios de coincidencia exacta, como etiquetas, identificadores, códigos de cadena y valores numéricos que no deben separarse.
Tipos de campo compatibles: LITERAL, INT, LITERAL_ARRAY, INT_ARRAY
Ejemplo
Entrada: chrysanthemum tea
El documento se recupera únicamente cuando la consulta es exactamente chrysanthemum tea.
Para configurar un campo con recuperación por coincidencia exacta en OpenSearch, siga estos pasos:
En el esquema de la aplicación de un cambio sin conexión, establezca el tipo de campo en LITERAL.
En el esquema de índices, cree un índice para el campo. El método de análisis se establece automáticamente en keyword analysis.
Envíe el cambio sin conexión y espere a que finalice el cambio de servicio.
Use
query=field_name:"search_term"para ejecutar una coincidencia exacta. Por ejemplo,query=id:"云搜索"devuelve solo los documentos cuyo campoidcoincide exactamente con云搜索.
Si trabaja con un campo TEXT, encierre la frase entre comillas dobles para ejecutar una consulta de frase. De esta forma, se compara la expresión completa sin dividirla en tokens; por ejemplo, use query=default:"开放搜索". Para coincidir solo con parte de una frase, o buscar por pinyin, prefijo o sufijo, consulte Fuzzy searches.
Analizador general para chino
Analizador semántico de uso general para texto en chino. Divide el contenido en unidades de búsqueda significativas según la semántica del idioma. Es apropiado para la mayoría de las industrias.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Ejemplo
Entrada: juhuacha
El documento se recupera con las consultas juhuacha, juhua, cha o huacha.
Analizador de comercio electrónico para chino
Analizador semántico optimizado para nombres y descripciones de productos de comercio electrónico en chino. Genera tokens más específicos que el analizador general para la terminología común de productos.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Ejemplo
Entrada: Dabao SOD lotion
El documento se recupera con las consultas Dabao, sod, sod lotion, SOD lotion o lotion.
Analizador de caracteres individuales para chino
Divide el texto en chino en caracteres y palabras individuales. Más indicado para búsquedas no semánticas en chino, como nombres de autores, nombres de tiendas o cualquier campo donde recuperar caracteres sueltos sea más importante que agruparlos por significado.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Este analizador trata los números y las palabras en inglés como tokens únicos. Una búsqueda deheno recupera un documento que contengahello world. Si necesita coincidencias parciales en números o texto en inglés, utilice el analizador difuso.
Si configura un resumen de resultados de búsqueda para un campo TEXT, algunos tokens extendidos, como huacha , no se resaltan.
Ejemplo
Entrada: juhuacha
El documento se recupera con las consultas juhuacha, juhua, cha, huacha, hua o jucha.
Analizador de caracteres para chino
Divide el texto en caracteres chinos individuales, números, letras del alfabeto inglés y signos de puntuación. Recomendado para escenarios de búsqueda no semántica que requieren la máxima granularidad.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: kaifang sousuo OpenSearch123.
El documento se recupera al buscar cualquier carácter individual: kai, fang, sou, suo, O, p, e, n, S, e, a, r, c, h o .
Analizador difuso
Admite búsquedas por pinyin, caracteres individuales y letras, incluidas coincidencias por prefijo y sufijo en números, letras y pinyin. El texto en chino no admite coincidencias por prefijo ni por sufijo. La longitud del campo está limitada a 100 bytes.
Tipos de campo compatibles: solo SHORT_TEXT
Para obtener más información, consulte Fuzzy searches.
Ejemplo: chino y pinyin
Entrada: chrysanthemum tea
El documento se recupera con consultas como chrysanthemum tea, chrysanthemum, tea, flower tea, flower, ju, juhua, juhuacha, j, jh o jhc.
Ejemplo: coincidencias por prefijo y sufijo
Entrada: 138****5678
Use
^138para coincidir con números de teléfono que comiencen con138.Use
5678$para coincidir con números de teléfono que terminen en5678.
Ejemplo: combinaciones de letras en inglés
Entrada: OpenSearch
El documento se recupera con cualquier letra individual o combinación de letras de la palabra.
Analizador de pinyin completo
Busca caracteres chinos en campos SHORT_TEXT mediante su escritura pinyin completa o la primera letra de cada sílaba. Diseñado para escenarios de búsqueda por pinyin completo o abreviado, como nombres de películas o de autores.
Para buscar por pinyin completo, introduzca la escritura pinyin completa de los caracteres chinos. No se admiten sílabas parciales.
Tipos de campo compatibles: solo SHORT_TEXT
Ejemplo
Entrada: Da Nei Mi Tan 007
El documento se recupera con d, dn, dnm, dnmt, dnmt007, da, danei, daneimi o daneimitan.
El documento no se recupera con an ni con anei.
Analizador de pinyin abreviado
Recupera caracteres chinos en campos SHORT_TEXT mediante la primera letra de cada sílaba pinyin. Utilice este analizador en escenarios que requieran búsquedas por iniciales de pinyin, como nombres de personas, títulos de películas y contenido corto similar.
Tipos de campo compatibles: SHORT_TEXT
Ejemplo
Entrada: Da Nei Mi Tan 007
El documento se recupera con d, dn, dnm, dnmt, dnmt0, dnmt007, m, mt, mt007 o 007.
Analizador con derivación de palabras para inglés
Analizador semántico para inglés que reduce cada token a su forma raíz y gestiona los plurales. Úselo cuando necesite que búsquedas como analyzing o analyzers coincidan con documentos que contienen analyze.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Este analizador no admite configuraciones de query analysis . Los caracteres chinos consecutivos se tratan como un solo token.
Ejemplo
Entrada: English tokenizer english analyzer
El documento se recupera con English tokenizer, english, analyz, analyzer, analyzers, analyze, analyzed o analyzing.
Analizador sin derivación de palabras para inglés
Divide el texto en inglés según espacios y signos de puntuación, sin aplicar derivación de palabras. Apropiado para escenarios de búsqueda no semántica en inglés, como títulos de libros, nombres de autores o cualquier campo que requiera coincidencia exacta de palabras.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Este analizador no admite configuraciones de query analysis . Los caracteres chinos consecutivos se tratan como un solo token.
Ejemplo
Entrada: English tokenizer english analyzer
El documento se recupera con English tokenizer, english o analyzer.
Analizador detallado para inglés
Divide el texto en inglés de forma semántica, con mayor granularidad que el analizador estándar. Ideal para aplicaciones industriales generales donde las palabras compuestas deben separarse en sus términos individuales.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: dataprocess
Resultado de la tokenización: data process
El documento se recupera con dataprocess, data process, data o process.
Analizador general para tailandés
Analizador de uso general que divide el texto en tailandés en unidades de búsqueda. Adecuado para aplicaciones industriales generales.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: แหล่งดึงดูดนักท่องเที่ยว
Resultado de la tokenización: แหล่ง ดึง ดูด นักท่องเที่ยว
El documento se recupera con นักท่องเที่ยว o แหล่งดึงดูดนักท่องเที่ยว.
Analizador de comercio electrónico para tailandés
Analizador semántico diseñado para escenarios de comercio electrónico en tailandés.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: หน้าจอโทรศัพท์
Resultado de la tokenización: หน้าจอ โทรศัพท์
El documento se recupera con หน้าจอโทรศัพท์, หน้าจอ o โทรศัพท์.
Analizador general para vietnamita
Analizador de uso general para texto en vietnamita en aplicaciones industriales generales.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Analizador general para indonesio
Analizador de uso general para texto en indonesio en aplicaciones industriales generales.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Analizador general para coreano
Analizador de uso general para texto en coreano en aplicaciones industriales generales.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: 인제군의교육
Resultado de la tokenización: 인제군 의 교육
El documento se recupera con 인제군의교육, 의 o 교육.
Analizador de comercio electrónico para coreano
Analizador semántico diseñado para texto en coreano en escenarios de comercio electrónico.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: 스포츠캐주얼신발
Resultado de la tokenización: 스포츠 캐주얼 신발
El documento se recupera con 스포츠, 캐주얼 o 신발.
Analizador general para japonés
Analizador de uso general para texto en japonés en aplicaciones industriales generales.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: メキシコアグーチ
Resultado de la tokenización: メキシコ アグーチ
El documento se recupera con メキシコ o アグーチ.
Analizador de comercio electrónico para japonés
Analizador semántico diseñado para texto en japonés en escenarios de comercio electrónico.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas.
Ejemplo
Entrada: ラウンドネックスーツ
Resultado de la tokenización: ラウンド ネック スーツ
El documento se recupera con ラウンド, ネック o スーツ.
Analizador simple
Le otorga control total sobre la tokenización. Úselo en escenarios especiales donde ningún analizador integrado cumpla con sus requisitos. Al insertar documentos o ejecutar búsquedas, utilice el carácter de tabulación (\t) para separar los tokens. El contenido del campo y las consultas de búsqueda deben dividirse de la misma manera; de lo contrario, no se recuperarán los documentos.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Este analizador no admite configuraciones de query analysis .
Ejemplo
Valor del campo: chrysanthemum\tflower tea\thao
El documento se recupera con chrysanthemum, flower tea, chrysanthemum\tflower tea, flower tea\thao, chrysanthemum\thao o chrysanthemum\tflower tea\thao.
Analizador numérico
Admite búsquedas basadas en intervalos de tiempo o rangos numéricos. Aplique este analizador en campos INT y TIMESTAMP donde se requieran consultas por rango.
Tipos de campo compatibles: INT, TIMESTAMP
Ejemplo
query=default:'OpenSearch' AND index:[number1,number2]En este ejemplo, index es el nombre del campo de índice configurado con el analizador numérico.
Analizador de ubicación geográfica
Admite consultas por rango de ubicación geográfica.
Tipos de campo compatibles: solo geo_point
Ejemplo
query=spatial_index:'circle(116.5806 39.99624, 1000)'Esta consulta localiza puntos dentro de un círculo para encontrar lugares cercanos a unos cuantos kilómetros de distancia.
Analizador de contenido de TI
Analizador específico de la industria diseñado para contenido de TI. Divide los términos relacionados con tecnología de forma distinta al analizador general; por ejemplo, procesa nombres de lenguajes de programación y abreviaturas técnicas con mayor precisión.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Ejemplo
Contenido original: C++ array usage notes
Análisis general: C++ array usage notes
Análisis de contenido de TI: C++ array usage notes
Análisis general de comercio electrónico
Analizador específico de la industria para comercio electrónico, basado en la tecnología de procesamiento de lenguaje natural (NLP) de Alibaba DAMO Academy. Resuelve problemas comunes en las búsquedas de comercio electrónico, como el análisis de atributos de productos y el reconocimiento de marcas.
Tipos de campo compatibles: solo TEXT
Disponible solo para aplicaciones dedicadas que usan la especificación E-commerce Enhanced.
Ejemplo
Entrada: Small Gold Tube Concealer Cream
Salida del análisis de comercio electrónico: Small Gold Tube, Concealer, Cream
Análisis general para la industria de videojuegos
Analizador específico de la industria diseñado para contenido de videojuegos.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponible solo para aplicaciones dedicadas mejoradas para la industria de videojuegos.
Ejemplo
Entrada: Genshin equipment
Resultado de la tokenización: Genshin, equipment
El documento se recupera con Genshin equipment, Genshin o equipment.
Analizador general para comercio electrónico en inglés
Analizador semántico para texto en inglés en escenarios de comercio electrónico.
Tipos de campo compatibles: solo TEXT
Disponible solo para aplicaciones dedicadas de Industry-specific Enhanced Edition for E-commerce.
Analizador de texto personalizado
Combina un analizador específico de la industria —como un analizador general, uno de comercio electrónico o uno de nombres de personas— con entradas de intervención personalizadas. Úselo para ampliar el comportamiento de tokenización integrado con vocabulario propio de su dominio.
Tipos de campo compatibles: solo TEXT, SHORT_TEXT
Para conocer los detalles de configuración, consulte Custom text analyzers.
Pruebe los analizadores
Pruebe los resultados de tokenización de los analizadores específicos de la industria y personalizados en la consola de OpenSearch. Vaya a Search Algorithm Center > Retrieval Configuration > Analyzer Management y haga clic en la pestaña Analysis Test.
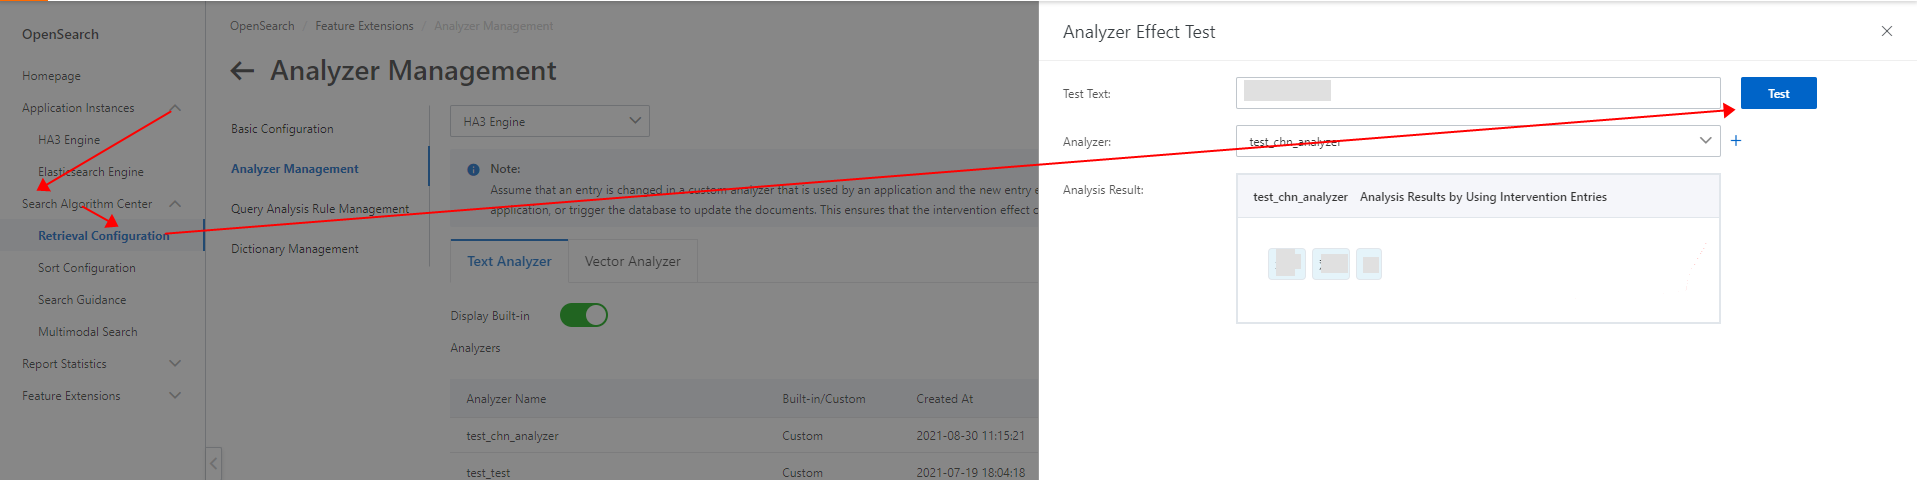
Elija el analizador adecuado
Utilice la siguiente guía para seleccionar el analizador correcto según su escenario.
|
Escenario |
Analizador recomendado |
|
Búsqueda semántica en chino (la mayoría de las industrias) |
Analizador general para chino |
|
Búsqueda no semántica en chino o texto corto con alta recuperación |
Analizador de caracteres individuales para chino |
|
Búsqueda en chino que requiere la máxima granularidad de caracteres |
Analizador de caracteres para chino |
|
Búsqueda por pinyin (completo o abreviado) |
Analizador difuso |
|
Búsqueda solo por iniciales de pinyin |
Analizador de pinyin abreviado |
|
Búsqueda por escritura pinyin completa |
Analizador de pinyin completo |
|
Búsqueda semántica en inglés con derivación de palabras |
Analizador con derivación de palabras para inglés |
|
Búsqueda de palabras exactas en inglés (títulos, nombres) |
Analizador sin derivación de palabras para inglés |
|
Separación de palabras compuestas en inglés |
Analizador detallado para inglés |
|
Búsqueda de productos de comercio electrónico (chino) |
Analizador de comercio electrónico para chino o Análisis general de comercio electrónico |
|
Contenido de la industria de TI |
Analizador de contenido de TI |
|
Consultas por rango numérico o de tiempo |
Analizador numérico |
|
Consultas por proximidad geográfica |
Analizador de ubicación geográfica |
|
Etiquetas, identificadores o cadenas sin tokenizar |
Analizador Keyword |
|
Coincidencia de subcadenas a nivel de carácter |
Analizador N-gram |
|
Lógica de tokenización personalizada |
Analizador simple |
Combinación de analizadores para mejorar la recuperación y la precisión
Para búsquedas en chino, combine el analizador general con el de caracteres individuales. Así recuperará documentos que contengan caracteres sueltos y posicionará más alto las frases exactas. Por ejemplo:
query=title_index:'juhuacha' OR sws_title_index:'juhuacha'Acompañe esta consulta con la expresión de ordenamiento text_relevance(title)×5+field_proximity(sws_title). Esta combinación recupera documentos que contienen los caracteres individuales de juhuacha incluso si están separados, mientras posiciona más arriba aquellos con la frase exacta juhuacha.
Notas de uso
Tipos de campo compatibles para campos de índice
|
Compatible |
No compatible |
|
INT, INT_ARRAY, TEXT, SHORT_TEXT, LITERAL, LITERAL_ARRAY, TIMESTAMP, GEO_POINT |
FLOAT, FLOAT_ARRAY, DOUBLE, DOUBLE_ARRAY |
Restricciones adicionales:
La clave principal predeterminada de la tabla principal en el esquema de la aplicación se configura como un campo de índice llamado
id. Esta configuración no se puede modificar.Si configura un resumen de resultados de búsqueda para un campo TEXT, algunas frases extendidas de unidades de búsqueda (como
huacha, derivada dejuhuacha) no se resaltan en los resultados.El analizador de caracteres individuales para chino trata los números y las palabras en inglés como tokens únicos. Una búsqueda de
heno recupera un documento que contengahello world. Si necesita coincidencias parciales en números o texto en inglés, utilice el analizador difuso.