Al agregar o actualizar registros en su origen de datos, estos cambios deben llegar al motor de OpenSearch para que los usuarios puedan encontrarlos en los resultados de búsqueda. OpenSearch sincroniza datos incrementales en tiempo real mediante un pipeline de tres etapas: del origen de datos a una aplicación sin conexión, de la aplicación sin conexión a una tabla ancha y de la aplicación sin conexión al motor de búsqueda. Los límites de velocidad en cada etapa protegen el motor y mantienen baja la latencia de la tabla principal.
Elegir una ruta de ingesta
Los datos incrementales ingresan al pipeline por una de dos rutas:
|
Ruta |
Funcionamiento |
Cuándo utilizarla |
|
Suscribirse a registros binarios mediante DTS |
Data Transmission Service (DTS) se suscribe a los registros binarios de su origen de datos y transmite los cambios a la aplicación sin conexión de OpenSearch. |
Su origen de datos es una base de datos relacional y desea capturar cambios de forma automática y con baja latencia, sin modificar el código de su aplicación. |
|
Enviar datos mediante la API |
Su aplicación envía datos directamente a la aplicación sin conexión de OpenSearch a través de llamadas a la API. |
Genera datos fuera de una base de datos, procesa datos antes de indexarlos o necesita un control detallado sobre qué registros se indexan. |
Ambas rutas alimentan el mismo pipeline de tres etapas.
Funcionamiento del pipeline
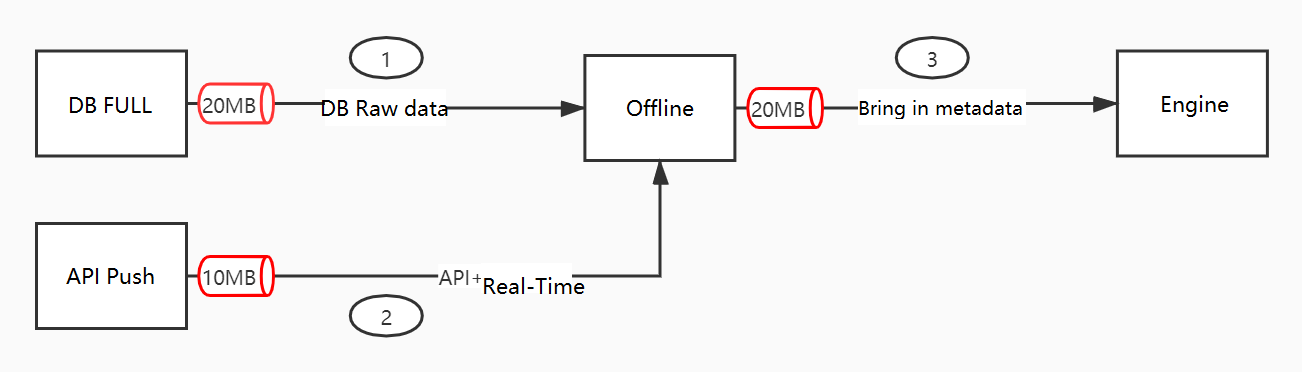
Etapa 1: Del origen de datos a la aplicación sin conexión
DTS se suscribe a los registros binarios de su origen de datos y transmite los cambios a la aplicación sin conexión. Si utiliza la ruta de la API, su aplicación envía los datos directamente a la aplicación sin conexión. En ambos casos, el total combinado de transacciones por segundo (TPS) de su tabla principal y todas las tablas secundarias no debe exceder 1,500 TPS.
Etapa 2: De la aplicación sin conexión a la tabla ancha
La aplicación sin conexión fusiona los cambios entrantes en una tabla ancha existente. Cuando una actualización de tabla secundaria desencadena actualizaciones en la tabla principal y estas alcanzan o superan 1,000 TPS, el sistema limita la velocidad de actualización de la tabla secundaria. Esto mantiene baja la latencia de sincronización de la tabla principal.
Para obtener detalles sobre cómo las uniones de múltiples tablas afectan la latencia, consulte Data synchronization latency caused by multi-table joins.
Etapa 3: De la aplicación sin conexión al motor
La aplicación sin conexión escribe los datos fusionados en el motor de OpenSearch. Dado que se agregan metadatos durante esta etapa, el volumen de datos que llega al motor puede ser de dos a tres veces mayor que el de los datos originales. Para proteger el motor, la velocidad de escritura tiene un límite máximo de 10 MB/s.
Límites
|
Métrica |
Límite |
Motivo del límite |
|
TPS totales del origen de datos a la aplicación sin conexión (tablas principal y secundarias combinadas, sin relación de desencadenador configurada) |
1,500 TPS |
Capacidad de ingesta ascendente de la aplicación sin conexión |
|
Velocidad de escritura de la aplicación sin conexión al motor |
10 MB/s |
La adición de metadatos expande los datos a 2–3 veces su tamaño original; el límite protege al motor contra sobrecargas |
|
Actualizaciones de la tabla principal desencadenadas por actualizaciones de tablas secundarias |
1,000 TPS |
Por encima de este umbral, se reduce la velocidad de actualización de la tabla secundaria para mantener baja la latencia de la tabla principal |
Si prevé que su carga de trabajo se acercará a estos límites, supervise las TPS y el volumen de datos antes de entrar en producción. Póngase en contacto con el soporte técnico de Alibaba Cloud para analizar opciones si sus requisitos superan los valores predeterminados.
Solucionar fallos de sincronización
Si su origen de datos no logra sincronizarse con OpenSearch, siga estos pasos para identificar la causa y restaurar la sincronización:
Verificaciones en la consola
Comprobar la latencia de sincronización: En la consola de CloudMonitor, vaya a las métricas y al Centro de eventos. Busque la métrica Application Real-time Processing Latency (
app_realtime_write_latency) para OpenSearch (opensearch), medida en milisegundos, y utilícela para evaluar el retraso de sincronización de la tabla principal.Comprobar el estado de la tarea de DTS: En la consola de DTS, consulte la lista de tareas de sincronización de datos para confirmar el estado de ejecución y la etapa actual (sincronización de esquema, sincronización completa o sincronización incremental).
Comprobar el uso de almacenamiento: En la página Instance Management de la consola de OpenSearch, revise la columna Storage Used (GB). Cuando el almacenamiento está lleno, la sincronización automática se detiene.
Validación de datos
Comparar datos de clave primaria: Consulte el mismo valor de clave primaria tanto en la base de datos como en OpenSearch y compare los resultados para verificar su consistencia.
Confirmar la consistencia de la configuración: En la página Step 3: Data Source del asistente de configuración de la instancia, confirme que el ID de la instancia RDS, la base de datos y el nombre de la tabla coincidan con la configuración de suscripción de DTS.
Comprobar el conjunto de caracteres: DTS no admite el conjunto de caracteres utf8mb3. Utilice utf8mb4 en su lugar.
Recuperación
Reconstruir el índice: Si el almacenamiento está lleno, reconstruya el índice y ejecute una importación completa de datos. Para obtener más información, consulte la documentación de sincronización en tiempo real de DTS y la documentación de configuración del origen de datos.