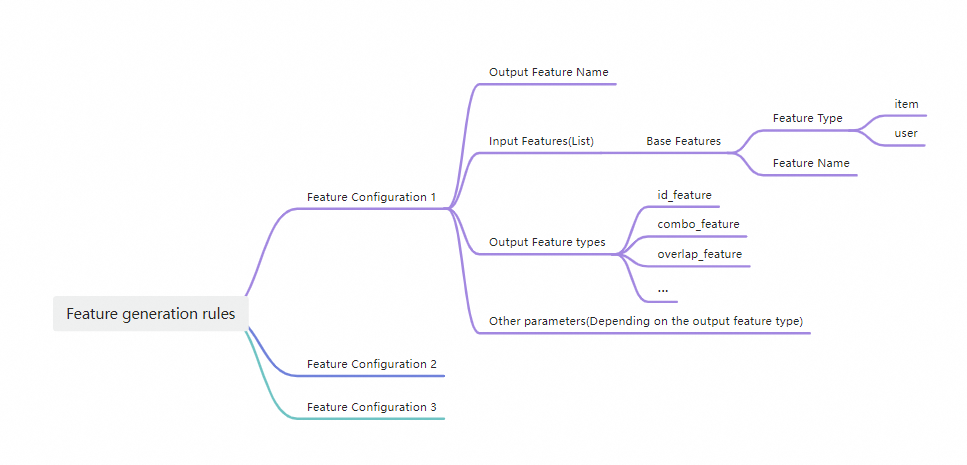
Los modelos de ordenamiento personalizados utilizan funciones como entradas para la clasificación. Cada función extrae una señal de sus datos, como el valor de un campo sin procesar, una puntuación de superposición de términos o un producto cruzado de atributos de usuario y elemento, y la introduce en el modelo. Esta página describe todos los tipos de funciones disponibles y sus parámetros de configuración.
Cada función requiere dos campos comunes:
|
Campo |
Obligatorio |
Descripción |
|
|
Sí |
Nombre de la función. Se utiliza como prefijo de la función de salida. |
|
|
Sí |
Tipo de la función. |
Elija un tipo de función
|
Tipo de función |
Categoría |
Tipos de datos aplicables |
Utilice este tipo cuando |
|
|
Dispersa |
STRING, INTEGER |
Necesite combinar el valor de un campo con un nombre de función para crear una señal de ID discreta. |
|
|
Densa |
Punto flotante, INTEGER |
Deba pasar un valor de campo numérico directamente al modelo. |
|
|
Dispersa |
STRING, INTEGER |
Requiera cruzar varios campos para capturar señales de interacción. |
|
|
— |
Cualquiera (clave), STRING (mapa) |
Busque un valor dentro de un campo de mapa clave-valor. |
|
|
— |
STRING |
Mida la superposición de términos entre una consulta y un campo de título. |
Referencia de tipos de función
id_feature
id_feature es una función dispersa y representa el tipo de función discreta más sencillo. Combina el valor de un campo con un nombre de función especificado por el usuario. Es aplicable a datos STRING e INTEGER.
raw_feature
raw_feature es una función densa que hace referencia directa al valor del campo de la función original. Es aplicable a datos de punto flotante e INTEGER.
Al utilizar el esquema -Embedding, especifique value_dimension para establecer el número de dimensiones. Los valores se concatenan en una sola cadena separada por el carácter ASCII 29 (el separador de grupo no imprimible, \u001D en Unicode).
|
Campo |
Obligatorio |
Tipo |
Ejemplo |
Descripción |
|
|
No |
int |
128 |
Dimensión del campo de salida. Valor predeterminado: 1. |
combo_feature
combo_feature genera una combinación a partir del producto cartesiano de varios campos o expresiones. Es aplicable únicamente a datos STRING e INTEGER; no utilice campos de punto flotante como entrada.
id_feature es un caso especial de combo_feature donde solo participa un campo en el cruce. Un uso típico consiste en cruzar campos de diferentes tablas, como una función de usuario y una función de elemento.
lookup_feature
lookup_feature extrae un valor de un campo de mapa clave-valor. Toma el valor de key, lo convierte a cadena y luego lo busca en los pares clave-valor almacenados en map. Los múltiples valores de los elementos se separan mediante el carácter ASCII 29 (\u001D).
|
Campo |
Obligatorio |
Tipo |
Descripción |
|
|
Sí |
string |
Un campo STRING multivalor donde cada entrada tiene el formato |
|
|
Sí |
string |
Un campo de cualquier tipo. Su valor se convierte a cadena y se compara con las claves en |
|
|
No |
string |
Método de agregación cuando varias entradas del mapa coinciden con la misma clave. Valores válidos: |
overlap_feature
overlap_feature mide la coincidencia a nivel de términos entre un campo de consulta y un campo de título. Ambos campos son campos STRING multivalor cuyos valores están separados por el carácter ASCII 29 (\u001D).
|
Campo |
Obligatorio |
Tipo |
Descripción |
|
|
Sí |
string |
El campo STRING multivalor del lado de la consulta. Ejemplo: |
|
|
Sí |
string |
El campo STRING multivalor del lado del título. Ejemplo: |
|
|
Sí |
string |
El método de cálculo de superposición. Consulte los métodos a continuación. |
Métodos de superposición:
common_word— Términos que aparecen tanto en la consulta como en el título.diff_word— Términos que aparecen en uno pero no en el otro.query_common_ratio— Proporción de términos compartidos respecto al total de términos en la consulta.title_common_ratio— Proporción de términos compartidos respecto al total de términos en el título.is_contain— Indica si el contenido de una consulta está incluido en un título. Devuelve1(verdadero) o0(falso).is_equal— Indica si la consulta y el título son idénticos. Devuelve1(verdadero) o0(falso).
Ejemplo
Consulta: high,high2,fiberglass,abc
Título: high,quality,fiberglass,tube,for,golf,bag
|
Método |
Separador |
Resultado |
|
|
— |
|
|
|
|
|
|
|
— |
|
|
|
— |
|
|
|
— |
|
|
|
— |
|
Generación de funciones
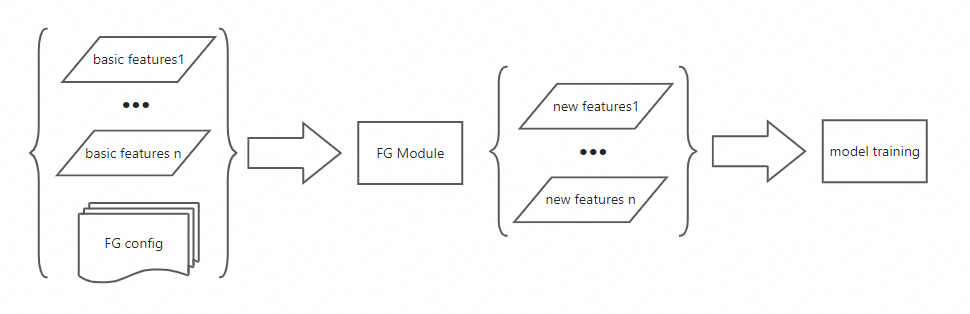
En la práctica, el entrenamiento de modelos requiere funciones más complejas que los valores básicos de los campos. La generación de funciones permite intersectar varias funciones básicas para crear nuevas funciones de entrenamiento. Configure reglas de generación de funciones en su modelo de ordenamiento para producir las funciones de entrenamiento que su modelo necesita.
El siguiente diagrama muestra cómo funciona la generación de funciones.
Reglas de generación de funciones: