Los analizadores de texto de OpenSearch controlan cómo se dividen los valores de los campos en tokens durante la indexación y cómo se analizan sintácticamente las consultas de búsqueda. Elegir el analizador adecuado para cada campo determina directamente qué consultas recuperan un documento.
Descripción general de los analizadores
A continuación se presenta una tabla que resume todos los analizadores disponibles. Úsela para reducir sus opciones antes de consultar las secciones de referencia detalladas.
|
Analizador |
Tipos de campo compatibles |
Ideal para |
Disponibilidad |
|
Analizador de palabras clave |
LITERAL, ARRAY, INT |
Búsquedas de coincidencia exacta; etiquetas, ID, cadenas completas |
— |
|
Analizador general para chino |
TEXT, SHORT_TEXT |
Búsqueda de texto completo en chino de uso general |
— |
|
Analizador de comercio electrónico para chino |
TEXT, SHORT_TEXT |
Búsqueda de catálogos de productos en chino |
— |
|
Analizador de caracteres individuales para chino |
TEXT, SHORT_TEXT |
Búsquedas en chino no semánticas; nombres de autores o tiendas |
— |
|
Analizador difuso |
SHORT_TEXT |
Búsqueda por pinyin; búsqueda por prefijo/sufijo; búsqueda de letras individuales |
— |
|
Analizador con lematización para inglés |
TEXT, SHORT_TEXT |
Búsqueda de texto completo en inglés con lematización |
— |
|
Analizador sin lematización para inglés |
TEXT, SHORT_TEXT |
Búsquedas en inglés no semánticas; títulos de libros, nombres de autores |
— |
|
Analizador de análisis detallado para inglés |
TEXT, SHORT_TEXT |
Búsqueda de texto completo en inglés con división de palabras compuestas |
Aplicaciones exclusivas |
|
Analizador de ortografía pinyin completa |
SHORT_TEXT |
Búsqueda por pinyin completo o abreviado (primeras letras) |
— |
|
Analizador de ortografía pinyin abreviada |
SHORT_TEXT |
Búsqueda por pinyin abreviado (primeras letras) |
— |
|
Analizador simple |
TEXT, SHORT_TEXT |
Tokenización personalizada con términos separados por tabuladores |
— |
|
Analizador de valores numéricos |
INT, TIMESTAMP |
Consultas de intervalos de tiempo y rangos numéricos |
— |
|
Analizador de geolocalización |
GEO_POINT |
Consultas de ubicación geográfica |
— |
|
Analizador de contenido de TI |
TEXT, SHORT_TEXT |
Contenido técnico con terminología específica de TI (por ejemplo, |
— |
|
Analizador general de comercio electrónico para chino |
TEXT |
Búsqueda de productos de comercio electrónico en chino mediante NLP |
Industry-specific Enhanced Edition for E-commerce |
|
Analizador general para tailandés |
TEXT, SHORT_TEXT |
Búsqueda de texto completo en tailandés |
Aplicaciones exclusivas |
|
Analizador de comercio electrónico para tailandés |
TEXT, SHORT_TEXT |
Búsqueda de productos de comercio electrónico en tailandés |
Aplicaciones exclusivas |
|
Analizador general para vietnamita |
TEXT, SHORT_TEXT |
Búsqueda de texto completo en vietnamita |
Aplicaciones exclusivas |
|
Analizador general para videojuegos |
TEXT, SHORT_TEXT |
Búsqueda de contenido de la industria de videojuegos |
Industry-specific Enhanced Edition for Gaming |
|
Analizador general de comercio electrónico para inglés |
TEXT |
Búsqueda de productos de comercio electrónico en inglés |
Industry-specific Enhanced Edition for E-commerce |
|
Analizador de caracteres para chino |
TEXT, SHORT_TEXT |
Búsqueda en chino no semántica a nivel de carácter |
Aplicaciones exclusivas |
|
Analizador personalizado para texto |
TEXT, SHORT_TEXT |
Escenarios donde los analizadores integrados no cumplen con los requisitos |
— |
Referencia de analizadores
Analizador de palabras clave
Devuelve el valor completo del campo como un solo token sin ninguna segmentación. Utilícelo para búsquedas de coincidencia exacta en etiquetas, palabras clave, ID o cualquier cadena que deba tratarse como una unidad completa.
Tipos de campo compatibles: LITERAL, ARRAY, INT
Example: Si el valor de un campo es juhuacha, el documento se recupera únicamente cuando un usuario busca juhuacha.
Analizador general para chino
Segmenta el texto chino en unidades de búsqueda basadas en la semántica del idioma. Este es el punto de partida recomendado para la mayoría de los casos de uso de búsqueda de texto completo en chino.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Example: Si el valor de un campo es juhuacha, el documento se recupera cuando un usuario busca juhuacha, juhua, cha o huacha.
Analizador de comercio electrónico para chino
Es un analizador específico de la industria ajustado para la búsqueda de productos de comercio electrónico en chino. Gestiona nombres de productos, marcas y términos mixtos chino-inglés comunes en los catálogos minoristas.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Example: Si el valor de un campo es Dabao SOD honey, el documento se recupera cuando un usuario busca Dabao, sod, sodhoney, SOD honey o honey.
Analizador de caracteres individuales para chino
Segmenta el texto chino en caracteres individuales y en palabras de múltiples caracteres. Utilícelo cuando no se requiera significado semántico y se prefiera una mayor recuperación; por ejemplo, al buscar nombres de autores o de tiendas.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Example: Si el valor de un campo es juhuacha, el documento se recupera cuando un usuario busca juhuacha, juhua, cha, huacha, ju, hua o jucha.
Este analizador trata los números y las palabras en inglés como tokens individuales. Una búsqueda deheno recupera un documento cuyo campo contengahello. Para admitir la coincidencia parcial de palabras en inglés, utilice el analizador difuso.
Analizador difuso
Admite búsquedas por pinyin, por prefijo/sufijo y de palabras o letras individuales. Los campos no deben exceder los 100 bytes.
Tipos de campo compatibles: SHORT_TEXT
El texto en chino no admite búsquedas por prefijo ni por sufijo. Estas búsquedas solo aplican a letras, números y pinyin. Para más detalles, consulte Fuzzy search .
Ejemplos:
Chinese with pinyin: Si el valor de un campo es
juhuacha, el documento se recupera cuando un usuario buscajuhuacha,juhua,cha,huacha,ju,hua,jucha,ju,juhua,juhuacha,j,jhojhc.Prefix/suffix on numbers: Si el valor de un campo es
138****5678, buscar^138recupera todos los números que comienzan con138; buscar5678$recupera todos los números que terminan con5678.Latin strings: Si el valor de un campo es
OpenSearch, el documento se recupera cuando un usuario busca cualquier letra individual o combinación de letras contenidas en el valor.
Analizador con lematización para inglés
Reduce cada palabra en inglés a su forma raíz, lo que permite realizar búsquedas en variantes flexionadas. Los caracteres chinos consecutivos se tratan como un solo token.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Example: Si el valor de un campo es English tokenizer english analyzer, el documento se recupera cuando un usuario busca English tokenizer, english, analyz, analyzer, analyzers, analyze, analyzed o analyzing.
Analizador sin lematización para inglés
Segmenta el texto en espacios y signos de puntuación sin aplicar lematización. Utilícelo para búsquedas en inglés no semánticas, como títulos de libros o nombres de autores. Los caracteres chinos consecutivos se tratan como un solo token.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Example: Si el valor de un campo es English tokenizer english analyzer, el documento se recupera cuando un usuario busca English tokenizer, english o analyzer.
Analizador de análisis detallado para inglés
Segmenta el texto en inglés por unidad de búsqueda y divide las palabras compuestas en sus componentes. Es un analizador de propósito general para inglés destinado a casos de uso industriales amplios.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponibilidad: Solo aplicaciones exclusivas.
Example: Si el valor de un campo es dataprocess, el resultado del análisis es data process. El documento se recupera cuando un usuario busca dataprocess, data process, data o process.
Analizador de ortografía pinyin completa
Permite a los usuarios encontrar texto en chino ingresando la ortografía pinyin completa o las primeras letras de cada sílaba (pinyin abreviado). El usuario debe escribir una sílaba pinyin completa; las sílabas parciales no generan coincidencias.
Tipos de campo compatibles: SHORT_TEXT
Example: Si el valor de un campo es DaNeiMiTan007, el documento se recupera cuando un usuario busca d, dn, dnm, dnmt, dnmt007, da, danei, daneimi o daneimitan. Buscar an o anei no recupera el documento.
Analizador de ortografía pinyin abreviada
Permite a los usuarios encontrar texto en chino ingresando las primeras letras de cada sílaba pinyin. A diferencia del analizador de ortografía pinyin completa, este admite entradas de sílabas parciales.
Tipos de campo compatibles: SHORT_TEXT
Example: Si el valor de un campo es DaNeiMiTan007, el documento se recupera cuando un usuario busca d, dn, dnm, dnmt, dnmt0, damt007, m, mt, mt007 o 007.
Analizador simple
Le otorga control total sobre la tokenización. Los términos en los valores de los campos y en las consultas de búsqueda deben estar separados por caracteres de tabulación (\t). Los valores de los campos y las consultas deben usar la misma segmentación; de lo contrario, no se podrán recuperar los documentos.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Example: Si el valor de un campo es ju\thuacha\thao, el documento se recupera cuando un usuario busca ju, huacha, ju\thuacha, huacha\thao, ju\thao o ju\thuacha\thao.
Analizador de valores numéricos
Indexa campos numéricos y de marca de tiempo para consultas de rango.
Tipos de campo compatibles: INT, TIMESTAMP
Ejemplo:
query=default:'kaifang sousuo' AND index:[number1,number2]En este ejemplo, index es el nombre del campo de índice configurado con el analizador de valores numéricos.
Analizador de geolocalización
Indexa campos GEO_POINT para consultas de ubicación geográfica, como búsquedas por radio.
Tipos de campo compatibles: GEO_POINT
Ejemplo:
query=spatial_index:'circle(116.5806 39.99624, 1000)'Esta consulta recupera documentos dentro de un círculo cuyo radio puede ser de varios kilómetros.
Analizador de contenido de TI
Es un analizador específico de la industria para contenido técnico de TI. En comparación con el analizador general para chino, gestiona de manera diferente las secuencias de caracteres específicas de TI; por ejemplo, mantiene c++ como un solo token en lugar de dividirlo.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Ejemplo:
|
Entrada |
Resultado del analizador general |
Resultado del analizador de contenido de TI |
|
|
|
|
Analizador general de comercio electrónico para chino
Es un analizador específico de la industria para la búsqueda de productos de comercio electrónico en chino. Utiliza tecnología de procesamiento de lenguaje natural (NLP) de DAMO Academy para producir una segmentación más detallada que el analizador general.
Tipos de campo compatibles: TEXT
Disponibilidad: Solo Industry-specific Enhanced Edition for E-commerce.
Ejemplo:
|
Entrada |
Resultado del analizador general |
Resultado del analizador general de comercio electrónico |
|
|
|
|
Analizador general para tailandés
Segmenta el texto tailandés en unidades de búsqueda para la búsqueda de texto completo en tailandés de propósito general.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponibilidad: Solo aplicaciones exclusivas.
Example: Si el valor de un campo es แหล่งดึงดูดนักท่องเที่ยว, el resultado del análisis es แหล่ง ดึง ดูด นักท่องเที่ยว. El documento se recupera cuando un usuario busca นักท่องเที่ยว o แหล่งดึงดูดนักท่องเที่ยว.
Analizador de comercio electrónico para tailandés
Segmenta el texto tailandés para escenarios de búsqueda de productos de comercio electrónico.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponibilidad: Solo aplicaciones exclusivas.
Example: Si el valor de un campo es หน้าจอโทรศัพท์, el resultado del análisis es น้าจอ โทรศัพท์. El documento se recupera cuando un usuario busca หน้าจอโทรศัพท์, หน้าจอ o โทรศัพท์.
Analizador general para vietnamita
Segmenta el texto vietnamita para la búsqueda de texto completo en vietnamita de propósito general.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponibilidad: Solo aplicaciones exclusivas.
Analizador general para videojuegos
Es un analizador específico de la industria ajustado para contenido de videojuegos.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponibilidad: Solo Industry-specific Enhanced Edition for Gaming.
Example: Si el valor de un campo es Genshin equipment, el resultado del análisis es Genshin equipment. El documento se recupera cuando un usuario busca Genshin equipment, Genshin o equipment.
Analizador general de comercio electrónico para inglés
Es un analizador específico de la industria para la búsqueda de productos de comercio electrónico en inglés.
Tipos de campo compatibles: TEXT
Disponibilidad: Solo Industry-specific Enhanced Edition for E-commerce.
Analizador de caracteres para chino
Segmenta el texto en caracteres chinos individuales, letras inglesas, números y signos de puntuación. Utilícelo para búsquedas no semánticas a nivel de carácter.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Disponibilidad: Solo aplicaciones exclusivas.
Example: Si el valor de un campo es kaifang sousuo OpenSearch123, el documento se recupera cuando un usuario busca cualquier carácter o letra individual: kai, fang, sou, suo, O, p, e, n, S, e, a, r, c, h o ..
Analizador personalizado para texto
Combina un analizador específico de la industria (el analizador general, el de comercio electrónico o el de nombres de personas) con entradas de intervención personalizadas. Para obtener detalles sobre la configuración, consulte Custom analyzers.
Tipos de campo compatibles: TEXT, SHORT_TEXT
Elegir un analizador
Utilice la siguiente guía para seleccionar el analizador adecuado para su caso de uso.
Búsqueda de texto completo en chino
Para la mayoría de los escenarios, comience con el analizador general para chino o el analizador de comercio electrónico para chino.
Cuando no se requiere una clasificación estricta y es más importante una mayor recuperación (como en textos cortos o contenido no semántico), utilice el analizador de caracteres individuales para chino.
Combinación de analizadores para mejorar la clasificación
Indexe el mismo campo con un analizador semántico y otro a nivel de carácter para recuperar más documentos y, al mismo tiempo, posicionar más alto los resultados semánticamente relevantes. Por ejemplo:
query=title_index:'juhuacha' OR sws_title_index:'juhuacha'Expresión de clasificación fina:
text_relevance(title)*5+field_proximity(sws_title)Esta configuración permite a los usuarios recuperar todos los documentos que contienen xxjuxxhuaxxchaxx. Además, los documentos que contienen juhuacha se clasifican en primer lugar.
Búsqueda por pinyin
Utilice el analizador difuso para búsquedas basadas en pinyin.
Búsqueda de texto completo en inglés
Utilice el analizador con lematización para inglés para coincidir con formas flexionadas de palabras.
Probar un analizador
Para comprobar cómo segmenta un analizador una entrada específica, utilice la herramienta Word Analysis Test en la consola de OpenSearch.
Inicie sesión en la consola de OpenSearch.
En el panel de navegación izquierdo, seleccione Search Algorithm Center > Retrieval Configuration.
En la página Basic Configuration, haga clic en Analyzer Management en el panel izquierdo.
En la página Analyzer Management, busque el analizador deseado y haga clic en Word Analysis Test en la columna Actions.
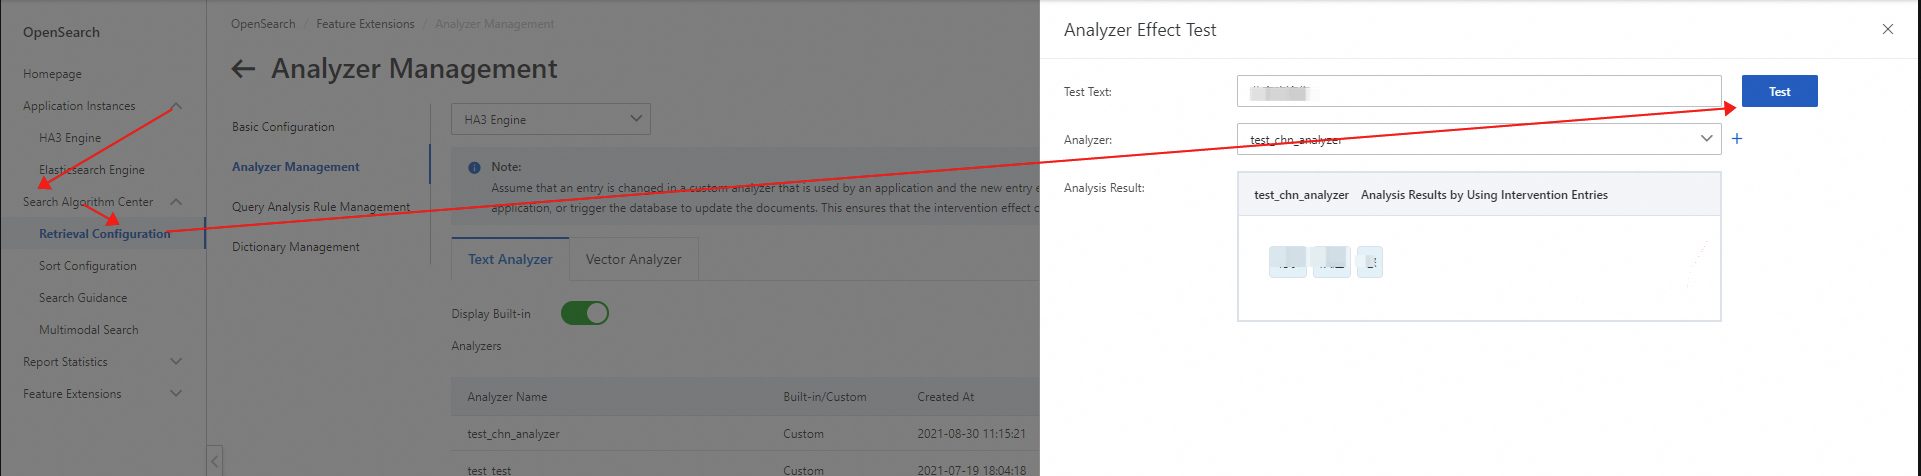
Notas de uso
Tipos de campos de índice: Los siguientes tipos de campo admiten configuración de índice: INT, INT_ARRAY, TEXT, SHORT_TEXT, LITERAL, LITERAL_ARRAY, TIMESTAMP y GEO_POINT. Los siguientes tipos no la admiten: FLOAT, FLOAT_ARRAY, DOUBLE y DOUBLE_ARRAY.
Search result highlighting: En los campos TEXT, es posible que los términos pertenecientes a unidades de búsqueda extendidas (como
huachaderivado dejuhuacha) no se envuelvan en etiquetas HTML de resaltado dentro de los resúmenes de los resultados de búsqueda.Analizador de caracteres individuales y palabras en inglés: Este analizador trata los números y las palabras en inglés como tokens individuales. Una búsqueda de
heno recupera un documento cuyo campo contengahello. Para admitir la coincidencia parcial de palabras en inglés, utilice el analizador difuso.Campo de índice de clave primaria: La clave primaria de la tabla principal se establece automáticamente como un campo de índice llamado
id. Este campo no se puede modificar.