Preguntas frecuentes sobre el inicio y apagado graceful en MSE Microservices Governance.
Funciones avanzadas
Esta sección no aplica si conecta su aplicación a Microservices Governance por primera vez.
La versión anterior de la consola ofrecía funciones avanzadas para el inicio y apagado graceful. Dado que estas funciones implican conceptos complejos de microservices, se ocultaron en la nueva interfaz para simplificarla. Las funciones avanzadas anteriores incluían dos subfunciones:
-
Registro de servicio antes del estado ready
Esta función sigue disponible y está habilitada de forma predeterminada. Si se deshabilitó previamente, se habilita automáticamente al activar el inicio graceful en la página Graceful Online/Offline de la consola. Si ya tiene esta función habilitada, no se recomienda deshabilitarla. Cuando está habilitada de forma predeterminada, esta función no tiene impacto negativo y ayuda a evitar que el tráfico caiga a cero durante los despliegues. Para obtener más información, consulte What does 55199/readiness do, and why is there a risk of traffic dropping to zero without it?.
-
Prefetching de servicio antes del estado ready
Esta función ya no está disponible para nuevas configuraciones. Su propósito original era garantizar que el prefetching de servicio lograra el resultado esperado y evitar picos repentinos en la curva de QPS. Funcionaba retrasando la sonda de readiness de Kubernetes para extender el tiempo total de despliegue, lo que otorgaba a los nuevos nodos tiempo suficiente para realizar el prefetching mientras los nodos antiguos seguían gestionando el tráfico. Esto aseguraba un aumento gradual de QPS. Si los nodos antiguos pasan a offline mientras los nuevos aún realizan el prefetching, los nuevos nodos deben gestionar todo el tráfico entrante, lo cual anula el propósito del prefetching de servicio con bajo tráfico. Las aplicaciones que habilitaron esta función previamente no se ven afectadas, pero no es posible habilitarla para nuevas aplicaciones. Si habilitó esta función anteriormente, no se recomienda deshabilitarla, ya que no tiene impacto negativo. Para obtener mejores resultados con el prefetching de servicio de bajo tráfico en la nueva versión, consulte Best practices for low-traffic service prefetching.
Principios del prefetching de servicio de bajo tráfico
Cuando un consumidor llama a un servicio, selecciona un proveedor. Si el proveedor tiene habilitado el prefetching de servicio de bajo tráfico, Microservices Governance mejora este proceso de selección mediante el cálculo de un peso de 0% a 100% para cada proveedor. Cuanto mayor sea el peso, mayor será la probabilidad de selección. Cuando se inicia un proveedor con prefetching de servicio de bajo tráfico, los consumidores le asignan un peso bajo, lo que otorga al nuevo nodo una menor probabilidad de ser seleccionado. Con el tiempo, el peso aumenta hasta alcanzar el 100%, momento en el que finaliza el prefetching y el nodo recibe tráfico con normalidad. El proveedor incluye su hora de inicio en los metadatos de registro del servicio, que los consumidores utilizan para calcular el peso. Tanto el proveedor como el consumidor deben tener habilitado Microservices Governance para que este proceso funcione.
El prefetching de servicio de bajo tráfico comienza después de que la aplicación recibe su primera solicitud. El proceso finaliza tras la duración de prefetching configurada, que es de 120 segundos de forma predeterminada. Si la aplicación no recibe tráfico externo, el proceso de prefetching no se inicia.
El prefetching de servicio de bajo tráfico requiere tráfico externo entrante, lo que significa que el servicio ya debe estar registrado. Si observa que el prefetching comienza antes del registro del servicio (es decir, el evento de inicio de prefetching aparece en la consola antes del evento de registro del servicio), consulte Why do prefetching events appear before service registration events? para resolver el problema.
Curvas de QPS de prefetching inesperadas
Antes de leer esta sección, se recomienda comprender how low-traffic service prefetching works.
En circunstancias normales, la curva de QPS de una aplicación durante el prefetching de servicio de bajo tráfico se muestra de la siguiente manera:
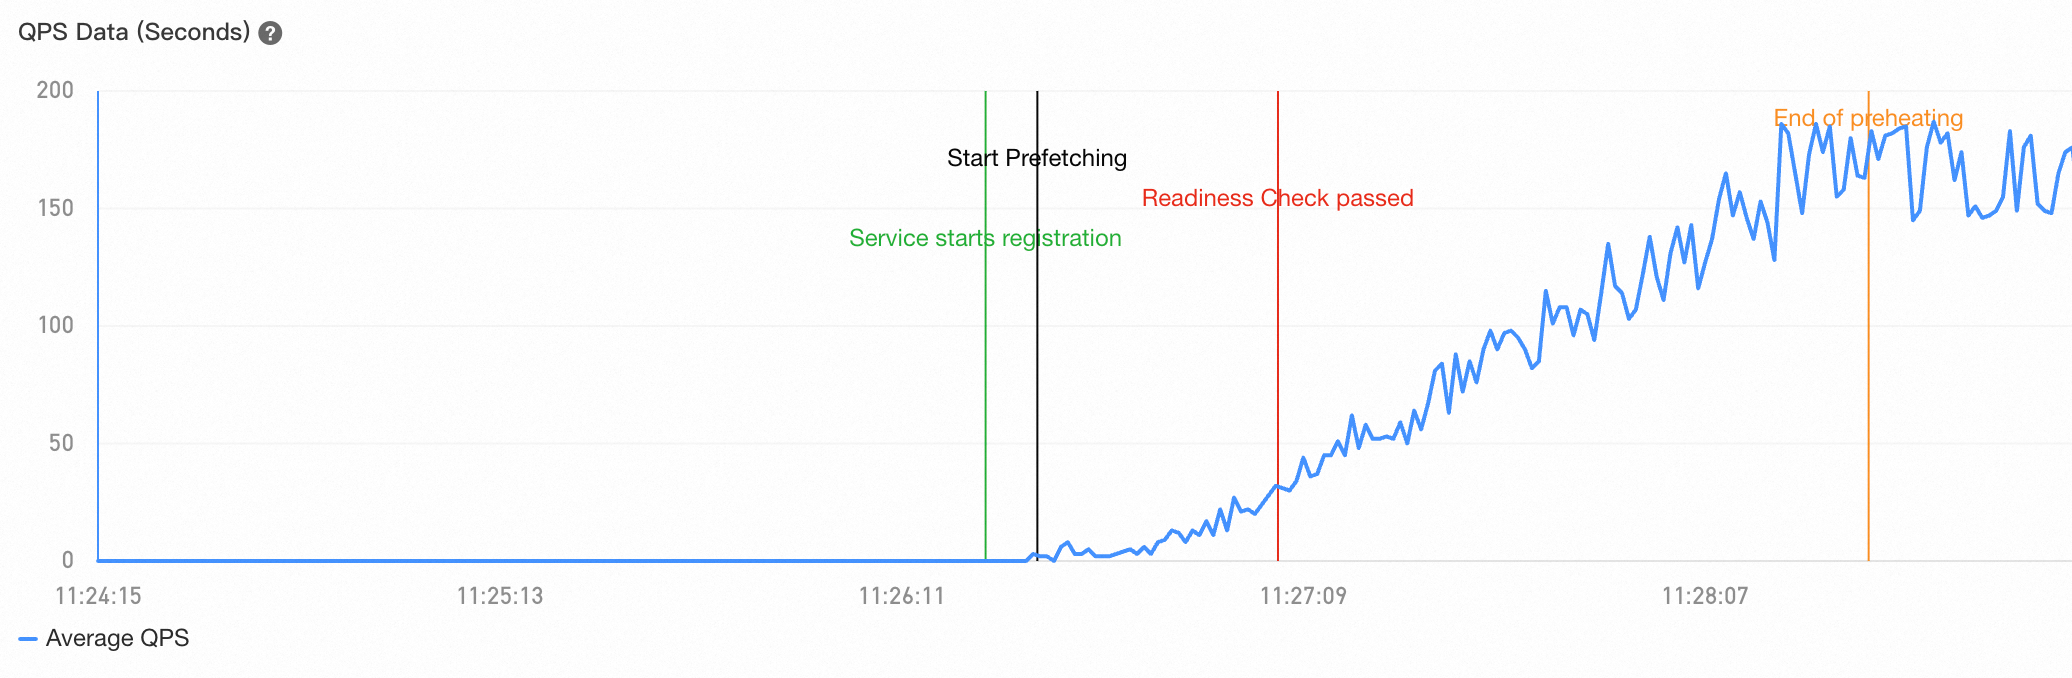
Sin embargo, en algunos casos de uso no admitidos o con configuraciones incorrectas, es posible que la curva de QPS no muestre un aumento gradual. A continuación se describen dos patrones inesperados comunes:
-
Pico repentino en la curva de QPS
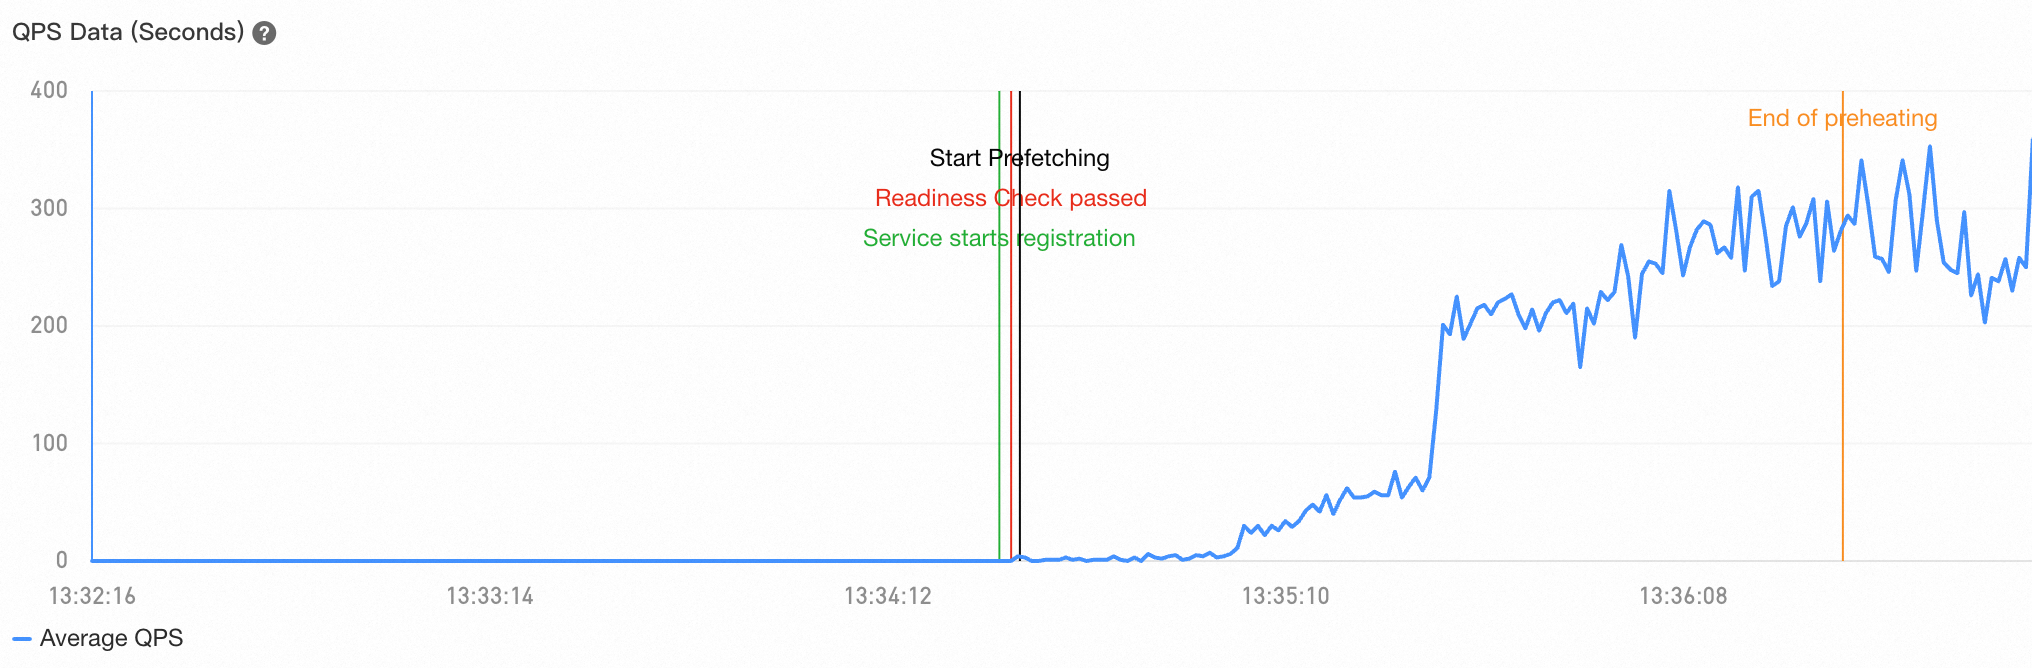
Esto suele ocurrir durante un despliegue de servicio. Si los nodos antiguos pasan a offline antes de que los nuevos completen el prefetching, los consumidores ya no pueden aplicar el enrutamiento de baja probabilidad a los nuevos nodos. Como resultado, la curva de QPS muestra inicialmente un aumento gradual, pero presenta un pico después de que todos los nodos antiguos pasan a offline. Para resolver este problema, consulte Best practices for low-traffic service prefetching.
-
Falta de aumento gradual de QPS
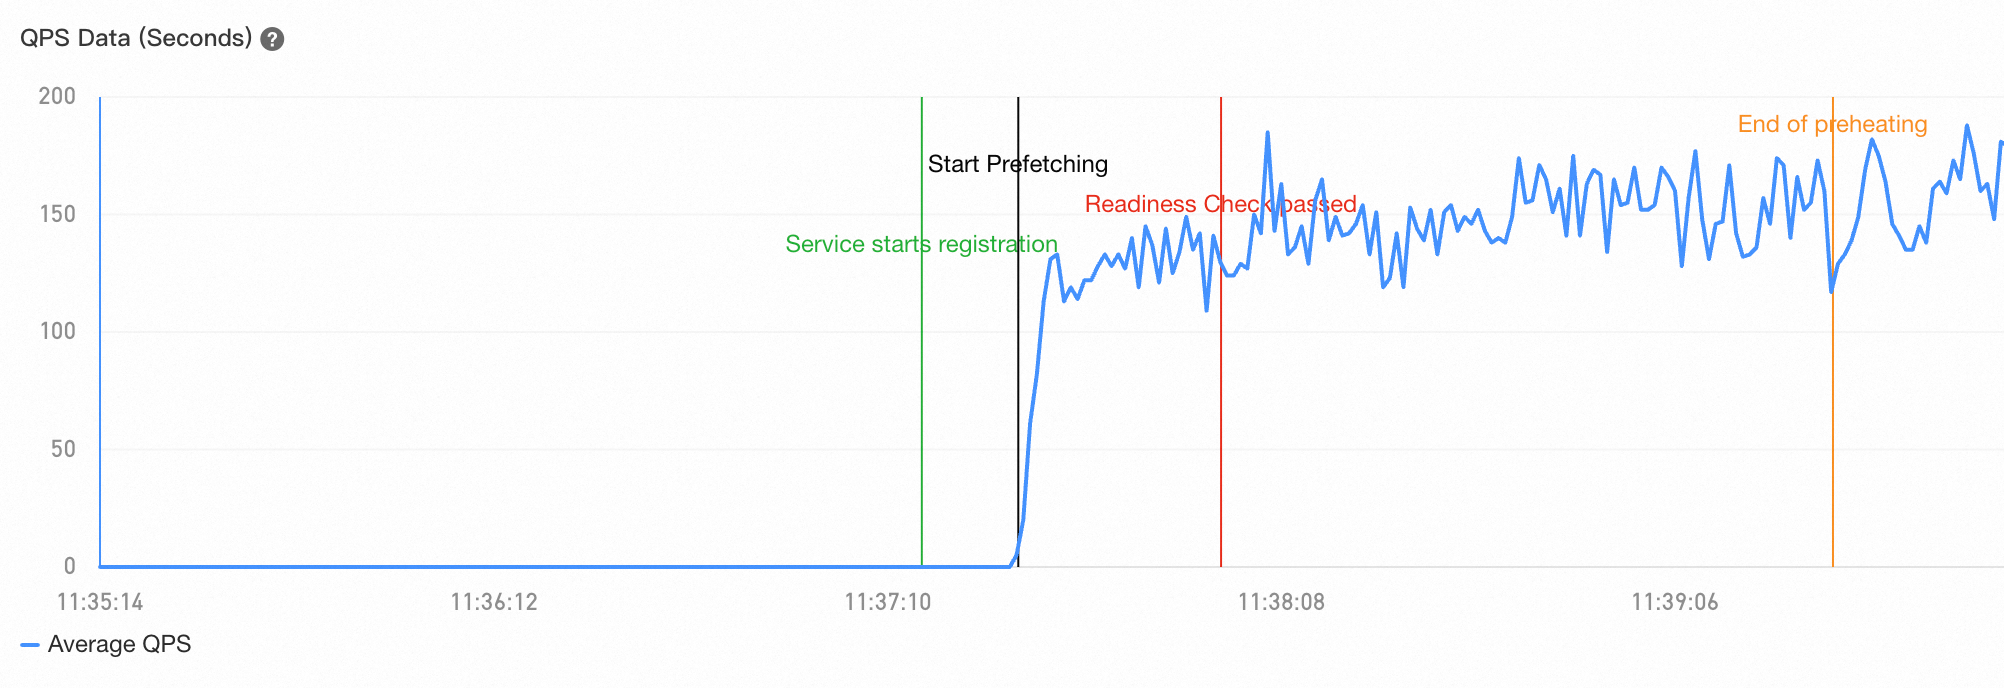
Este problema indica que la aplicación consumidora no está conectada a Microservices Governance. Conecte el consumidor para resolverlo. El prefetching de servicio de bajo tráfico no es compatible con tráfico proveniente de fuentes externas, como gateways de Java, porque no son consumidores conectados.
Mejores prácticas para el prefetching de servicio de bajo tráfico
Durante un despliegue rolling, el prefetching de servicio a menudo queda incompleto. Siga estas prácticas para garantizar que el prefetching logre los resultados esperados:
Configurar minReadySeconds (Recomendado): Configure el parámetro
.spec.minReadySecondsen su workload para controlar el intervalo entre el momento en que un pod pasa al estado ready y cuando se considera disponible. Establezca este parámetro en un valor mayor que la duración del prefetching de servicio de bajo tráfico del pod. Esto garantiza que Kubernetes espere a que el pod complete el prefetching antes de continuar con el despliegue rolling. Si utiliza ACK, configure este parámetro buscando su aplicación en la plataforma de contenedores y navegando a More > Upgrade Policy > Rolling Upgrade > Minimum Ready Time (minReadySeconds). Configurar minReadySeconds asegura que un nuevo pod permanezca en estado ready durante la duración especificada antes de que Kubernetes continúe con el despliegue rolling.Usar despliegue por lotes (Recomendado): Utilice herramientas como OpenKruise para implementar el despliegue por lotes en su workload. Configure el intervalo entre cada lote para que sea mayor que la duración del prefetching de servicio de bajo tráfico, con el fin de asegurar que los nuevos nodos de un lote completen el prefetching antes de desplegar el siguiente.
Aumentar el retraso inicial de la sonda de readiness (No recomendado): Alternativamente, aumente el retraso inicial de la sonda (initialDelaySeconds) para la sonda de readiness del workload a un valor mayor que la suma de la duración del prefetching de servicio de bajo tráfico, el retraso de registro y el tiempo de inicio de la aplicación. Debe determinar el tiempo de inicio de la aplicación observando la salida de registros, y este valor puede cambiar a medida que evoluciona su negocio. Además, retrasar la sonda de readiness puede impedir que los nodos recién iniciados se agreguen rápidamente al endpoint de servicio de Kubernetes. Por lo tanto, no se recomienda este método.
Si la curva de QPS de prefetching sigue sin cumplir las expectativas después de seguir estas prácticas, compruebe si todo el tráfico proviene de aplicaciones consumidoras conectadas a Microservices Governance. El tráfico de consumidores no conectados o balanceadores de carga externos provocará que la curva de QPS se desvíe del patrón esperado.
El endpoint 55199/readiness
El endpoint 55199/readiness es un puerto de sonda de readiness HTTP integrado proporcionado por MSE Microservices Governance. Cuando la sonda de readiness de Kubernetes de una aplicación se configura para usar 55199/readiness, la sonda devuelve 500 si el nuevo nodo no ha completado el registro del servicio, y 200 si lo ha hecho.
Bajo la estrategia de despliegue predeterminada de Kubernetes, los nodos antiguos no finalizan hasta que los nuevos nodos están en estado ready. Con la sonda de readiness configurada para usar 55199/readiness, un nuevo nodo solo pasa al estado ready después de completar el registro del servicio. Esto garantiza que los nodos antiguos finalicen solo después de que los nuevos se hayan registrado, asegurando que siempre haya nodos disponibles en el registro de servicios. Sin 55199/readiness, los nodos antiguos podrían finalizar antes de que los nuevos se registren durante un despliegue, dejando el registro sin nodos disponibles y provocando que todas las llamadas de los consumidores fallen con una caída de tráfico a cero. Por lo tanto, se recomienda encarecidamente habilitar el inicio graceful y configurar la sonda de readiness 55199/readiness para su aplicación.
Si su aplicación utiliza una versión de sonda anterior a la 4.1.10, debe configurar la ruta de la sonda de readiness como /health en lugar de /readiness. Para comprobar la versión de la sonda, vaya a la consola de MSE, navegue a Administration Center > Application Governance, haga clic en la aplicación objetivo y luego haga clic en Node Details. La versión de la sonda se muestra a la derecha.
Eventos de prefetching antes del registro de servicio
En la versión actual, el proceso de prefetching comienza y se reporta un evento de inicio de prefetching cuando el servicio recibe su primera solicitud externa. Sin embargo, es posible que la primera solicitud no sea una llamada de microservice y, por lo tanto, no active el prefetching en la lógica de negocio. Por ejemplo, si un workload tiene configurada una sonda de liveness de Kubernetes, el proceso de prefetching comienza tan pronto como Kubernetes realiza una comprobación de liveness, incluso si aún no se ha producido el registro del servicio.
Para evitar esto, configure el siguiente parámetro en las variables de entorno del workload de la aplicación proveedora para que la lógica de prefetching ignore estas solicitudes:
# Exclude requests to paths /xxx and /yyy/zz from triggering the prefetching process
profile_micro_service_record_warmup_ignored_path="/xxx,/yyy/zz"Este parámetro también se puede configurar como un parámetro de inicio de JVM.
El valor del parámetro no admite expresiones regulares.
Notificación proactiva
La notificación proactiva es una función avanzada del módulo de apagado graceful. Permite que un proveedor de Spring Cloud envíe una solicitud de red a sus consumidores durante el apagado para informarles que pasará a offline. Después de recibir la notificación, los consumidores dejan de llamar a ese nodo. Normalmente, cuando tanto el proveedor como el consumidor utilizan el framework Spring Cloud, el consumidor almacena en caché una lista de nodos proveedores localmente. En algunos escenarios, incluso después de recibir una notificación del registro de servicios, es posible que el consumidor no actualice su caché local a tiempo, lo que provoca llamadas a nodos offline. La notificación proactiva resuelve este problema.
La notificación proactiva está deshabilitada de forma predeterminada. Con Microservices Governance habilitado, la solución de apagado graceful predeterminada hace que el proveedor en proceso de apagado agregue un header especial a sus respuestas. Cuando un consumidor recibe una respuesta con este header, deja de llamar a ese nodo proveedor. Mientras el consumidor envíe tráfico al proveedor en proceso de apagado, detectará el apagado y pondrá automáticamente el nodo en la lista de bloqueados. Sin embargo, si el consumidor no envía ninguna solicitud al proveedor durante el período de apagado (generalmente alrededor de 30 segundos), es posible que no detecte el apagado. Una solicitud podría llegar justo cuando el proveedor se apaga, causando un error. En este escenario, habilite la notificación proactiva. En otras palabras, si el tráfico de su consumidor es muy escaso, se recomienda habilitar la notificación proactiva para el proveedor.
Caída retardada del tráfico después del apagado
Normalmente, el tráfico cae a cero poco después de un evento de apagado graceful. Si no ocurre así, considere las siguientes posibles causas y soluciones:
-
Llamadas que no son de microservices
El inicio y apagado graceful solo gestiona el tráfico de llamadas internas de microservices. El tráfico que no corresponde a microservices queda fuera del alcance de esta función. Se recomienda crear soluciones personalizadas basadas en las funciones de apagado graceful proporcionadas por su infraestructura y frameworks.
-
Notificación proactiva no habilitada
Se recomienda habilitar la notificación proactiva y luego comprobar si la curva de apagado cumple con las expectativas.
-
Versión de framework no admitida
Si descubre que su aplicación utiliza una versión de framework no admitida, considere actualizarla.
Tiempos de despliegue prolongados
Siga estos pasos para comprobar si la aplicación tiene habilitada la función Completar prefetching de servicio antes de pasar la sonda de readiness.
Inicie sesión en la consola de MSE y seleccione una región en la barra de menú superior.
En el panel de navegación izquierdo, elija Microservices Governance > Application Governance.
En la página Applications, haga clic en la aplicación objetivo y vaya a la pestaña Traffic Governance > Graceful Start and Shutdown.
En la pestaña Graceful Online/Offline, presione F12 para abrir las herramientas de desarrollador de su navegador. En la pestaña Network, busque la solicitud
GetLosslessRuleByApp. Si no la ve, actualice la página. En el response body, compruebe si el valor del campo Related bajo Data es true. Si lo es, la aplicación tenía habilitada previamente la función Completar prefetching de servicio antes de pasar la sonda de readiness. Esta función ahora está obsoleta y puede causar tiempos de despliegue más largos. Se recomienda enviar un ticket para deshabilitar esta función.
El endpoint 55199/readiness y fallos de sonda
Kubernetes proporciona tres sondas opcionales: la sonda de startup, la sonda de liveness y la sonda de readiness.
startup probe: Comprueba si una aplicación se ha iniciado correctamente. Solo se ejecuta durante la fase de inicio del pod. Si la sonda falla varias veces y alcanza el umbral de fallos configurado durante el inicio, desencadena un reinicio del pod.
liveness probe: Comprueba si una aplicación está activa actualmente. Comienza a sondear después de que la sonda de startup tenga éxito y continúa durante todo el ciclo de vida del pod. Si la sonda falla varias veces y alcanza el umbral de fallos configurado, desencadena un reinicio del pod.
readiness probe: Comprueba si una aplicación está lista para aceptar tráfico. Comienza a sondear después de que la sonda de startup tenga éxito y continúa durante todo el ciclo de vida del pod. Si la sonda falla varias veces y alcanza el umbral de fallos configurado, Kubernetes establece el estado del pod como not ready, pero no reinicia el pod. Durante un despliegue, la sonda de readiness también puede controlar el ritmo del despliegue. Según la estrategia de despliegue predeterminada, si un nuevo pod no pasa al estado ready, Kubernetes pausa el proceso de despliegue hasta que lo haga.
Después de conectar su servicio a MSE Microservices Governance, puede utilizar el endpoint integrado 55199/readiness para la configuración de su sonda de readiness. Con esta configuración, la sonda de readiness de Kubernetes solo pasa después de que la aplicación completa el registro del servicio. Esto garantiza que, durante un despliegue, los nuevos pods se registren en el registro de microservices antes de que los pods antiguos finalicen y se eliminen del registro. Esto asegura que quienes realizan las llamadas siempre tengan nodos disponibles, evitando excepciones de "servicio no disponible". Para obtener más información sobre por qué necesita configurar la sonda de readiness de MSE, consulte Service registration status check.
Si su sonda de readiness de MSE falla constantemente, existen tres razones probables:
El inicio graceful no está habilitado para el servicio actual. Si el inicio graceful está deshabilitado, la API 55199/readiness de MSE no se expone y la sonda de readiness no pasará.
La aplicación no está conectada a Microservices Governance. Compruebe si existen registros de sonda en el directorio de sondas de gobernanza de microservices. En un entorno de Kubernetes, el directorio de sondas predeterminado es
/home/admin/.opt/AliyunJavaAgento/home/admin/.opt/ArmsAgent. Si el directorio de registros no existe, la aplicación no pudo conectarse a Microservices Governance. Envíe un ticket para contactarnos.La aplicación se reinicia continuamente porque la sonda de startup o de liveness ha alcanzado su umbral de fallos. Dado que la aplicación no logra iniciarse, la sonda de readiness de MSE no pasa. Revise los eventos de Kubernetes del pod para detectar fallos en la sonda de startup o de liveness.