La utilización de IOPS es una métrica crítica para las instancias de MongoDB. Cuando alcanza o se acerca al 100 %, las respuestas de la aplicación se vuelven lentas y los servicios pueden dejar de estar disponibles. Esta guía explica cómo revisar la utilización de IOPS, las causas comunes de un uso elevado y las estrategias de optimización.
Contexto
Los proveedores de bases de datos en la nube suelen usar tecnologías como cgroups (Control Groups) para aplicar el aislamiento de E/S y los límites de IOPS (operaciones de entrada/salida por segundo) por instancia, con el fin de evitar la contención de E/S en hosts compartidos. Por lo tanto, cada tipo de instancia tiene una capacidad máxima específica de IOPS.
Notas importantes
Las métricas IOPS Usage y utilización de IOPS no están disponibles para instancias independientes ni para instancias de conjunto de réplicas o clúster fragmentado que ejecutan MongoDB 4.2 con discos en la nube.
Para estas instancias, la página Monitoring Information en la consola de ApsaraDB for MongoDB siempre muestra 0 en las métricas IOPS Usage y IOPS Usage. Este valor no refleja los datos reales de IOPS.
Revisar la utilización de IOPS
Revise la utilización de IOPS mediante gráficas de monitoreo o mediante la ejecución de comandos.
Inicie sesión en la consola de ApsaraDB for MongoDB. En la página Basic Information, dentro de la sección Specification Information, consulte el valor máximo de IOPS de la instancia. Para conocer los límites de IOPS de los distintos tipos de instancia, consulte Instance types.
Inicie sesión en la consola de ApsaraDB for MongoDB. En la página Monitoring Information, revise las métricas IOPS Usage y IOPS Usage para determinar si la instancia se acerca a su límite de IOPS. Para obtener más información sobre las métricas relacionadas con IOPS, consulte Metrics.
Causas comunes de problemas de E/S
El alto nivel de E/S de disco en una instancia de MongoDB generalmente se debe a los siguientes factores:
Memoria insuficiente: El rendimiento de E/S depende en gran medida del tamaño de la caché de WiredTiger. Una caché más grande almacena más datos frecuentes, lo que reduce la E/S de disco y disminuye el riesgo de cuellos de botella. Una caché más pequeña obliga al sistema a volcar páginas modificadas al disco con mayor frecuencia, lo que incrementa la presión de E/S.
Configuración inadecuada: Los problemas de configuración que pueden causar un alto nivel de E/S incluyen el volcado frecuente del journal o de los registros de tiempo de ejecución, un nivel ineficiente de Write Concern o errores de moveChunk en un clúster fragmentado.
Estrategias de optimización para problemas de E/S
Para resolver problemas de E/S en una instancia de ApsaraDB for MongoDB, seleccione un tipo de instancia adecuado, optimice los índices y mejore los patrones de escritura de la aplicación.
-
Seleccione un tipo de instancia adecuado
Predecir la relación ideal entre datos frecuentes y tamaño de caché antes del despliegue suele ser difícil. Como regla general, elija un tipo de instancia que satisfaga sus requisitos empresariales y mantenga la utilización máxima diaria de CPU y de IOPS por debajo del 50 %.
-
Optimice los índices
Los escaneos completos de tablas y las consultas con índices ineficientes consumen una cantidad significativa de E/S. Por ejemplo, exportar una colección completa puede provocar un pico de E/S. Un exceso de índices también aumenta el tamaño de los datos en disco y reduce los datos frecuentes que la caché de WiredTiger puede almacenar. Cada operación de escritura requiere E/S adicional para actualizar los índices, lo que degrada aún más el rendimiento. Cree índices adecuados para sus patrones de consulta y mitigue estos problemas.
-
Optimice la arquitectura y las operaciones de su aplicación
Para evitar que la E/S de disco se convierta en un cuello de botella en la aplicación, considere las siguientes optimizaciones:
-
Controle los subprocesos concurrentes de lectura y escritura
MongoDB es una aplicación multiproceso. Un alto número de escrituras concurrentes o consultas complejas puede causar cuellos de botella de E/S y retrasos persistentes de replicación en los nodos secundarios. Si un volumen alto de escrituras provoca cuellos de botella de E/S, considere actualizar a un clúster fragmentado para escalar el rendimiento de escritura de forma lineal mediante la distribución horizontal de datos.
-
Evite los picos de escritura siempre que sea posible
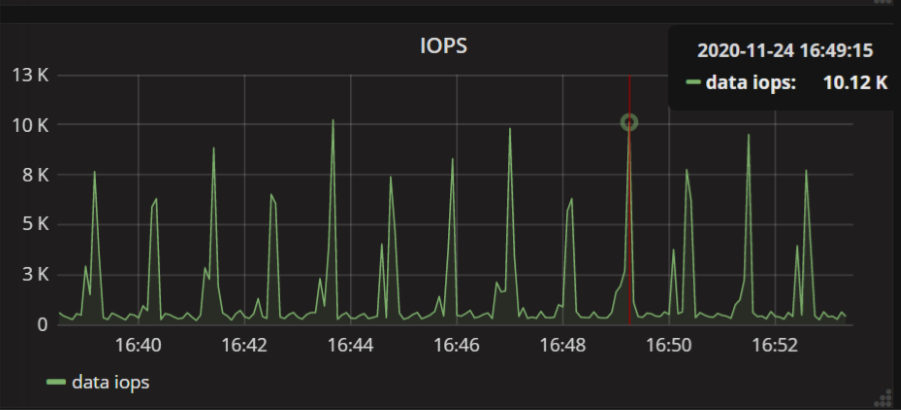
Algunas aplicaciones realizan escrituras periódicas o persistencia masiva de datos, lo que causa picos de IOPS. Si la instancia actual no puede manejar estas cargas máximas, distribuya las operaciones de escritura de manera más uniforme. Por ejemplo, agregue un pequeño retraso aleatorio a cada operación de escritura por lotes.
-
Evite realizar operaciones de mantenimiento durante las horas pico
Ciertas operaciones de mantenimiento pueden afectar significativamente el rendimiento y provocar picos de IOPS. Programe dichas operaciones fuera de las horas pico siempre que sea posible. Las operaciones de alta E/S incluyen modificaciones masivas de datos (escrituras, actualizaciones y eliminaciones), creación de índices, compactación de colecciones y exportaciones masivas de datos.
-