Este tema describe las capacidades de entrada larga y caché de prefijos de las implementaciones PTU (Rendimiento Aprovisionado), incluidas las reglas de consumo de cuotas, cómo utilizar la Calculadora de Cuota de Rendimiento Aprovisionado y descripciones de campos de respuesta de la API.
Visión general
PTU (Unidad de Rendimiento Aprovisionado) es un método de implementación de modelos que reserva recursos de la plataforma para garantizar una capacidad de rendimiento TPM específica; no se aplica limitación de tasa dentro de la cuota garantizada. Es adecuado para entornos de producción de alto rendimiento, alta carga y alto desempeño, proporcionando una capacidad de rendimiento estable, menor latencia y mayor certeza de recursos. En comparación con la facturación basada en tokens, los TPS (tokens generados por segundo) suelen aumentar aproximadamente de 1.5 a 2.0 veces.
Casos de uso:
- Servicio al cliente inteligente para aplicaciones bancarias (tráfico estable, requiere experiencia concurrente garantizada).
- Moderación de contenido en tiempo real para plataformas sociales (requiere procesamiento estable de tareas de canalización predecibles).
- API de traducción en la nube pública (proporciona garantías de servicio base para usuarios de paquetes estándar).
También se utiliza comúnmente en análisis de documentos largos (contratos, resúmenes de informes de investigación) y conversaciones de múltiples turnos (servicio al cliente, asistentes de codificación) donde la entrada supera los 32K tokens. Al crear una PTU, puede seleccionar una estrategia de desbordamiento: desbordamiento automático (predeterminado, cambia automáticamente a pago por uso cuando se excede la cuota) o usar-solo-capacidad-PTU (devuelve 429 cuando se excede). Para más detalles, consulte Reglas de facturación.
PTU también admite coeficientes de capacidad escalonada para entradas largas y descuentos por caché; consulte Entradas largas y almacenamiento en caché de prefijos. Para obtener información sobre cómo funciona el almacenamiento en caché de prefijos, consulte Caché de contexto.
Reglas de facturación
Fee = Usage duration × (Input TPM unit price × Input TPM + Output TPM unit price × Output TPM)
El pospago se calcula por hora: la unidad de duración de uso es horas y el precio unitario se toma de la columna "1 hora continua" en la tabla siguiente; el prepago se calcula por día: la unidad de duración de uso es días y el precio unitario se toma de la columna "1 día continuo" en la tabla siguiente.
- Los pedidos prepago entran en vigor en tiempo real después del pago, con un período de validez de N días que finaliza a las 23:59 del día N. Si el pedido se realiza después de las 22:00, la fecha de vencimiento se extenderá automáticamente por 1 día.
- Después de que expire un pedido prepago, el servicio se detendrá con un retraso de 2 horas, y los recursos se conservarán durante 14 horas después de la detención y luego se liberarán.
- Los pedidos de prepago admiten terminación anticipada; la parte utilizada se liquida con un coeficiente de 1.2x para reembolso. Para más detalles, consulte Reglas de reembolso por reducción de configuración.
- Para la facturación pospago, si la cuenta tiene saldos pendientes, los recursos implementados seguirán retenidos y facturándose durante 24 horas, tiempo durante el cual el servicio aún podrá utilizarse con normalidad. Después de 24 horas, el sistema detiene la facturación, la implementación del modelo entra en estado de saldo pendiente y los recursos subyacentes se eliminarán, pero la tarea de implementación del modelo se conservará. Una vez pagados los saldos pendientes, el sistema reasignará los recursos y restaurará el uso (las tarifas continuarán acumulándose después de la restauración). Si no want seguir incurriendo en tarifas, puede eliminar la tarea de implementación del modelo y la facturación se detendrá tras la eliminación exitosa.
Cuando la entrada del modelo supera el Token máximo de entrada, la llamada correspondiente cambiará automáticamente al modo de pago por uso del modelo actual; cuando se supera el TPM comprado, se gestiona según la estrategia de desbordamiento seleccionada en la creación ("desbordamiento automático" cambia a pago por uso, "usar-solo-capacidad-PTU" devuelve 429). En este momento, el rendimiento de inferencia puede degradarse y estará sujeto al control de tráfico público del modelo instantáneo actual en el espacio de trabajo empresarial, y se cobrarán tarifas según el estándar de invocación del modelo (pago por uso).
- En este caso (solo bajo la estrategia "auto-overflow"), el encabezado de respuesta de la API incluirá:
x-dashscope-ptu-overflow:true. - Para estadísticas de TPM, vaya a: Model Monitoring (Beijing).
Para conocer las reglas específicas de reducción de tarifas y reembolsos en escenarios de reducción de escala (degradación), consulte: Reglas de reembolso para degradaciones de configuración.
NotaLa implementación PTU admite coeficientes de capacidad escalonados para entradas largas y descuentos por caché; consulte Entrada larga y caché de prefijos para obtener más detalles.
Modelos admitidos y precios
Norte de China 2 (Beijing)
Qwen
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | ¥28.8 | ¥8.64 | ¥345.6 | ¥103.68 |
Qwen3.7-Flash-2026-07-15 Contacte a su gerente de cuentas para activar | qwen3.7-flash-2026-07-15 | 128K | ¥0.48 | ¥0.19 | ¥5.76 | ¥2.3 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | ¥28.8 | ¥8.64 | ¥345.6 | ¥103.68 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | ¥4.8 | ¥1.92 | ¥57.6 | ¥23.04 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | ¥4.8 | ¥2.88 | ¥57.6 | ¥34.56 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | ¥1.92 | ¥1.15 | ¥23.04 | ¥13.82 |
Qwen3-Max-2025-09-23 | qwen3-max-2025-09-23 | 128K | ¥7.68 | ¥3.08 | ¥92.16 | ¥36.96 |
Qwen-Flash-2025-07-28 | qwen-flash-2025-07-28 | 128K | ¥0.36 | ¥0.36 | ¥4.32 | ¥4.32 |
Qwen-Plus-2025-12-01 | qwen-plus-2025-12-01 | 128K | ¥1.92 | Sin pensamiento:¥0.48 Pensamiento:¥1.92 | ¥23.04 | Sin pensamiento:¥5.76 Pensamiento:¥23.04 |
DeepSeek
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
DeepSeek-v4-Flash | deepseek-v4-flash | 256K | ¥3.6 | ¥0.72 | ¥43.2 | ¥8.64 |
DeepSeek-v4-Flash-0731 | deepseek-v4-flash-0731 | 64K | ¥7.2 | ¥1.44 | ¥86.4 | ¥17.28 |
DeepSeek-v4-Pro | deepseek-v4-pro | 256K | ¥43.2 | ¥8.64 | ¥518.4 | ¥103.68 |
DeepSeek-v3 | deepseek-v3 | 64K | ¥7.2 | ¥2.88 | ¥86.4 | ¥34.56 |
Qwen-VL
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
Qwen3-VL-Plus-2025-09-23 | qwen3-vl-plus-2025-09-23 | 128K | ¥2.4 | ¥2.4 | ¥28.8 | ¥28.8 |
GLM
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
GLM-5.2 | glm-5.2 | 1M | ¥28.8 | ¥10.08 | ¥345.6 | ¥120.96 |
Singapore
Qwen
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | ¥35.97 | ¥10.79 | ¥431.7 | ¥129.5 |
Qwen3.7-Flash-2026-07-15 Contacte a su gerente de cuentas para activar | qwen3.7-flash-2026-07-15 | 128K | ¥0.54 | ¥0.23 | ¥6.47 | ¥2.81 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | ¥44.97 | ¥13.49 | ¥539.6 | ¥161.87 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | ¥7.19 | ¥2.88 | ¥86.3 | ¥34.53 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | ¥9 | ¥5.4 | ¥107.9 | ¥64.75 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | ¥7.2 | ¥4.32 | ¥86.3 | ¥51.8 |
Qwen3-Max-2025-09-23 | qwen3-max-2025-09-23 | 128K | Consulte la consola | Consulte la consola | Consulte la consola | Consulte la consola |
Qwen-Flash-2025-07-28 | qwen-flash-2025-07-28 | 128K | Consulte la consola | Consulte la consola | Consulte la consola | Consulte la consola |
Qwen-Plus-2025-12-01 | qwen-plus-2025-12-01 | 128K | Consulte la consola | Sin pensamiento:Consulte la consola Pensamiento:Consulte la consola | Consulte la consola | Sin pensamiento:Consulte la consola Pensamiento:Consulte la consola |
DeepSeek
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
DeepSeek-v4-Flash | deepseek-v4-flash | 256K | ¥5.4 | ¥1.08 | ¥64.8 | ¥12.95 |
DeepSeek-v4-Flash-0731 | deepseek-v4-flash-0731 | 64K | ¥10.79 | ¥2.16 | ¥129.5 | ¥25.9 |
DeepSeek-v4-Pro | deepseek-v4-pro | 256K | ¥64.75 | ¥12.95 | ¥777 | ¥155.4 |
Qwen-VL
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
Qwen3-VL-Plus-2025-09-23 | qwen3-vl-plus-2025-09-23 | 128K | ¥3.6 | ¥2.88 | ¥43.2 | ¥34.53 |
GLM
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
GLM-5.2 | glm-5.2 | 1M | ¥37.8 | ¥11.87 | ¥453.3 | ¥142.45 |
Entrada larga y caché de prefijos
Los coeficientes escalonados de entrada larga y los descuentos por caché varían según el modelo. La siguiente tabla enumera los parámetros para los modelos admitidos actualmente:
Modelo | Tipo | Longitud máxima de entrada | Descuento por caché | Coeficiente escalonado de entrada larga |
|---|---|---|---|---|
glm-5.2 | PTU | (0, 1M) | 0.25 | 1 |
qwen3.8-max | PTU | (0, 1M) | 0.125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0, 1M) | 0.2 | Igual para entrada y salida |
deepseek-v4-flash-0731 | PTU | (0, 1M) | 0.1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 1 Millones | 0.2 (porción de aciertos de caché calculada al 20% de capacidad) |
glm-5.1 | PTU | PTU | 200K | 0.2 (porción de aciertos de caché calculada al 20% de capacidad) |
deepseek-v4-pro | PTU | PTU | 256K | 0.08 (porción de aciertos de caché calculada al 8% de capacidad) |
Otros modelos | PTU | PTU | Consulte la consola | Consulte la consola |
Ejemplos de cálculo (glm-5.1)
Scenario 1: Short input (10K tokens, no cache)
  Input consumption: 10K × 1.0 = 10 KTPM

Scenario 2: Long input (50K tokens, no cache)
  Input consumption: 32K × 1.0 + 18K × 1.33 = 55.94 KTPM
  Output consumption (assuming 1K tokens): 1K × 1.17 = 1.17 KTPM

Scenario 3: Long input + cache hit (50K tokens, first 30K hit cache)
  Cached input (first 30K, within [0,32K) tier):
    30K × 1.0 × 0.2 = 6 KTPM
  Non-cached input (last 20K):
    2K × 1.0 + 18K × 1.33 = 25.94 KTPM
  Total input = 31.940 KTPM (43% savings compared to no cache)
Calculadora de cuotas de rendimiento aprovisionado
NotaUtilice la calculadora antes de crear o escalar una implementación para evaluar los requisitos de cuota en escenarios de entradas largas. Esto ayuda a evitar que las solicitudes pasen a la facturación de pago por uso debido a una cuota insuficiente. Consulte la consola para conocer los límites de compra reales.
Requisitos previos: Ha activado Model Studio y tiene permisos de implementación de PTU. Inicie sesión en la consola de Model Studio, vaya a la página Dedicated Deployment > Deploy New Model (o haga clic en Scale Up en la página de producto de una implementación existente), seleccione un modelo PTU (Rendimiento Aprovisionado) implementable y expanda la Provisioned Throughput Quota Calculator.
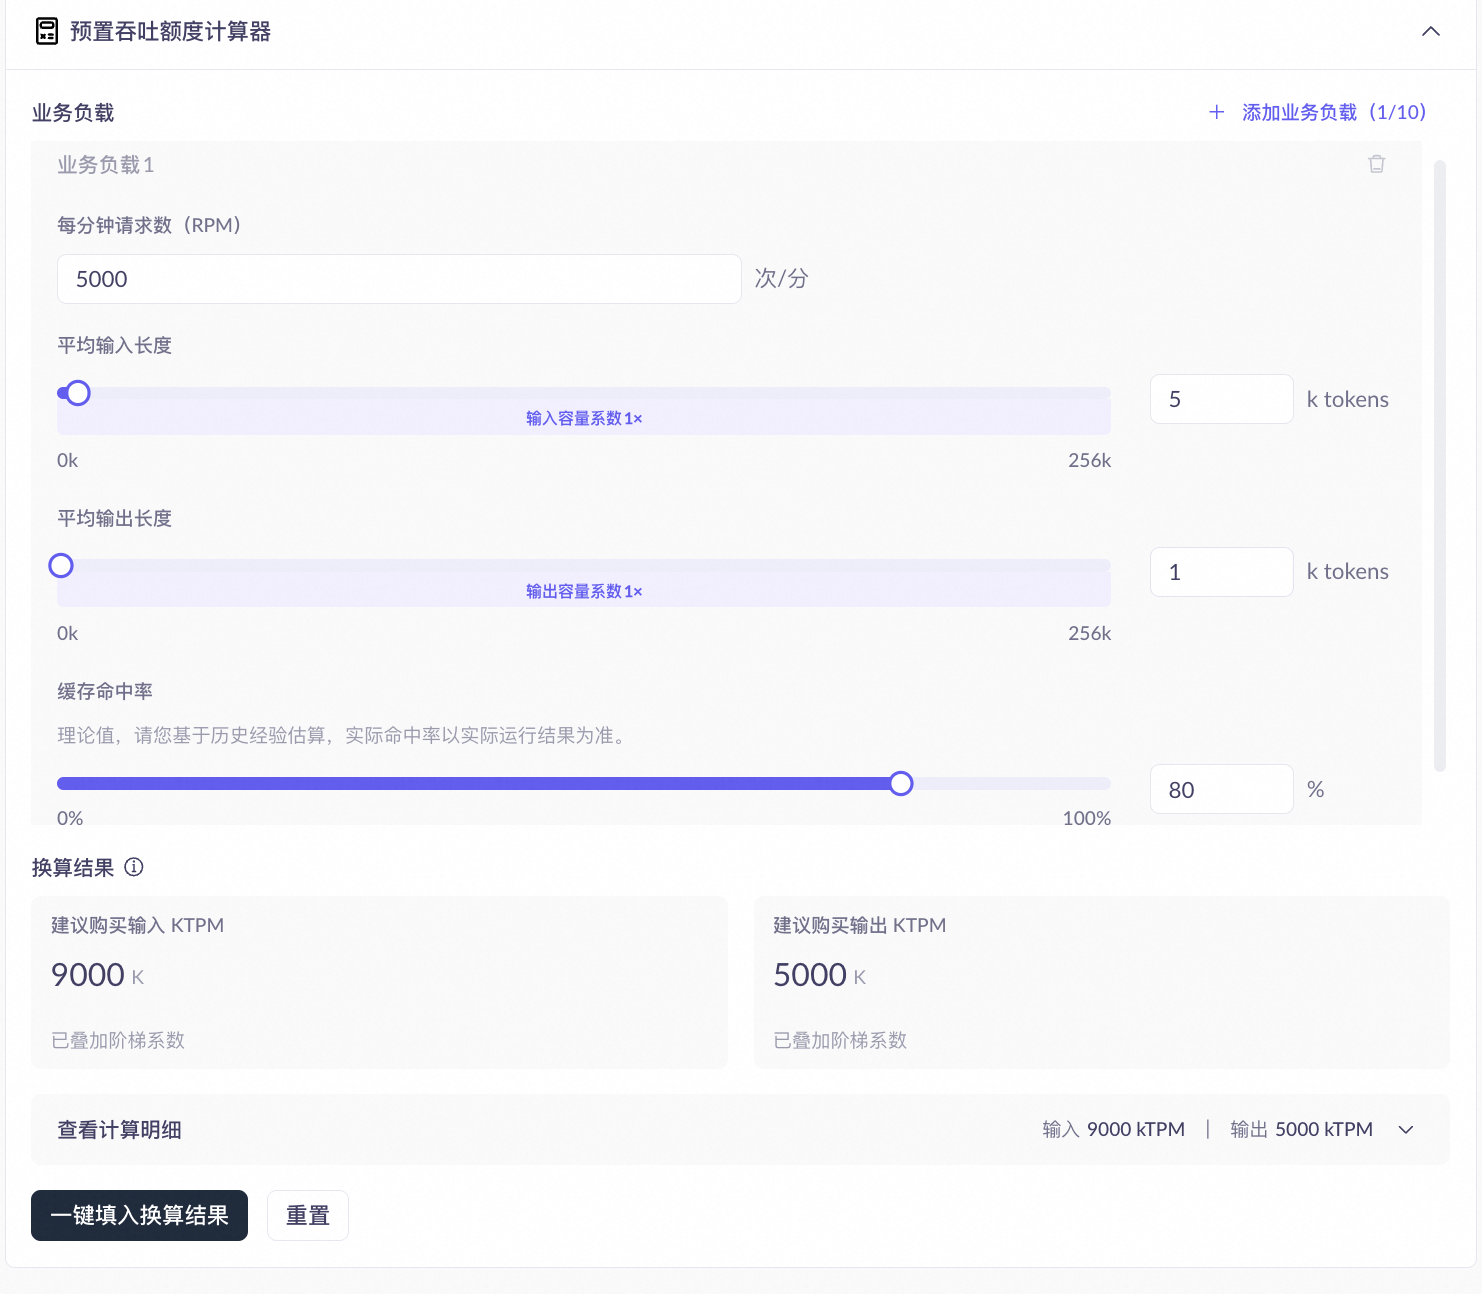
La Calculadora de cuota de rendimiento aprovisionado recomienda automáticamente la cuota KTPM según su carga de trabajo. Complete los siguientes parámetros y la calculadora mostrará los valores recomendados de KTPM de entrada y KTPM de salida.
Parámetro | Descripción | Impacto en los resultados |
|---|---|---|
Requests per minute (RPM) | Número de solicitudes por minuto durante las horas pico de actividad. | Cuanto mayor sea el RPM, más aumentará proporcionalmente el KTPM recomendado de entrada y salida. |
Average input length (tokens) | Número promedio de tokens de entrada por solicitud. | Cuanto más larga sea la entrada, mayores serán el nivel y el coeficiente, y mayor será el KTPM de entrada recomendado. Los límites de nivel varían según el modelo; consulte la consola para obtener los valores reales. |
Average output length (tokens) | Número promedio de tokens de salida por solicitud. | Cuanto más larga sea la salida, mayor será el coeficiente posible y mayor será el KTPM de salida recomendado. |
Cache hit rate (%) | El porcentaje de tokens de prefijo de solicitud que acertaron en la caché. La tasa de aciertos real depende de la repetición del contenido de la solicitud; consulte los resultados reales de ejecución. | Una tasa de aciertos más alta ralentiza el consumo de cuota de entrada, reduciendo el KTPM de entrada recomendado. Afecta solo al KTPM de entrada, no al KTPM de salida. |
Campos de respuesta de API
Las respuestas de API para implementaciones PTU incluyen los siguientes campos relacionados con cuotas que identifican el método de facturación y el consumo de cuota:
Campo | Tipo | Descripción |
|---|---|---|
| String | Un campo de respuesta de nivel superior (consistente en todos los formatos de API). Un valor de |
| Integer | Los tokens de cuota PTU reales consumidos después de la conversión (incluye coeficientes escalonados y descuentos por caché). |
| Integer | El número de tokens que acertaron en la caché de prefijos. Para más detalles, consulte Caché de contexto. |
Las rutas JSON para estos campos difieren según el formato de la API:
Compatible con OpenAI Chat
Campo | Ruta JSON | Descripción |
|---|---|---|
|
| Recuento de tokens en caché del lado de entrada |
|
| Consumo de cuota PTU del lado de entrada |
|
| Consumo de cuota PTU del lado de salida |
Respuestas de OpenAI
Campo | Ruta JSON | Descripción |
|---|---|---|
|
| Recuento de tokens en caché del lado de entrada |
|
| Consumo de cuota PTU del lado de entrada |
|
| Consumo de cuota PTU del lado de salida |
Compatible con Anthropic
Campo | Ruta JSON | Descripción |
|---|---|---|
|
| Consumo de cuota PTU del lado de entrada |
|
| Consumo de cuota PTU del lado de salida |
NotaEl formato compatible con Anthropic actualmente no devuelve el campo cached_tokens. Puede utilizar provisioned_tokens para evaluar indirectamente la eficacia de la caché.
DashScope
Campo | Ruta JSON | Descripción |
|---|---|---|
|
| Recuento de tokens en caché del lado de entrada |
|
| Consumo de cuota PTU del lado de entrada |
|
| Consumo de cuota PTU del lado de salida |
Para definiciones completas de campos y rangos de valores, consulte la Referencia de API.
Monitoreo y verificación
Puede monitorear las implementaciones PTU a través de la función de monitoreo de modelos en la plataforma Model Studio. Las siguientes métricas son relevantes para la entrada larga y el almacenamiento en caché:
- Utilización de PTU: Tres curvas independientes para entrada, salida y salida en modo de pensamiento. En escenarios de entrada larga, los coeficientes escalonados pueden causar que la utilización supere el 100%. Este es un comportamiento esperado.
- Uso de tokens y aciertos de caché: Incluye la serie de datos
cached_tokenspara mostrar la proporción de aciertos de caché en relación con la entrada total. - Recuentos de llamadas dentro y fuera de cuota: Muestra la proporción de solicitudes que recurren a la facturación de pago por uso después de exceder la cuota PTU.
Para obtener más métricas de monitoreo e instrucciones, consulte Monitoreo de modelos.
Escalado
Haga clic en el botón Scaling para ajustar manualmente el rendimiento (número de instancias) mediante autoservicio. Para obtener detalles sobre las reglas de reducción de tarifas y reembolsos, consulte: Reglas de reembolso para degradaciones de configuración.
Además, puede configurar una política de escalado automático (incluidos umbrales de escalado, recuento mínimo/máximo de réplicas, escalado programado, etc.) a través del botón de configuración de escalado en la columna de operaciones.
FAQ
P: ¿Qué sucede cuando se excede la cuota de PTU?
La solicitud pasa automáticamente a la facturación de pago por uso. En la respuesta de la API, el campo service_tier está ausente o devuelve default, y el encabezado de respuesta incluye x-dashscope-ptu-overflow:true. El servicio no se interrumpe.
P: ¿Qué sucede cuando una sola entrada supera el límite del modelo?
Los modelos Qwen-series tienen un límite de entrada de 128K tokens, y los modelos DeepSeek-series tienen un límite de 64K tokens. Las solicitudes que superen el límite también recurrirán automáticamente a la facturación de pago por uso.
P: ¿Cómo verifico que el almacenamiento en caché funciona correctamente?
Verifique el campo cached_tokens en la respuesta de la API. Un valor mayor que 0 indica un acierto en la caché de prefijos. Los tokens con aciertos de caché consumen cuota según el coeficiente de descuento del modelo (para tasas de descuento específicas, consulte Entradas largas y almacenamiento en caché de prefijos). También puede ver las tendencias en el gráfico de uso de tokens en la página de monitoreo de la consola.
P: ¿Qué hago si cached_tokens siempre es 0 y el almacenamiento en caché no funciona?
Causas comunes: El prefijo de entrada es inconsistente entre solicitudes (por ejemplo, cambia el System Message), el intervalo entre dos solicitudes excede el período de validez de la caché, o el recuento de tokens de entrada es demasiado bajo para activar el almacenamiento en caché. Para métodos de solución de problemas y límites de caché, consulte Caché de contexto.
P: ¿Por qué la utilización supera el 100%?
Algunos modelos (como glm-5.1) tienen coeficientes escalonados para entradas largas que provocan que el consumo real de cuota supere el recuento bruto de tokens. Utilización = consumo convertido ÷ cuota comprada. Superar el 100% significa que la tasa de consumo excede la cuota comprada. El exceso pasa automáticamente a la facturación de pago por uso sin afectar la disponibilidad del servicio.