Los operadores nativos PIVOT y UNPIVOT de MaxCompute son el enfoque recomendado para reestructurar datos, ya que ofrecen una sintaxis concisa y un buen rendimiento. Este tema aborda los métodos manuales mediante SQL estándar y funciones integradas específicas de MaxCompute, que brindan mayor flexibilidad para lógicas de agregación complejas no compatibles con los operadores nativos.
Funcionamiento de pivoting y unpivoting
El siguiente diagrama ilustra los conceptos de pivoting y unpivoting. 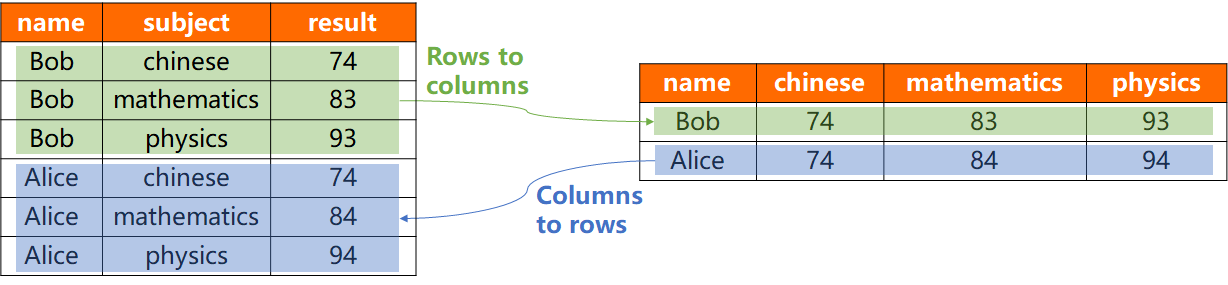
Pivot (filas a columnas): Transforma una tabla en formato largo a un formato ancho. Rota los valores de una sola columna (por ejemplo,
subject) hacia varias columnas nuevas.Unpivot (columnas a filas): Transforma una tabla en formato ancho a un formato largo. Contrae varias columnas (por ejemplo,
chinese,mathematics) en una sola columna de valores y utiliza una nueva columna para etiquetar su origen original.
Datos de ejemplo
Los ejemplos de este tema utilizan las dos tablas siguientes.
-
Cree la tabla de origen
rowtocolumne inserte datos para los ejemplos de pivoting.CREATE TABLE rowtocolumn (name string, subject string, result bigint); INSERT INTO TABLE rowtocolumn VALUES ('Bob' , 'chinese' , 74), ('Bob' , 'mathematics' , 83), ('Bob' , 'physics' , 93), ('Alice' , 'chinese' , 74), ('Alice' , 'mathematics' , 84), ('Alice' , 'physics' , 94);Consulte la tabla
rowtocolumn:SELECT * FROM rowtocolumn; -- Result: +------------+-------------+------------+ | name | subject | result | +------------+-------------+------------+ | Alice | chinese | 74 | | Alice | mathematics | 83 | | Alice | physics | 93 | | Bob | chinese | 74 | | Bob | mathematics | 84 | | Bob | physics | 94 | +------------+-------------+------------+ -
Cree la tabla de origen
columntorowe inserte datos para los ejemplos de unpivoting.CREATE TABLE columntorow (name string, chinese bigint, mathematics bigint, physics bigint); INSERT INTO TABLE columntorow VALUES ('Bob' , 74, 83, 93), ('Alice', 74, 84, 94);Consulte la tabla
columntorow:SELECT * FROM columntorow; -- Result: +------------+------------+-------------+------------+ | name | chinese | mathematics | physics | +------------+------------+-------------+------------+ | Bob | 74 | 83 | 93 | | Alice | 74 | 84 | 94 | +------------+------------+-------------+------------+
Pivoting mediante CASE WHEN o funciones integradas
Los siguientes métodos permiten transponer datos de filas a columnas.
|
Método |
Recomendado para |
Desventaja |
|
CASE WHEN (estándar SQL) |
Portabilidad, legibilidad y cantidad fija de columnas |
Verbosidad al manejar muchas columnas de pivote |
|
Funciones integradas (específicas de MaxCompute) |
Concisión cuando hay muchos valores de pivote |
Dependencia de la plataforma; sobrecarga por manipulación de cadenas |
-
Método 1: CASE WHEN (estándar SQL) Este método emplea agregación condicional. Una expresión
CASE WHENextrae la calificación de cada materia y una función de agregación comoMAX()consolida los resultados en una sola fila por estudiante.Cuándo utilizarlo:
La portabilidad es prioritaria: la lógica SQL estándar funciona en casi cualquier sistema de base de datos.
La legibilidad es importante: la lógica es explícita y fácil de seguir para cualquier desarrollador SQL.
El número de columnas de pivote es fijo y manejable.
Desventajas:
Se vuelve verboso y difícil de mantener cuando se transpone a una gran cantidad de columnas.
SELECT
    name,
    MAX(CASE subject WHEN 'chinese' THEN result END) AS chinese,
    MAX(CASE subject WHEN 'mathematics' THEN result END) AS mathematics,
    MAX(CASE subject WHEN 'physics' THEN result END) AS physics
FROM rowtocolumn
GROUP BY name;
Resultado:
+--------+------------+-------------+------------+ | name | chinese | mathematics | physics | +--------+------------+-------------+------------+ | Bob | 74 | 83 | 93 | | Alice | 74 | 84 | 94 | +--------+------------+-------------+------------+ -
Método 2: Funciones integradas (específicas de MaxCompute) Este método usa primero CONCAT y WM_CONCAT para agregar materias y calificaciones en una sola cadena de clave-valor por estudiante. Posteriormente, la función KEYVALUE analiza esta cadena para extraer la calificación de cada materia en una columna separada.
Cuándo utilizarlo:
La concisión del código es prioritaria, especialmente cuando existen muchos valores de pivote.
Trabaja dentro del ecosistema de MaxCompute y no requiere compatibilidad multiplataforma.
Desventajas:
Dependencia de la plataforma: el código no es portable a otras bases de datos SQL.
Posible cuello de botella en el rendimiento: la manipulación de cadenas en conjuntos de datos muy grandes puede ser menos eficiente que la agregación directa.
SELECT
    name,
    KEYVALUE(key_value_string, 'chinese') AS chinese,
    KEYVALUE(key_value_string, 'mathematics') AS mathematics,
    KEYVALUE(key_value_string, 'physics') AS physics
FROM (
    SELECT
        name,
        WM_CONCAT(';', CONCAT(subject, ':', result)) AS key_value_string
    FROM rowtocolumn
    GROUP BY name
) AS source_with_concat;
Resultado:
+--------+------------+-------------+------------+
| name   | chinese    | mathematics | physics    |
+--------+------------+-------------+------------+
| Bob    | 74         | 83          | 93         |
| Alice  | 74         | 84          | 94         |
+--------+------------+-------------+------------+
Para transformaciones de datos que expanden una sola fila en varias filas, utilice Lateral View junto con funciones como EXPLODE , INLINE o TRANS_ARRAY .
Unpivoting mediante UNION ALL o funciones integradas
Los siguientes métodos permiten transponer datos de columnas a filas.
|
Método |
Recomendado para |
Desventaja |
|
UNION ALL (estándar SQL) |
Corrección, portabilidad y seguridad ante valores NULL |
Múltiples escaneos de tabla; la verbosidad aumenta con el número de columnas |
|
Funciones integradas (específicas de MaxCompute) |
Rendimiento en tablas grandes |
Dependencia de la plataforma; sintaxis compleja; riesgo de pérdida de datos NULL |
-
Método 1: UNION ALL (estándar SQL) Este método combina varias instrucciones
SELECTconUNION ALL, donde cada instrucción recupera una columna de materia diferente. De esta forma, las columnas de materia (chinese,mathematics,physics) se transforman en una sola columnasubject.Cuándo utilizarlo:
La corrección y la portabilidad son primordiales: es el método más confiable y universalmente compatible, además de gestionar valores NULL sin necesidad de lógica adicional.
Se prioriza la claridad sobre el rendimiento: la intención del código resulta inmediatamente clara, aunque no sea la opción más eficiente.
Desventajas:
Penalización de rendimiento en tablas grandes: escanear una tabla grande varias veces puede ser muy ineficiente en un entorno distribuido.
Verbosidad: la longitud del código crece linealmente con el número de columnas por transponer.
SELECT name, subject, result
FROM (
    SELECT name, 'chinese' AS subject, chinese AS result FROM columntorow
    UNION ALL
    SELECT name, 'mathematics' AS subject, mathematics AS result FROM columntorow
    UNION ALL
    SELECT name, 'physics' AS subject, physics AS result FROM columntorow
) unpivoted_data
ORDER BY name;
Resultado:
+--------+-------------+------------+ | name | subject | result | +--------+-------------+------------+ | Bob | chinese | 74 | | Bob | mathematics | 83 | | Bob | physics | 93 | | Alice | chinese | 74 | | Alice | mathematics | 84 | | Alice | physics | 94 | +--------+-------------+------------+ -
Método 2: Funciones integradas (específicas de MaxCompute) Este método utiliza CONCAT para crear una cadena delimitada a partir de las columnas de materia. Luego, TRANS_ARRAY y SPLIT_PART expanden esta cadena en varias filas y analizan la materia y la calificación correspondiente a cada una.
Cuándo utilizarlo:
El rendimiento es crítico en tablas grandes, ya que este método evita múltiples escaneos de tabla.
Tiene familiaridad con la sintaxis y las funciones específicas de MaxCompute.
Desventajas:
Dependencia de la plataforma: el código es altamente específico de MaxCompute y no es portable.
Sintaxis compleja: la combinación de
TRANS_ARRAYy subconsultas anidadas puede resultar más difícil de leer y depurar queUNION ALL.
NotaEste método depende de
CONCAT. Si alguna columna de origen (chinese,mathematicsophysics) contiene un valor NULL, toda la cadena concatenada se convierte en NULL, lo que provoca una pérdida silenciosa de datos para esa fila. Envuelva las columnas conNVL()antes de concatenar (por ejemplo,NVL(chinese, 0)) o utilice el métodoUNION ALLen su lugar. Para obtener más información, consulte NVL.SELECT name, SPLIT_PART(subject,':',1) AS subject, SPLIT_PART(subject,':',2) AS result FROM ( SELECT TRANS_ARRAY(1,';',name,subject) AS (name,subject) FROM ( SELECT name, CONCAT('chinese',':',chinese,';','mathematics',':',mathematics,';','physics',':',physics) AS subject FROM columntorow ) );Resultado:
+--------+-------------+------------+
| name   | subject     | result     |
+--------+-------------+------------+
| Bob    | chinese     | 74         |
| Bob    | mathematics | 83         |
| Bob    | physics     | 93         |
| Alice  | chinese     | 74         |
| Alice  | mathematics | 84         |
| Alice  | physics     | 94         |
+--------+-------------+------------+
Pasos siguientes
MaxCompute también proporciona los operadores nativos PIVOT y UNPIVOT, que ofrecen una sintaxis más concisa y, a menudo, más eficiente para estas transformaciones. Para obtener más información, consulte PIVOT y UNPIVOT.