Descripción general
El tipo de dato Blob (Binary Large Object) en MaxCompute permite almacenar objetos binarios grandes y no estructurados, como imágenes, audio, videos y documentos, directamente en tablas. Al usar el tipo Blob, es posible consolidar archivos sin procesar, metadatos y datos de anotación para información multimodal dentro de una sola tabla de MaxCompute. Esto facilita el uso de SQL para realizar consultas y mantenimiento unificados, así como ejecutar procesamiento por lotes con MaxFrame y funciones definidas por el usuario (UDF) de SQL.
Casos de uso
Gestión de conjuntos de datos de entrenamiento de IA: Almacene archivos de imágenes, audio o video junto con sus etiquetas y anotaciones correspondientes en una sola tabla, y utilice SQL para filtrar muestras de datos específicas.
Flujos de trabajo de procesamiento de datos multimodales: Unifique el almacenamiento de resultados intermedios y finales provenientes de flujos de múltiples pasos, como la extracción de fotogramas de video, la transcripción de audio a texto y el etiquetado de contenido.
Capa de caché para procesamiento multimodal: Funcione como capa de caché para fuentes de datos como object storage, con el fin de mejorar el rendimiento de la computación paralela a gran escala con MaxFrame y SQL. Esto permite superar los límites de QPS asociados con las solicitudes por lotes de archivos pequeños.
Ingesta de datos no estructurados: Importe archivos desde diversos sistemas de almacenamiento externos hacia MaxCompute y enriquézcalos con metadatos para construir una biblioteca de activos no estructurados a nivel empresarial. De este modo, se aprovechan las garantías transaccionales y el control de acceso unificado.
Especificaciones
Función | Descripción |
Límite de tamaño | Hasta 5 GB para cada objeto Blob en una celda. |
Formato de almacenamiento | Formato binario |
Formato de tabla compatible para Blob | Append Delta Table. Las columnas Blob heredan las funciones del formato de tabla, incluidas las transacciones ACID, la clasificación de almacenamiento y las instantáneas. |
Servicios de optimización de Blob |
|
Límites
Debe habilitar los tipos de datos de MaxCompute 2.0:
SET odps.sql.type.system.odps2=true;.El tipo Blob no puede anidarse dentro de tipos complejos como ARRAY, MAP o STRUCT.
Una columna Blob no puede utilizarse como clave principal ni como clave de partición.
Una columna Blob no puede usarse en cláusulas ORDER BY, GROUP BY o JOIN ON.
Almacenamiento multimodal unificado
La siguiente figura compara una arquitectura de almacenamiento distribuido tradicional con la arquitectura de almacenamiento multimodal unificado de MaxCompute.
A la izquierda, el enfoque tradicional almacena los archivos sin procesar en object storage, mientras que sus metadatos y anotaciones se encuentran dispersos en diferentes almacenes de datos y lagos de datos. La consulta y el procesamiento de esta información requieren coordinación entre varios sistemas.
A la derecha, el enfoque de MaxCompute utiliza el tipo de columna Blob para almacenar archivos binarios, como imágenes, audio y videos, junto con sus metadatos estructurados en una sola tabla. Esto permite realizar consultas SQL, procesamiento por lotes con MaxFrame e importación de datos mediante SDK.
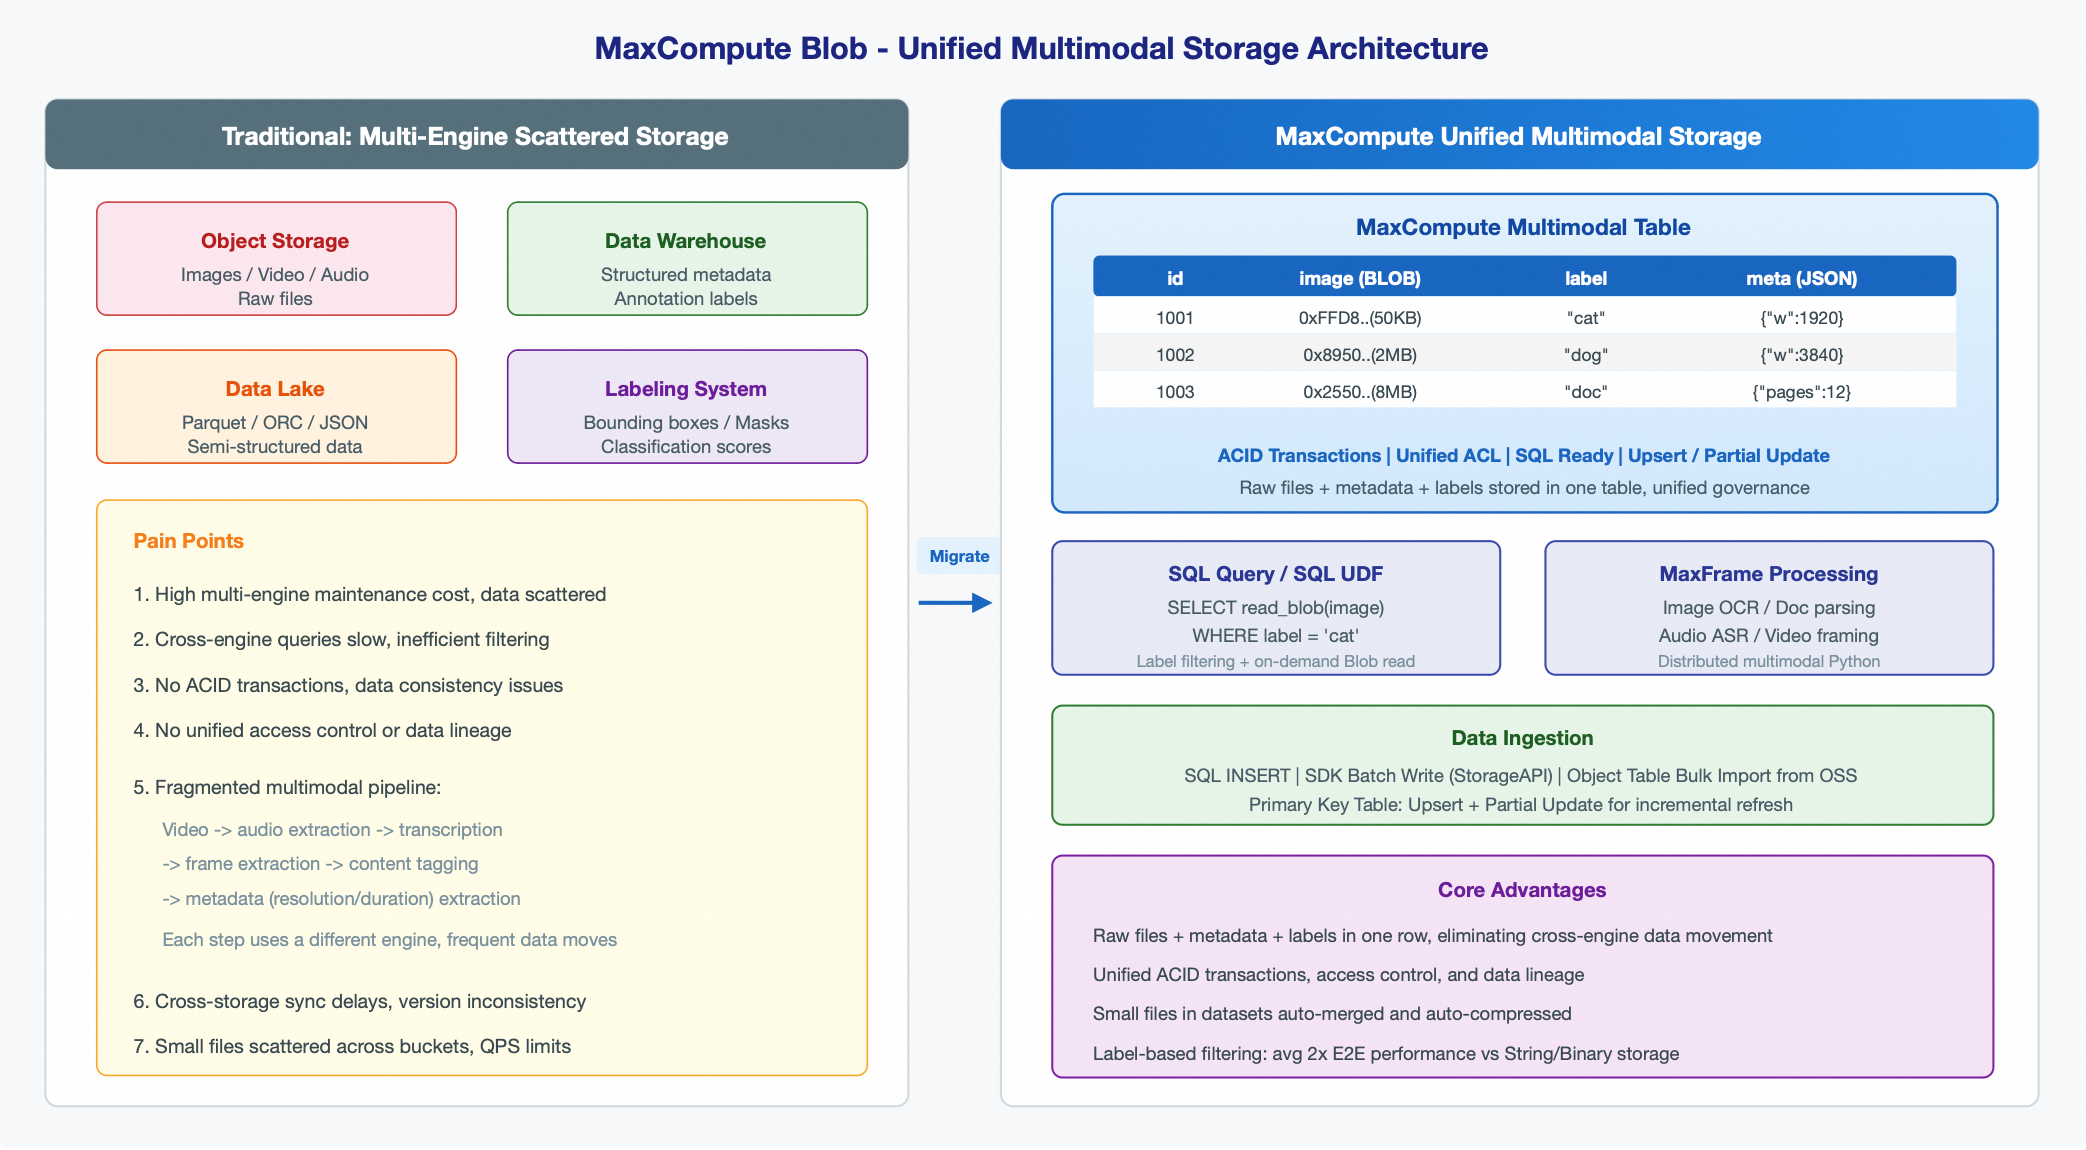
MaxCompute ofrece soporte nativo para el tipo de columna Blob, lo que permite almacenar todos los datos —incluidos archivos sin procesar, metadatos y anotaciones— en una única tabla:
-- Example of a multimodal dataset table
CREATE TABLE multimodal_dataset (
    id          BIGINT NOT NULL,
    image       BLOB,                       -- Raw image binary
    label       STRING,                     -- Classification label
    bbox        STRING,                     -- Annotation bounding box (JSON)
    resolution  STRING,                     -- Resolution metadata
    created_at  DATETIME                    -- Ingestion time
) TBLPROPERTIES("table.format.version"="2");
Enfoques tradicionales frente al enfoque multimodal de MaxCompute
Las arquitecturas tradicionales distribuyen los datos multimodales —como archivos sin procesar, metadatos y anotaciones— en diversos sistemas, tales como object storage, almacenes de datos y lagos de datos. MaxCompute resuelve estos desafíos mediante el uso del tipo de columna Blob para unificar toda la información en una sola tabla:
|
Enfoque tradicional |
Solución de MaxCompute |
|
Altos costos de mantenimiento: Una arquitectura de múltiples motores dispersa los datos, lo que dificulta su gestión unificada. |
Almacenamiento y gestión unificados: Los archivos sin procesar, los metadatos y las anotaciones se almacenan en una sola tabla, lo que elimina la necesidad de mantener varios sistemas. |
|
Alta latencia en consultas entre motores: Filtrar imágenes por etiqueta requiere múltiples pasos, como consultar una base de datos para obtener metadatos antes de recuperar los archivos desde object storage. |
Filtrado directo con SQL: Consulte datos según condiciones como etiquetas o marcas de tiempo sin necesidad de accesos multisalto entre sistemas. |
|
Falta de garantías ACID unificadas: La consistencia de los datos, los permisos de acceso y el linaje de datos no pueden gestionarse de forma centralizada. |
Transacciones ACID completas y control de acceso unificado: Cada operación de escritura es atómica y consistente, y todos los datos son gestionados por el sistema de permisos de MaxCompute. |
|
Flujos de procesamiento fragmentados: Un flujo de trabajo multimodal típico (extracción de audio de video, transcripción, división de fotogramas, etiquetado de contenido y extracción de metadatos) abarca múltiples sistemas, lo que provoca movimientos frecuentes de datos. |
Flujo de procesamiento unificado: Los resultados intermedios y finales de los flujos de múltiples pasos se centralizan en una sola tabla, lo que elimina el movimiento de datos entre sistemas. |
Modelo de almacenamiento y beneficios de rendimiento
Modelo de almacenamiento
MaxCompute Blob utiliza un modelo de almacenamiento de referencia y entidad separadas, que divide las columnas de datos estructurados de las columnas de objetos grandes Blob en diferentes archivos físicos. Como se muestra en la siguiente figura, la arquitectura consta de tres capas:
La capa de acceso proporciona varios métodos de acceso, incluidos SQL, MaxFrame, odpscmd, SDK y Storage API.
La capa de servicio gestiona la compactación, el enrutamiento de referencias Blob, la administración de transacciones ACID, la clasificación de almacenamiento y las copias de seguridad.
-
La capa de almacenamiento divide los datos en:
Data File (archivo de datos estructurados): Almacena datos de columnas que no son Blob (como id, label y metadatos) y un puntero de referencia (Reference) a la columna Blob. Estos archivos utilizan un formato de almacenamiento columnar estándar que admite un predicate pushdown eficiente y la poda de columnas.
Blob File (archivo de objetos grandes): Almacena el contenido binario sin procesar de los objetos Blob, junto con sumas de comprobación de datos e información de índice. Los archivos de almacenamiento se dividen o fusionan dinámicamente según el tamaño de cada objeto Blob.
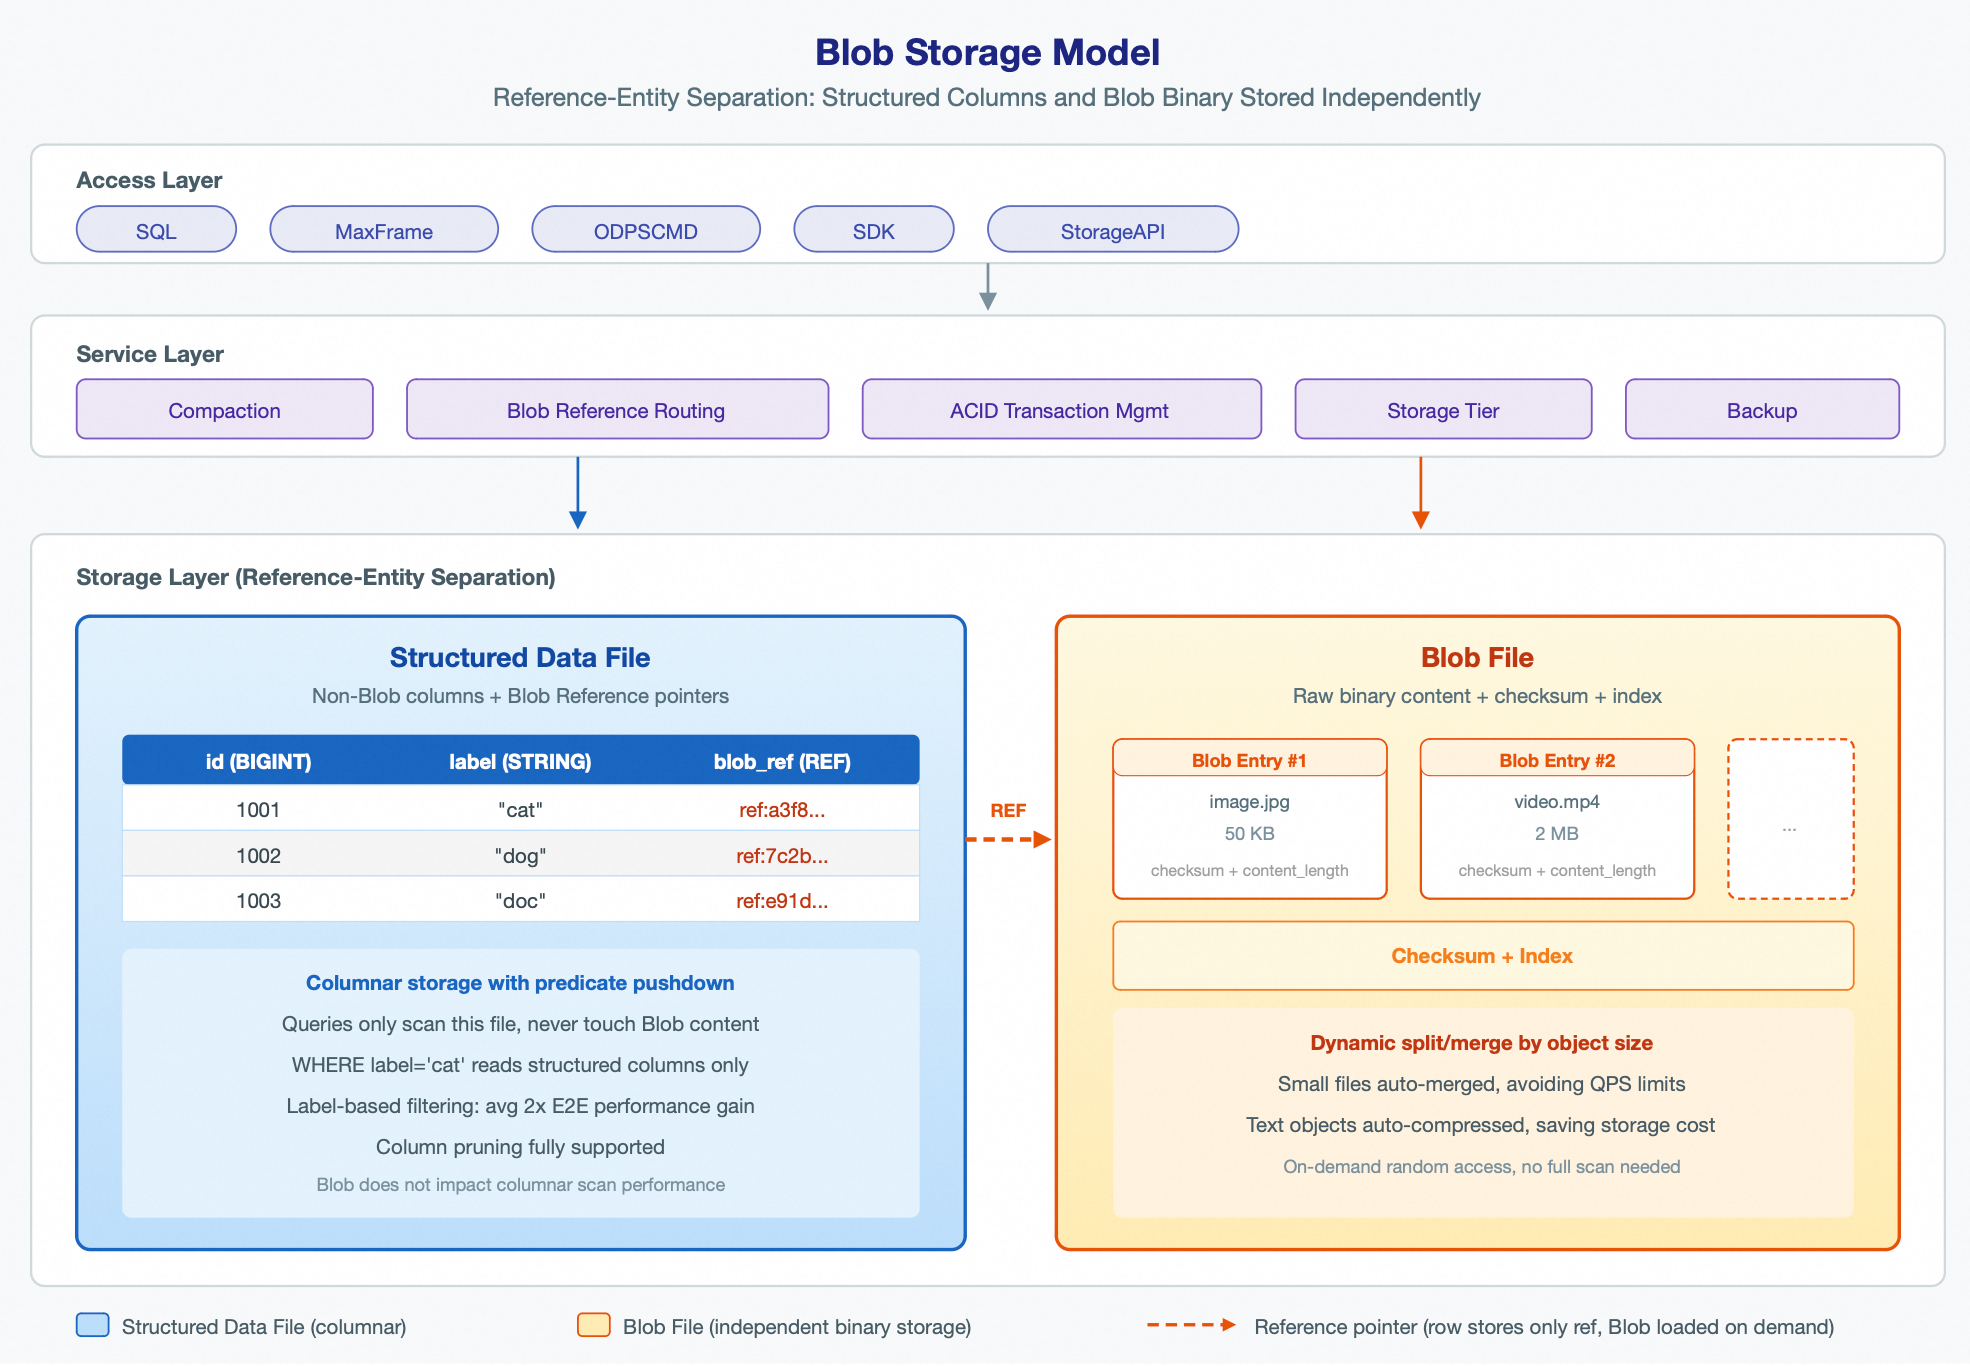
Al escribir datos, el sistema carga el contenido binario en un Blob File y escribe un puntero de referencia en el Data File estructurado. Al leer datos, el sistema primero recupera el puntero de referencia de la columna estructurada y luego carga el contenido binario del Blob File según sea necesario. La carga del Blob y la escritura de la referencia se completan atómicamente en una sola confirmación de sesión, y MaxCompute gestiona las operaciones de lectura y escritura como una única transacción para garantizar la atomicidad.
Este proceso es transparente para usted y no requiere ningún manejo especial.
Beneficios de rendimiento
-
Fusión y compresión de archivos pequeños
El almacenamiento Blob fusionará automáticamente muchos objetos pequeños (como imágenes, fragmentos HTML y registros de sesiones JSON) en archivos Blob más grandes, lo que permite operaciones de lectura y escritura por lotes. Esto resuelve las limitaciones de QPS asociadas con las solicitudes de una gran cantidad de archivos pequeños.
Los objetos basados en texto se comprimen automáticamente durante la escritura y se descomprimen durante la lectura. Por ejemplo, en el caso de fragmentos HTML y texto JSON, esto puede reducir el espacio de almacenamiento en un promedio del 50%, lo que disminuye los costos de almacenamiento.
-
Filtrado eficiente de metadatos sin escanear objetos de archivo grandes
Al filtrar datos basándose en columnas de metadatos o etiquetas (por ejemplo, buscar muestras con una etiqueta específica), almacenar objetos como tipo Blob en lugar de tipos STRING o BINARY puede duplicar el rendimiento de extremo a extremo en promedio.
Por ejemplo, considere un conjunto de datos de 1 millón de imágenes con un tamaño promedio de 1.4 MB. La siguiente tabla compara la sobrecarga de consulta al almacenar la imagen como tipo BINARY frente al tipo Blob:
Método de almacenamiento
Datos escaneados
Imagen almacenada en una columna BINARY
Aprox. 1,400 GB (escaneo completo de tabla)
Imagen almacenada en una columna BLOB
Aprox. 30 GB (solo Data File)
Cuando ejecuta la siguiente consulta de filtrado por etiqueta, la tabla con el tipo BINARY realiza un escaneo completo de 1,400 GB. En cambio, la tabla con el tipo Blob escanea solo 30 GB de datos, lo que representa una reducción de 45 veces.
-- Image stored as BINARY type
SELECT id, image FROM multimodal_dataset_binary Where label = "cat";
-- Image stored as Blob type
SELECT id, read_blob(image) FROM multimodal_dataset_blob Where label = "cat";
Importación y exportación de datos
SDK
Utilice este método para la lectura y escritura por lotes de alto rendimiento de datos a gran escala. Debe usar MaxCompute Java SDK versión 0.57.1-public o posterior.
Para objetos Blob menores a 1 MB, use la interfaz de carga por lotes. El SDK agrupa automáticamente los objetos en lotes de 64 MB para su carga.
<dependency>
    <groupId>com.aliyun.odps</groupId>
    <artifactId>odps-sdk-storage-api</artifactId>
    <version>0.57.1-public</version>
</dependency>
Object table
Utilice este método para importar muchos archivos no estructurados existentes (como imágenes, audio, video y documentos) desde OSS hacia una tabla de MaxCompute con una columna Blob. Puede crear una Object Table para acceder a objetos y metadatos en un bucket de OSS, y luego insertarlos masivamente en una tabla multimodal de MaxCompute. Este proceso no requiere almacenamiento temporal.
Ejemplo:
-- Step 1: Create an Object Table to associate with OSS data
SET odps.namespace.schema=true;
SET odps.sql.type.system.odps2 = true;
CREATE OBJECT TABLE oss_images
LOCATION 'oss://<accessKeyId>:<accessKeySecret>@<endpoint>/<bucket>/<path>/';

-- Refresh metadata
ALTER TABLE oss_images REFRESH METADATA;

-- Step 2: Create a multimodal table that contains a Blob column
CREATE TABLE ods_dataset_images (
  key VARCHAR(2048) COMMENT 'Object key',
  size BIGINT COMMENT 'Object size',
  type VARCHAR(32) COMMENT 'Object type',
  last_modified TIMESTAMP_NTZ COMMENT 'Last modified time',
  storage_class VARCHAR(32) COMMENT 'Storage class',
  etag VARCHAR(64) COMMENT 'ETag information',
  restore_info VARCHAR(256) COMMENT 'Restore information',
  owner_id BIGINT COMMENT 'Owner ID',
  owner_display_name VARCHAR(256) COMMENT 'Owner display name',
  data_file BLOB COMMENT 'Data file'
) COMMENT 'Multimodal table'
tblproperties ('table.format.version'='2') ;

-- Step 3: Bulk import data into the Blob table
INSERT OVERWRITE ods_dataset_images
SELECT key, size, type, last_modified, storage_class, etag, restore_info, owner_id, owner_display_name,
  to_blob(get_data_from_oss('<project_name>.default.oss_images', key)) AS data_file
  FROM oss_images;
Sintaxis SQL
DDL
Puede definir varias columnas Blob en una sentencia CREATE TABLE.
CREATE TABLE video_dataset (
    id        BIGINT,
    video     BLOB,
    thumbnail BLOB,
    title     STRING
) TBLPROPERTIES('table.format.version'='2');
Funciones Blob
to_blob()
La función to_blob() convierte datos de cadena o binarios en un objeto Blob.
|
Función |
Descripción |
|
|
Convierte la cadena completa en un Blob. |
|
|
Convierte el valor binario completo en un Blob. |
|
|
Crea un Blob a partir de una subcadena que comienza en el |
|
|
Crea un Blob a partir de una subcadena binaria que comienza en el |
|
|
Crea un Blob a partir de una subcadena de longitud especificada, comenzando en el |
|
|
Crea un Blob a partir de una subcadena binaria de longitud especificada, comenzando en el |
-- Create a Blob from a string
SELECT to_blob('hello world'); -- Returns: Blob{reference=CAEQAxqqAgEAAAAJA...}

-- Create a Blob from hexadecimal binary data
SELECT to_blob(X'89504E47');   -- PNG file header

-- Substring with an offset
SELECT to_blob('hello world', 6);           -- Result: 'world'
SELECT to_blob('hello world', 0, 5);        -- Result: 'hello'
read_blob()
La función read_blob() devuelve el contenido de un objeto Blob como STRING o BINARY.
|
Función |
Descripción |
|
|
Lee el contenido completo del Blob como STRING. |
|
|
Lee el contenido a partir del |
|
|
Lee una longitud específica de contenido a partir del |
-- Read the content of a Blob
SELECT id, read_blob(image) FROM image_dataset WHERE label = 'cat' LIMIT 10;

-- Read partial content (for example, to check the file header)
SELECT id, read_blob(content, 0, 4) AS file_header FROM media_library;

-- Nested usage
SELECT read_blob(to_blob('hello world'));  -- Returns 'hello world'
length()
-- Gets the length of a Blob in bytes
SELECT id, length(read_blob(image)) AS image_size FROM image_dataset;
Inicio rápido
-- Create a table with a Blob column
CREATE TABLE blob_table (col1 BLOB)
TBLPROPERTIES (
  "table.format.version"="2"
);

-- Write data
INSERT INTO blob_table VALUES (to_blob("hello world"));

-- Read data
SELECT read_blob(col1) FROM blob_table;