Construya una solución de análisis unificado por lotes y en tiempo real mediante los datos de eventos de GitHub. MaxCompute funciona como el almacén de datos por lotes, mientras que Realtime Compute for Apache Flink y Hologres conforman el almacén de datos en tiempo real. Posteriormente, Hologres y MaxCompute proporcionan una capa unificada para analizar los datos tanto en tiempo real como por lotes.
Contexto
A medida que las empresas se digitalizan, la demanda de datos más recientes crece. Además del procesamiento tradicional por lotes para datos a gran escala, muchas organizaciones ahora requieren procesar, almacenar y analizar datos en tiempo real. El análisis unificado por lotes y en tiempo real responde a esta necesidad.
El análisis unificado por lotes y en tiempo real gestiona y procesa ambos tipos de datos en una sola plataforma. Esto permite conectar sin interrupciones el procesamiento en tiempo real con el análisis por lotes. Entre sus principales beneficios destacan:
Mayor eficiencia en el procesamiento de datos: integrar los datos en tiempo real y por lotes en una sola plataforma reduce los costos de transferencia y conversión.
Mayor precisión analítica: combinar datos en tiempo real y por lotes para su análisis mejora la exactitud de los resultados.
Gestión simplificada de datos: un enfoque unificado agiliza la administración y el procesamiento de la información.
Mejor respaldo para la toma de decisiones: aproveche al máximo sus datos para respaldar las decisiones del negocio.
Alibaba Cloud ofrece una solución de almacén de datos unificada y simplificada para escenarios por lotes y en tiempo real. Esta solución utiliza MaxCompute para el procesamiento por lotes y Hologres para el análisis en tiempo real. Junto con las capacidades de procesamiento en tiempo real de Realtime Compute for Apache Flink, estos servicios forman el motor principal del almacén de datos unificado de Alibaba Cloud.
Arquitectura de la solución
A continuación se muestra el diagrama completo de la canalización para el análisis unificado por lotes y en tiempo real del conjunto de datos público de eventos de GitHub, mediante MaxCompute y Hologres.
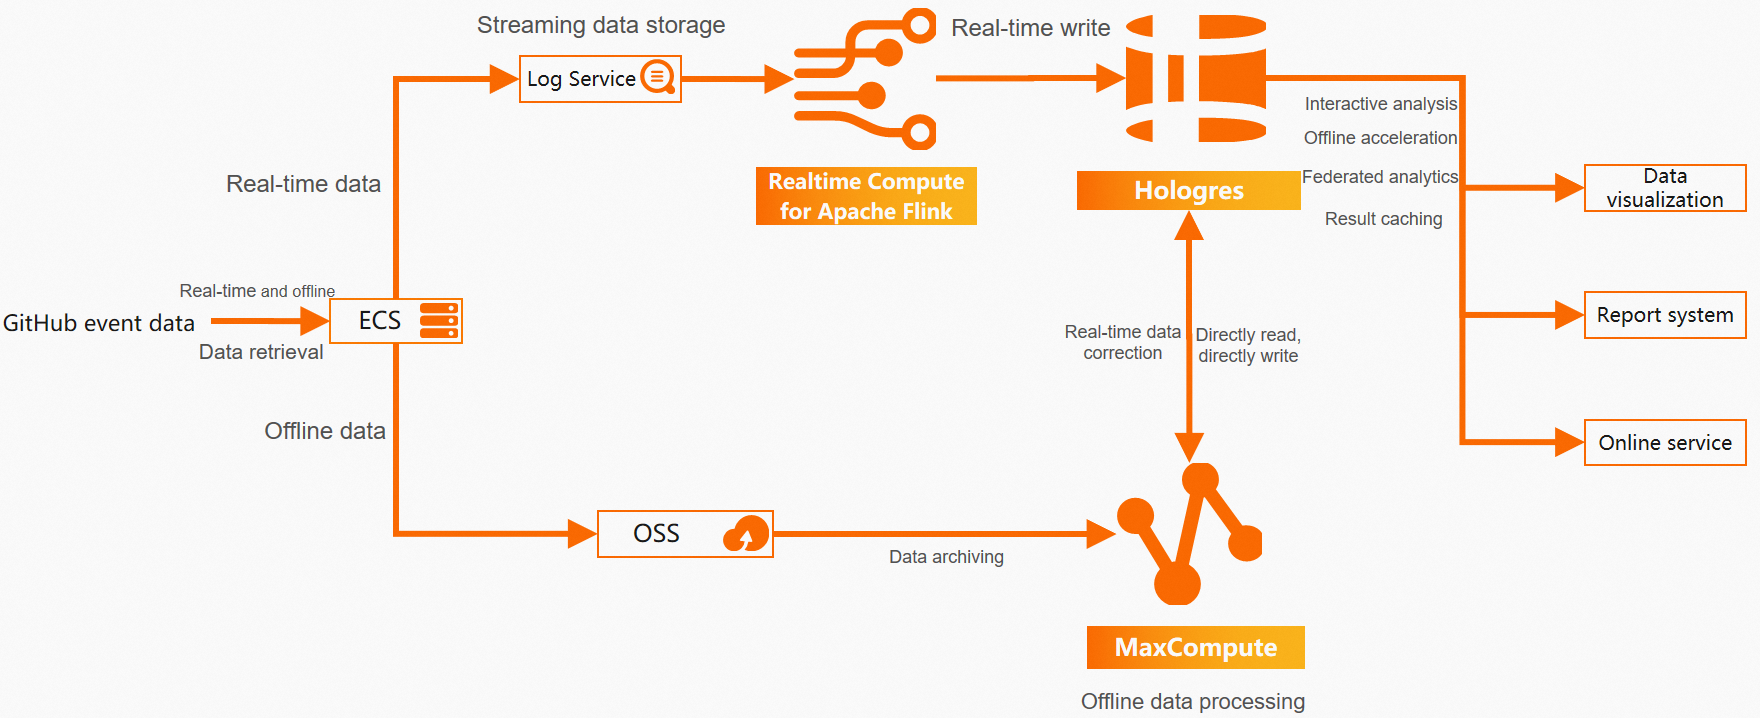
En esta arquitectura, una instancia de ECS recopila y agrega los datos de eventos en tiempo real y por lotes provenientes de GitHub, que actúan como origen de datos. La información alimenta una canalización en tiempo real y otra por lotes, y luego se consolida en Hologres como capa de servicio unificada.
Canalización en tiempo real: Realtime Compute for Apache Flink procesa los datos de Simple Log Service (SLS) en tiempo real y los escribe en Hologres. Hologres admite escrituras y actualizaciones de datos en tiempo real; además, los datos se pueden consultar inmediatamente después de su ingesta. Su integración nativa permite desarrollar almacenes de datos en tiempo real basados en modelos, con alto rendimiento y baja latencia. Esto resulta útil en casos de uso como extraer los eventos más recientes o analizar eventos en tendencia.
Canalización por lotes: MaxCompute procesa y archiva grandes volúmenes de datos por lotes. Object Storage Service (OSS) proporciona un almacenamiento práctico, seguro y de bajo costo para los datos JSON sin procesar. MaxCompute puede leer y analizar sintácticamente datos semiestructurados en OSS directamente mediante tablas externas, integrar los datos de mayor valor en su almacenamiento interno y trabajar con DataWorks para construir un almacén de datos por lotes.
Hologres se integra de forma transparente con MaxCompute en la capa de almacenamiento, lo que le permite acelerar las consultas sobre grandes volúmenes de datos históricos en MaxCompute. Esto respalda consultas de baja frecuencia y alto rendimiento sobre datos históricos. También puede usar la canalización por lotes para corregir los datos en tiempo real y resolver problemas como omisiones de información en dicha canalización.
Esta solución ofrece las siguientes ventajas:
Canalización por lotes estable y eficiente: admite escrituras y actualizaciones de datos cada hora, procesamiento por lotes a gran escala, cálculos complejos y reducción de costos de cómputo.
Canalización en tiempo real madura: admite la ingesta, el cálculo de eventos y el análisis en tiempo real, con respuestas en cuestión de segundos.
Almacenamiento y servicio unificados: Hologres proporciona una capa de servicio unificada con almacenamiento de datos centralizado y una interfaz externa coherente (una sola interfaz SQL para consultas OLAP y Key-Value).
Análisis unificado por lotes y en tiempo real: reduce la redundancia y el movimiento de datos, y permite corregirlos.
Este enfoque de desarrollo integral logra respuestas de datos en segundos, visibilidad de extremo a extremo del estado, una arquitectura simplificada con menos componentes y menores costos de operación y mantenimiento.
Comprensión del negocio y de los datos
Los desarrolladores generan muchos eventos cuando trabajan en proyectos de código abierto en GitHub. GitHub registra los detalles de cada evento, incluidos el tipo de evento, el desarrollador y el repositorio de código. GitHub pone a disposición los eventos públicos, como marcar un repositorio con una estrella o confirmar código. Para consultar la lista completa de tipos de eventos, consulte Webhook events and payloads.
GitHub proporciona los eventos públicos mediante una openapi. Esta API ofrece datos en tiempo real con un retraso de cinco minutos. Para obtener más información, consulte Events.
El proyecto GH Archive recopila y proporciona archivos por hora de los eventos públicos de GitHub. Utilice estos archivos para obtener datos sin conexión. Para obtener más información, consulte GH Archive.
Comprensión del negocio de GitHub
El negocio principal de GitHub consiste en gestionar código e interacciones. Involucra tres entidades principales: Developer, Repository y Organization.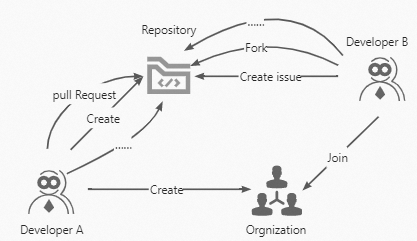
Para este análisis de datos, también se almacena y registra un Event como entidad.
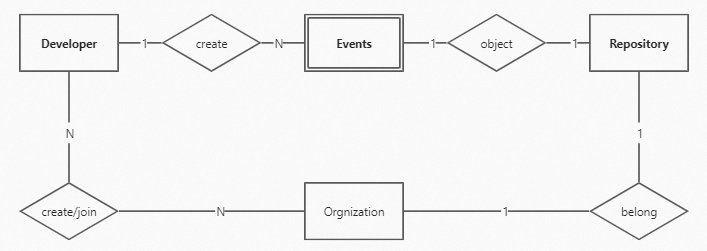
Comprensión de los datos de eventos públicos sin procesar
A continuación se muestra un ejemplo de los datos JSON de un evento sin procesar:
{
    "id": "19541192931",
    "type": "WatchEvent",
    "actor":
    {
        "id": 23286640,
        "login": "herekeo",
        "display_login": "herekeo",
        "gravatar_id": "",
        "url": "https://api.github.com/users/herekeo",
        "avatar_url": "https://avatars.githubusercontent.com/u/23286640?"
    },
    "repo":
    {
        "id": 52760178,
        "name": "crazyguitar/pysheeet",
        "url": "https://api.github.com/repos/crazyguitar/pysheeet"
    },
    "payload":
    {
        "action": "started"
    },
    "public": true,
    "created_at": "2022-01-01T00:03:04Z"
}
Este análisis abarca 15 tipos de eventos públicos. No incluye eventos que nunca ocurrieron o que ya no se registran. Para obtener detalles sobre estos tipos de eventos, consulte Github public event types.
Requisitos previos
Se creó una instancia de Elastic Compute Service (ECS) y se le asoció una dirección IP elástica (EIP). La instancia se utiliza para extraer datos de eventos en tiempo real de la API de GitHub. Para obtener más información, consulte Creation guide y Elastic IP Address.
Object Storage Service (OSS) está activado y la herramienta ossutil está instalada en la instancia de ECS para almacenar los archivos de datos JSON de GH Archive. Para obtener más información, consulte Activate OSS y Install ossutil.
MaxCompute está activado y se creó un proyecto. Para obtener más información, consulte Create a MaxCompute project.
DataWorks está activado y se creó un espacio de trabajo para configurar tareas de programación sin conexión. Para obtener más información, consulte Create a workspace.
Simple Log Service (SLS) está activado, y se crearon un proyecto y un logstore para recopilar los datos de la instancia de ECS como registros. Para obtener más información, consulte Collect and analyze ECS text logs using LoongCollector.
Se activó una instancia de Realtime Compute for Apache Flink para escribir los datos de registro de SLS en Hologres en tiempo real. Para obtener más información, consulte Activate Realtime Compute for Apache Flink.
Hologres está activado. Para obtener más información, consulte Purchase a Hologres instance.
Construcción de un almacén de datos sin conexión (actualizaciones por hora)
Descarga de archivos de datos sin procesar mediante una instancia de ECS y carga en OSS
Utilice una instancia de Elastic Compute Service (ECS) para descargar los archivos de datos JSON desde GH Archive.
Descargue los datos históricos con el comando
wget. Por ejemplo, ejecutewget https://data.gharchive.org/{2012..2022}-{01..12}-{01..31}-{0..23}.json.gzpara descargar los datos por hora de 2012 a 2022.-
Para descargar los nuevos datos generados cada hora, configure una tarea programada por hora de la siguiente manera.
NotaCompruebe que ossutil esté instalado en la instancia de ECS. Para obtener más información, consulte Install ossutil. Descargue el paquete de instalación de ossutil y cárguelo en la instancia de ECS. Ejecute
yum install unzippara instalar el software unzip. Luego, descomprima el paquete de ossutil y mueva el archivo ejecutable al directorio/usr/bin/.Compruebe que haya creado un bucket de Object Storage Service (OSS) en la misma región que su instancia de ECS. Puede usar un nombre de bucket personalizado. En este ejemplo se utiliza el nombre de bucket
githubevents.En este ejemplo, los archivos se descargan en el directorio
/opt/hourlydata/gh_datade la instancia de ECS. Puede utilizar un directorio distinto.
-
Ejecute el siguiente comando para crear un archivo llamado
download_code.shen el directorio/opt/hourlydata.cd /opt/hourlydata vim download_code.sh -
Presione
ipara entrar al modo de edición y agregue el siguiente script.d=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%-H') h=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%H') url=https://data.gharchive.org/${d}.json.gz echo ${url} # Download the data to the ./gh_data/ directory. You can use a different directory. wget ${url} -P ./gh_data/ # Change to the gh_data directory. cd gh_data # Decompress the downloaded data into a JSON file. gzip -d ${d}.json echo ${d}.json # Change to the root directory. cd /root # Use ossutil to upload the data to OSS. # Create the hr=${h} directory in the githubevents OSS bucket. ossutil mkdir oss://githubevents/hr=${h} # Upload the data from the /opt/hourlydata/gh_data directory to OSS. You can use a different directory. ossutil cp -r /opt/hourlydata/gh_data oss://githubevents/hr=${h} -u echo oss uploaded successfully! rm -rf /opt/hourlydata/gh_data/${d}.json echo ecs deleted! Presione la tecla Esc, introduzca
:wqy presione Enter para guardar y cerrar el archivo.-
Ejecute el siguiente comando para ejecutar el script
download_code.sh10 minutos después de cada hora.# 1. Run the following command and press I to enter edit mode. crontab -e # 2. Add the following command. Then, press Esc, enter :wq, and press Enter to exit. 10 * * * * cd /opt/hourlydata && sh download_code.sh > download.logUna vez que se ejecuta el script, el archivo JSON de la hora anterior se descarga 10 minutos después de cada hora. Después, el archivo se descomprime en la instancia de ECS y se carga en OSS en la ruta
oss://githubevents. Para leer únicamente el archivo de la hora anterior, durante la carga se crea un directorio llamado'hr=%Y-%M-%D-%H'como partición para cada archivo. Esto garantiza que las operaciones posteriores de escritura de datos lean archivos solo de la partición más reciente.
Importación de datos de OSS a MaxCompute mediante una tabla externa
Ejecute los siguientes comandos en el cliente de MaxCompute o en un nodo ODPS SQL de DataWorks. Para obtener más información, consulte Connect to MaxCompute by using the client (odpscmd) o Develop an ODPS SQL task.
-
Cree la tabla externa
githubeventspara leer los archivos JSON almacenados en OSS:CREATE EXTERNAL TABLE IF NOT EXISTS githubevents ( col STRING ) PARTITIONED BY ( hr STRING ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/githubevents/' ;Para obtener más información sobre cómo crear tablas externas para acceder a datos de OSS en MaxCompute, consulte Access unstructured data in OSS.
-
Cree la tabla de hechos
dwd_github_events_odpspara almacenar los datos. A continuación se muestra la instrucción del lenguaje de definición de datos (DDL):CREATE TABLE IF NOT EXISTS dwd_github_events_odps ( id BIGINT COMMENT 'Event ID' ,actor_id BIGINT COMMENT 'ID of the event initiator' ,actor_login STRING COMMENT 'Logon name of the event initiator' ,repo_id BIGINT COMMENT 'Repository ID' ,repo_name STRING COMMENT 'Full name of the repository in the format of owner/repository_name' ,org_id BIGINT COMMENT 'ID of the organization to which the repository belongs' ,org_login STRING COMMENT 'Name of the organization to which the repository belongs' ,`type` STRING COMMENT 'Event type' ,created_at DATETIME COMMENT 'Time when the event occurred' ,action STRING COMMENT 'Event action' ,iss_or_pr_id BIGINT COMMENT 'ID of the issue or pull request' ,number BIGINT COMMENT 'Number of the issue or pull request' ,comment_id BIGINT COMMENT 'Comment ID' ,commit_id STRING COMMENT 'Commit ID' ,member_id BIGINT COMMENT 'Member ID' ,rev_or_push_or_rel_id BIGINT COMMENT 'ID of the review, push, or release' ,ref STRING COMMENT 'Name of the created or deleted resource' ,ref_type STRING COMMENT 'Type of the created or deleted resource' ,state STRING COMMENT 'Status of the issue, pull request, or pull request review' ,author_association STRING COMMENT 'Relationship between the actor and the repository' ,language STRING COMMENT 'Language of the code in the pull request' ,merged BOOLEAN COMMENT 'Indicates whether the pull request was merged' ,merged_at DATETIME COMMENT 'Time when the code was merged' ,additions BIGINT COMMENT 'Number of added lines of code' ,deletions BIGINT COMMENT 'Number of deleted lines of code' ,changed_files BIGINT COMMENT 'Number of files changed in the pull request' ,push_size BIGINT COMMENT 'Number of commits' ,push_distinct_size BIGINT COMMENT 'Number of distinct commits' ,hr STRING COMMENT 'Hour when the event occurred. For example, if the event occurred at 00:23, the value of hr is 00.' ,`month` STRING COMMENT 'Month when the event occurred. For example, if the event occurred in October 2015, the value of month is 2015-10.' ,`year` STRING COMMENT 'Year when the event occurred. For example, if the event occurred in 2015, the value of year is 2015.' ) PARTITIONED BY ( ds STRING COMMENT 'Date when the event occurred, in the yyyy-mm-dd format.' ); -
Analice sintácticamente los datos JSON y escríbalos en la tabla de hechos.
Ejecute el siguiente comando para agregar particiones, analizar sintácticamente los datos JSON y escribirlos en la tabla
dwd_github_events_odps:msck repair table githubevents add partitions; set odps.sql.hive.compatible = true; set odps.sql.split.hive.bridge = true; INSERT into TABLE dwd_github_events_odps PARTITION(ds) SELECT CAST(GET_JSON_OBJECT(col,'$.id') AS BIGINT ) AS id ,CAST(GET_JSON_OBJECT(col,'$.actor.id')AS BIGINT) AS actor_id ,GET_JSON_OBJECT(col,'$.actor.login') AS actor_login ,CAST(GET_JSON_OBJECT(col,'$.repo.id')AS BIGINT) AS repo_id ,GET_JSON_OBJECT(col,'$.repo.name') AS repo_name ,CAST(GET_JSON_OBJECT(col,'$.org.id')AS BIGINT) AS org_id ,GET_JSON_OBJECT(col,'$.org.login') AS org_login ,GET_JSON_OBJECT(col,'$.type') as type ,to_date(GET_JSON_OBJECT(col,'$.created_at'), 'yyyy-mm-ddThh:mi:ssZ') AS created_at ,GET_JSON_OBJECT(col,'$.payload.action') AS action ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.id')AS BIGINT) END AS iss_or_pr_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.number')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.number')AS BIGINT) ELSE CAST(GET_JSON_OBJECT(col,'$.payload.number')AS BIGINT) END AS number ,CAST(GET_JSON_OBJECT(col,'$.payload.comment.id')AS BIGINT) AS comment_id ,GET_JSON_OBJECT(col,'$.payload.comment.commit_id') AS commit_id ,CAST(GET_JSON_OBJECT(col,'$.payload.member.id')AS BIGINT) AS member_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.review.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="PushEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.push_id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="ReleaseEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.release.id')AS BIGINT) END AS rev_or_push_or_rel_id ,GET_JSON_OBJECT(col,'$.payload.ref') AS ref ,GET_JSON_OBJECT(col,'$.payload.ref_type') AS ref_type ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.state') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.state') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.state') END AS state ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssueCommentEvent" THEN GET_JSON_OBJECT(col,'$.payload.comment.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.author_association') END AS author_association ,GET_JSON_OBJECT(col,'$.payload.pull_request.base.repo.language') AS language ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.merged') AS BOOLEAN) AS merged ,to_date(GET_JSON_OBJECT(col,'$.payload.pull_request.merged_at'), 'yyyy-mm-ddThh:mi:ssZ') AS merged_at ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.additions')AS BIGINT) AS additions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.deletions')AS BIGINT) AS deletions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.changed_files')AS BIGINT) AS changed_files ,CAST(GET_JSON_OBJECT(col,'$.payload.size')AS BIGINT) AS push_size ,CAST(GET_JSON_OBJECT(col,'$.payload.distinct_size')AS BIGINT) AS push_distinct_size ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),12,2) as hr ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,7),'/','-') as month ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,4) as year ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,10),'/','-') as ds from githubevents where hr = cast(to_char(dateadd(getdate(),-9,'hh'), 'yyyy-mm-dd-hh') as string); -
Consulte los datos.
Ejecute el siguiente comando para consultar datos de la tabla
dwd_github_events_odps:SET odps.sql.allow.fullscan=true; SELECT * FROM dwd_github_events_odps where ds = '2023-03-31' limit 10;Se devuelve el siguiente resultado de ejemplo:
El resultado contiene los siguientes campos:
id: identificador del eventoactor_id/actor_login: identificador y nombre de usuariorepo_id/repo_name: identificador y nombre del repositorioorg_id/org_login: identificador y nombre de la organización (vacío en algunos eventos)type: tipo de evento, como CreateEvent, PushEvent, DeleteEvent o PullRequestReviewEventcreated_at: hora de creaciónaction: tipo de acción
Construcción de un almacén de datos en tiempo real
Obtención de datos en tiempo real mediante ECS
Se utiliza una instancia de Elastic Compute Service (ECS) para extraer datos de eventos en tiempo real de la API de GitHub. El siguiente script de ejemplo muestra cómo recopilar datos en tiempo real desde la API de GitHub.
Cada vez que se ejecuta el script, este se mantiene activo durante 1 minuto. Durante ese periodo, recopila los datos de eventos en tiempo real que proporciona la API y almacena cada evento en formato JSON.
Este script no garantiza que se recopilen todos los datos de eventos en tiempo real.
Para recopilar datos de forma continua desde la API de GitHub, proporcione los encabezados Accept y Authorization. El valor de Accept es fijo. Para Authorization, introduzca el token de acceso personal que obtuvo de GitHub. Para obtener más información sobre cómo crear un token de acceso personal, consulte esta documentación.
-
Ejecute los siguientes comandos para crear un archivo llamado
download_realtime_data.pyen el directorio/opt/realtime.cd /opt/realtime vim download_realtime_data.py -
Presione
ipara entrar al modo de edición y agregue el siguiente contenido de ejemplo al archivo.#!python import requests import json import sys import time # Get the API URL def get_next_link(resp): resp_link = resp.headers['link'] link = '' for l in resp_link.split(', '): link = l.split('; ')[0][1:-1] rel = l.split('; ')[1] if rel == 'rel="next"': return link return None # Collect one page of data from the API def download(link, fname): # Define the Accept and Authorization headers for the GitHub API headers = {"Accept": "application/vnd.github+json","Authorization": "<Bearer> <github_api_token>"} resp = requests.get(link, headers=headers) if int(resp.status_code) != 200: return None with open(fname, 'a') as f: for j in resp.json(): f.write(json.dumps(j)) f.write('\n') print('downloaded {} events to {}'.format(len(resp.json()), fname)) return resp # Collect multiple pages of data from the API def download_all_data(fname): link = 'https://api.github.com/events?per_page=100&page=1' while True: resp = download(link, fname) if resp is None: break link = get_next_link(resp) if link is None: break # Define the current time def get_current_ms(): return round(time.time()*1000) # Define the script execution duration as 1 minute def main(fname): current_ms = get_current_ms() while get_current_ms() - current_ms < 60*1000: download_all_data(fname) time.sleep(0.1) # Run the script if __name__ == '__main__': if len(sys.argv) < 2: print('usage: python {} <log_file>'.format(sys.argv[0])) exit(0) main(sys.argv[1]) -
Presione la tecla Esc, introduzca
:wqy presione Enter para guardar y cerrar el archivo. -
Cree un archivo
run_py.shpara ejecutardownload_realtime_data.pyy almacenar por separado los datos recopilados en cada ejecución. El contenido es el siguiente.python /opt/realtime/download_realtime_data.py /opt/realtime/gh_realtime_data/$(date '+%Y-%m-%d-%H:%M:%S').json -
Cree un archivo
delete_log.shpara eliminar los datos históricos. El contenido es el siguiente.d=$(TZ=UTC date --date='2 day ago' '+%Y-%m-%d') rm -f /opt/realtime/gh_realtime_data/*${d}*.json -
Ejecute los siguientes comandos para recopilar datos de GitHub cada minuto y eliminar los datos históricos todos los días.
#1. Run the following command and press I to enter edit mode.
crontab -e

#2. Add the following commands. Then, press Esc, enter :wq, and press Enter to exit.
* * * * * bash /opt/realtime/run_py.sh
1 1 * * * bash /opt/realtime/delete_log.sh
Recopilación de datos de ECS mediante SLS
Simple Log Service (SLS) recopila los datos de eventos en tiempo real de la instancia de ECS como registros.
SLS admite la recopilación de registros de instancias de ECS mediante Logtail. Dado que los datos están en formato JSON, puede usar el modo JSON de Logtail para recopilar rápidamente registros JSON incrementales de la instancia de ECS. Para obtener más información, consulte Collect logs in JSON mode. En este tema, SLS se configura para analizar sintácticamente los pares clave-valor de nivel superior de los datos sin procesar.
En este ejemplo, el parámetro de ruta de registro de la configuración de Logtail se establece en /opt/realtime/gh_realtime_data/**/*.json.
Una vez completada la configuración, SLS recopila continuamente los datos de eventos incrementales de la instancia de ECS. Consulte los datos de registro recopilados en la pestaña Raw Logs de la consola de SLS. Cada entrada de registro contiene los campos de nivel superior analizados sintácticamente, como actor, created_at, id, org, payload, public, repo y type.
Escritura de datos de SLS en Hologres en tiempo real mediante Flink
Flink escribe en Hologres, en tiempo real, los datos de registro que recopila SLS. Al usar una tabla de origen de SLS y una tabla de resultados de Hologres en Flink, puede transmitir datos de SLS a Hologres. Para obtener más información, consulte Import data from Simple Log Service.
-
Cree una tabla interna de Hologres.
La tabla interna conserva solo algunos pares clave-valor de los datos JSON sin procesar. El
iddel evento y la fechadsse establecen como clave principal. Eliddel evento se establece como clave de distribución. La fechadsse establece como clave de partición. La hora del eventocreated_atse establece como event_time_column. Puede crear índices para otros campos según sea necesario. Para obtener más información sobre los índices, consulte CREATE TABLE. En este ejemplo se utiliza la siguiente instrucción del lenguaje de definición de datos (DDL) para crear la tabla.DROP TABLE IF EXISTS gh_realtime_data; BEGIN; CREATE TABLE gh_realtime_data ( id bigint, actor_id bigint, actor_login text, repo_id bigint, repo_name text, org_id bigint, org_login text, type text, created_at timestamp with time zone NOT NULL, action text, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id text, member_id bigint, rev_or_push_or_rel_id bigint, ref text, ref_type text, state text, author_association text, language text, merged boolean, merged_at timestamp with time zone, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr text, month text, year text, ds text, PRIMARY KEY (id,ds) ) PARTITION BY LIST (ds); CALL set_table_property('public.gh_realtime_data', 'distribution_key', 'id'); CALL set_table_property('public.gh_realtime_data', 'event_time_column', 'created_at'); CALL set_table_property('public.gh_realtime_data', 'clustering_key', 'created_at'); COMMENT ON COLUMN public.gh_realtime_data.id IS 'Event ID'; COMMENT ON COLUMN public.gh_realtime_data.actor_id IS 'ID of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.actor_login IS 'Logon name of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.repo_id IS 'repo ID'; COMMENT ON COLUMN public.gh_realtime_data.repo_name IS 'repo name'; COMMENT ON COLUMN public.gh_realtime_data.org_id IS 'ID of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.org_login IS 'Name of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.type IS 'Event type'; COMMENT ON COLUMN public.gh_realtime_data.created_at IS 'Time when the event occurred'; COMMENT ON COLUMN public.gh_realtime_data.action IS 'Event action'; COMMENT ON COLUMN public.gh_realtime_data.iss_or_pr_id IS 'issue/pull_request ID'; COMMENT ON COLUMN public.gh_realtime_data.number IS 'issue/pull_request number'; COMMENT ON COLUMN public.gh_realtime_data.comment_id IS 'comment ID'; COMMENT ON COLUMN public.gh_realtime_data.commit_id IS 'Commit ID'; COMMENT ON COLUMN public.gh_realtime_data.member_id IS 'Member ID'; COMMENT ON COLUMN public.gh_realtime_data.rev_or_push_or_rel_id IS 'review/push/release ID'; COMMENT ON COLUMN public.gh_realtime_data.ref IS 'Name of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.ref_type IS 'Type of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.state IS 'Status of the issue/pull_request/pull_request_review'; COMMENT ON COLUMN public.gh_realtime_data.author_association IS 'Relationship between the actor and the repo'; COMMENT ON COLUMN public.gh_realtime_data.language IS 'Programming language'; COMMENT ON COLUMN public.gh_realtime_data.merged IS 'Specifies whether the merge is accepted'; COMMENT ON COLUMN public.gh_realtime_data.merged_at IS 'Time when the code was merged'; COMMENT ON COLUMN public.gh_realtime_data.additions IS 'Number of added lines of code'; COMMENT ON COLUMN public.gh_realtime_data.deletions IS 'Number of deleted lines of code'; COMMENT ON COLUMN public.gh_realtime_data.changed_files IS 'Number of files changed in the pull request'; COMMENT ON COLUMN public.gh_realtime_data.push_size IS 'Number of pushes'; COMMENT ON COLUMN public.gh_realtime_data.push_distinct_size IS 'Number of distinct pushes'; COMMENT ON COLUMN public.gh_realtime_data.hr IS 'The hour when the event occurred. For example, if the time is 00:23, hr=00.'; COMMENT ON COLUMN public.gh_realtime_data.month IS 'The month when the event occurred. For example, if the date is October 2015, month=2015-10.'; COMMENT ON COLUMN public.gh_realtime_data.year IS 'The year when the event occurred. For example, if the year is 2015, year=2015.'; COMMENT ON COLUMN public.gh_realtime_data.ds IS 'The day when the event occurred. ds=yyyy-mm-dd.'; COMMIT; -
Escriba los datos en tiempo real mediante Flink.
Utilice Flink para analizar sintácticamente los datos de SLS y escribirlos en Hologres en tiempo real. Las siguientes instrucciones de Flink filtran los datos: se descartan los datos incorrectos donde el identificador del evento o la hora del evento (
created_at) son nulos, y solo se conservan los datos de eventos recientes.CREATE TEMPORARY TABLE sls_input ( actor varchar, created_at varchar, id bigint, org varchar, payload varchar, public varchar, repo varchar, type varchar ) WITH ( 'connector' = 'sls', 'endpoint' = '<endpoint>',--The private endpoint of SLS 'accessid' = '<accesskey id>',--The AccessKey ID of your account 'accesskey' = '<accesskey secret>',--The AccessKey secret of your account 'project' = '<project name>',--The name of the SLS project 'logstore' = '<logstore name>'--The name of the SLS Logstore 'starttime' = '2023-04-06 00:00:00',--The start time for SLS data collection ); CREATE TEMPORARY TABLE hologres_sink ( id bigint, actor_id bigint, actor_login string, repo_id bigint, repo_name string, org_id bigint, org_login string, type string, created_at timestamp, action string, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id string, member_id bigint, rev_or_push_or_rel_id bigint, `ref` string, ref_type string, state string, author_association string, `language` string, merged boolean, merged_at timestamp, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr string, `month` string, `year` string, ds string ) WITH ( 'connector' = 'hologres', 'dbname' = '<hologres dbname>', --The name of the Hologres database 'tablename' = '<hologres tablename>', --The name of the Hologres table that receives data 'username' = '<accesskey id>', --The AccessKey ID of the current Alibaba Cloud account 'password' = '<accesskey secret>', --The AccessKey Secret of the current Alibaba Cloud account 'endpoint' = '<endpoint>', --The VPC endpoint of the current Hologres instance 'jdbcretrycount' = '1', --The number of retries upon connection failure 'partitionrouter' = 'true', --Specifies whether to write data to a partitioned table 'createparttable' = 'true', --Specifies whether to automatically create partitions 'mutatetype' = 'insertorignore' --The data writing mode ); INSERT INTO hologres_sink SELECT id ,CAST(JSON_VALUE(actor, '$.id') AS bigint) AS actor_id ,JSON_VALUE(actor, '$.login') AS actor_login ,CAST(JSON_VALUE(repo, '$.id') AS bigint) AS repo_id ,JSON_VALUE(repo, '$.name') AS repo_name ,CAST(JSON_VALUE(org, '$.id') AS bigint) AS org_id ,JSON_VALUE(org, '$.login') AS org_login ,type ,TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS created_at ,JSON_VALUE(payload, '$.action') AS action ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.id') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.id') AS bigint) END AS iss_or_pr_id ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.number') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.number') AS bigint) ELSE CAST(JSON_VALUE(payload, '$.number') AS bigint) END AS number ,CAST(JSON_VALUE(payload, '$.comment.id') AS bigint) AS comment_id ,JSON_VALUE(payload, '$.comment.commit_id') AS commit_id ,CAST(JSON_VALUE(payload, '$.member.id') AS bigint) AS member_id ,CASE WHEN type='PullRequestReviewEvent' THEN CAST(JSON_VALUE(payload, '$.review.id') AS bigint) WHEN type='PushEvent' THEN CAST(JSON_VALUE(payload, '$.push_id') AS bigint) WHEN type='ReleaseEvent' THEN CAST(JSON_VALUE(payload, '$.release.id') AS bigint) END AS rev_or_push_or_rel_id ,JSON_VALUE(payload, '$.ref') AS `ref` ,JSON_VALUE(payload, '$.ref_type') AS ref_type ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.state') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.state') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.state') END AS state ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.author_association') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.author_association') WHEN type='IssueCommentEvent' THEN JSON_VALUE(payload, '$.comment.author_association') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.author_association') END AS author_association ,JSON_VALUE(payload, '$.pull_request.base.repo.language') AS `language` ,CAST(JSON_VALUE(payload, '$.pull_request.merged') AS boolean) AS merged ,TO_TIMESTAMP_TZ(replace(JSON_VALUE(payload, '$.pull_request.merged_at'),'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS merged_at ,CAST(JSON_VALUE(payload, '$.pull_request.additions') AS bigint) AS additions ,CAST(JSON_VALUE(payload, '$.pull_request.deletions') AS bigint) AS deletions ,CAST(JSON_VALUE(payload, '$.pull_request.changed_files') AS bigint) AS changed_files ,CAST(JSON_VALUE(payload, '$.size') AS bigint) AS push_size ,CAST(JSON_VALUE(payload, '$.distinct_size') AS bigint) AS push_distinct_size ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),12,2) as hr ,REPLACE(SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,7),'/','-') as `month` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,4) as `year` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,10) as ds FROM sls_input WHERE id IS NOT NULL AND created_at IS NOT NULL AND to_date(replace(created_at,'T',' ')) >= date_add(CURRENT_DATE, -1);Para obtener más información sobre los parámetros, consulte Simple Log Service (SLS) y Hologres.
NotaLos datos de eventos sin procesar de GitHub utilizan la zona horaria UTC y no tienen un atributo de zona horaria. La zona horaria predeterminada de Hologres es UTC+8. Por lo tanto, ajuste la zona horaria al escribir datos de Flink a Hologres en tiempo real. Asigne el atributo de zona horaria UTC a los datos de la tabla de origen en Flink SQL. Los pasos son los siguientes:
Paso 1: Ir a la página de edición de trabajos
Inicie sesión en la consola de Realtime Compute for Apache Flink.
Vaya al espacio de trabajo de destino.
Busque su trabajo de Flink SQL o JAR y haga clic en Edit.
Paso 2: Abra la pestaña Deployment Details
⚠️ Cambio importante: "Flink Configuration" ya no es una sección independiente. Se integró en "Deployment Details".
En la parte superior de la página de edición del trabajo, cambie a la pestaña Deployment Details.
Desplácese hacia abajo hasta la sección Parameter Configuration.
Paso 3: Agregue una configuración personalizada
Haga clic en el botón Edit, ubicado a la derecha de Parameter Configuration.
En el cuadro de diálogo que aparece, busque el cuadro de texto Other Configuration.
En el cuadro de texto, agregue el parámetro de Flink
table.local-time-zone:Asia/Shanghaicomo un par clave-valor para establecer la zona horaria del sistema de Flink enAsia/Shanghai.
-
Consulte los datos.
Consulte los datos de SLS escritos en Hologres mediante Flink y, después, desarrolle los datos según sus necesidades.
SELECT * FROM public.gh_realtime_data limit 10;El resultado de la consulta devuelve los siguientes campos:
idactor_idactor_loginrepo_idrepo_nameorg_idorg_logintype(tipo de evento, como PullRequestReviewEvent, CreateEvent, PushEvent, PullRequestEvent)created_atactioniss_or_pr_id
Corrección de datos en tiempo real con datos sin conexión
En este escenario, es posible que falten datos en tiempo real. Utilice los datos sin conexión para corregirlos. A continuación se muestra cómo corregir los datos en tiempo real del día anterior. Ajuste el periodo de corrección según sus necesidades.
-
Cree una tabla externa en Hologres para obtener los datos sin conexión de MaxCompute.
IMPORT FOREIGN SCHEMA <maxcompute_project_name> LIMIT to
(
    <foreign_table_name>
)
FROM SERVER odps_server INTO public OPTIONS(if_table_exist 'update',if_unsupported_type 'error');
Para más información sobre los parámetros, consulte IMPORT FOREIGN SCHEMA.
-
Cree una tabla temporal para corregir los datos en tiempo real del día anterior con los datos sin conexión.
NotaHologres V2.1.17 y versiones posteriores son compatibles con Serverless Computing. Para escenarios como la importación masiva de datos sin conexión, los trabajos ETL grandes y las consultas de alto volumen en tablas externas, utilice Serverless Computing para ejecutar estas tareas. Esta función usa recursos serverless adicionales en lugar de los recursos de su instancia, lo que mejora la estabilidad de la instancia y reduce la probabilidad de errores de falta de memoria (OOM). No necesita reservar recursos de cómputo adicionales para su instancia y solo se le cobra por las tareas que ejecuta. Para más información sobre Serverless Computing, consulte Serverless Computing. Para conocer las instrucciones de uso de Serverless Computing, consulte Use Serverless Computing.
-- Clean up potential temporary tables
DROP TABLE IF EXISTS gh_realtime_data_tmp;

-- Create a temporary table
SET hg_experimental_enable_create_table_like_properties = ON;
CALL HG_CREATE_TABLE_LIKE ('gh_realtime_data_tmp', 'select * from gh_realtime_data');

-- (Optional) Use Serverless Computing to perform large-scale offline data import and ETL jobs.
SET hg_computing_resource = 'serverless';

-- Insert data into the temporary table and update statistics
INSERT INTO gh_realtime_data_tmp
SELECT
    *
FROM
    <foreign_table_name>
WHERE
    ds = current_date - interval '1 day'
ON CONFLICT (id, ds)
    DO NOTHING;
ANALYZE gh_realtime_data_tmp;

-- Reset the configuration to ensure that non-essential SQL statements do not use Serverless resources.
RESET hg_computing_resource;

-- Replace the atomic table with the existing temporary child table
BEGIN;
DROP TABLE IF EXISTS "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data_tmp RENAME TO "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data ATTACH PARTITION "gh_realtime_data_<yesterday_date>" FOR VALUES IN ('<yesterday_date>');
COMMIT;
Análisis de datos
Los datos recopilados admiten una amplia variedad de análisis. Diseñe su almacén de datos por capas según el rango de tiempo que requiera su negocio, para que sea compatible con el análisis en tiempo real, el análisis sin conexión y el análisis integrado de ambos tipos.
Los siguientes ejemplos analizan datos en tiempo real. También puede analizar datos de repositorios de código o desarrolladores específicos.
-
Consulte el número total de eventos públicos del día actual.
SELECT
    count(*)
FROM
    gh_realtime_data
WHERE
    created_at >= date_trunc('day', now());
A continuación se muestra un resultado de ejemplo:
count ------ 1006 -
Consulte los proyectos más activos (con más eventos) del último día.
SELECT
    repo_name,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
GROUP BY
    repo_name
ORDER BY
    events DESC
LIMIT 5;
A continuación se muestra un resultado de ejemplo:
repo_name events ----------------------------------------+------ leo424y/heysiri.ml 29 arm-on/plan 10 Christoffel-T/fiverr-pat-20230331 9 mate-academy/react_dynamic-list-of-goods 9 openvinotoolkit/openvino 7 -
Consulte los desarrolladores más activos (con más eventos) del último día.
SELECT
    actor_login,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
    AND actor_login NOT LIKE '%[bot]'
GROUP BY
    actor_login
ORDER BY
    events DESC
LIMIT 5;
A continuación se muestra un resultado de ejemplo:
actor_login events ------------------+------ direwolf-github 13 arm-on 10 sergii-nosachenko 9 Christoffel-T 9 yangwang201911 7 -
Consulte la clasificación de los lenguajes de programación más populares de la última hora.
SELECT
    language,
    count(*) total
FROM
    gh_realtime_data
WHERE
    created_at > now() - interval '1 hour'
    AND language IS NOT NULL
GROUP BY
    language
ORDER BY
    total DESC
LIMIT 10;
A continuación se muestra un resultado de ejemplo:
language total -----------+---- JavaScript 25 C++ 15 Python 14 TypeScript 13 Java 8 PHP 8 -
Consulte la clasificación de proyectos según la cantidad de estrellas recibidas en el último día.
NotaEste ejemplo no contempla los casos en los que los usuarios quitan la estrella de un proyecto.
SELECT
    repo_id,
    repo_name,
    COUNT(actor_login) total
FROM
    gh_realtime_data
WHERE
    type = 'WatchEvent'
    AND created_at > now() - interval '1 day'
GROUP BY
    repo_id,
    repo_name
ORDER BY
    total DESC
LIMIT 10;
A continuación se muestra un resultado de ejemplo:
repo_id repo_name total ---------+----------------------------------+----- 618058471 facebookresearch/segment-anything 4 619959033 nomic-ai/gpt4all 1 97249406 denysdovhan/wtfjs 1 9791525 digininja/DVWA 1 168118422 aylei/interview 1 343520006 joehillen/sysz 1 162279822 agalwood/Motrix 1 577723410 huggingface/swift-coreml-diffusers 1 609539715 e2b-dev/e2b 1 254839429 maniackk/KKCallStack 1 -
Consulte los usuarios y proyectos activos diarios del día actual.
SELECT
    uniq (actor_id) actor_num,
    uniq (repo_id) repo_num
FROM
    gh_realtime_data
WHERE
    created_at > date_trunc('day', now());
A continuación se muestra un resultado de ejemplo:
actor_num	repo_num
---------+--------
743	      816