Las tablas Hash Clustering utilizan propiedades de shuffle y ordenamiento para organizar los datos. MaxCompute aprovecha estas propiedades para optimizar los planes de ejecución, lo que mejora la eficiencia y ahorra recursos. Este tema describe cómo usar tablas Hash Clustering en MaxCompute.
Contexto
La unión de tablas es un escenario común en las consultas de MaxCompute. Por ejemplo, la siguiente consulta realiza una unión interna simple entre la tabla t1 y la tabla t2 mediante la columna id.
SELECT t1.a, t2.b FROM t1 JOIN t2 ON t1.id = t2.id;MaxCompute utiliza tres métodos principales para implementar uniones:
-
Broadcast Hash Join
Cuando una de las tablas en una unión es pequeña, MaxCompute usa este método para transmitir la tabla pequeña a todas las instancias de tareas de unión. Luego, ejecuta una unión hash con la tabla grande.
-
Shuffle Hash Join
Si las tablas de la unión son grandes, no se pueden transmitir. En su lugar, MaxCompute realiza un shuffle hash en ambas tablas según la clave de unión. Los registros con el mismo valor de clave producen el mismo resultado de hash, lo que garantiza que los registros con la misma clave se envíen a la misma instancia de tarea de unión. Cada instancia construye entonces una tabla hash para el conjunto de datos más pequeño y realiza una unión de lectura secuencial con el conjunto de datos más grande.
-
Sort Merge Join
El método Shuffle Hash Join no se puede utilizar si las tablas de unión son demasiado grandes, porque no hay suficiente memoria para construir una tabla hash. Este método primero realiza un shuffle hash en la clave de unión, ordena los datos por dicha clave y luego fusiona ambos lados de la unión. La siguiente figura muestra este proceso.
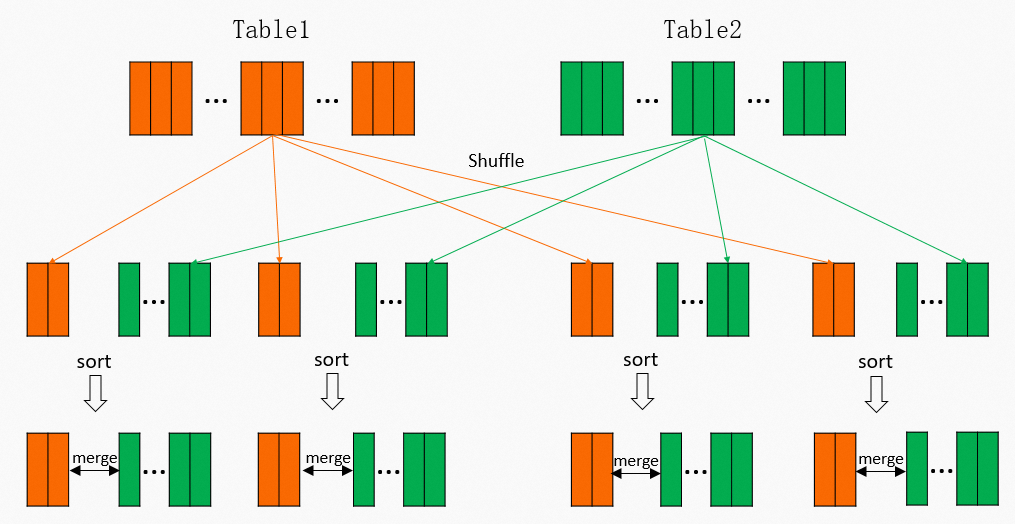 Para los volúmenes de datos y la escala comunes en MaxCompute, Sort Merge Join se usa en la mayoría de los casos. Sin embargo, esta es una operación muy costosa. Como se muestra en la figura, la operación de shuffle requiere un cálculo y los resultados intermedios deben escribirse en disco. Posteriormente, el reductor debe leer y ordenar estos datos. Para un escenario con
Mmappers yRreductores, esto resulta enM × Roperaciones de lectura de E/S. El plan de ejecución física de Fuxi correspondiente se muestra a continuación. Requiere dos etapas de Mapper y una etapa de Join. Las partes rojas indican las operaciones de shuffle y ordenamiento.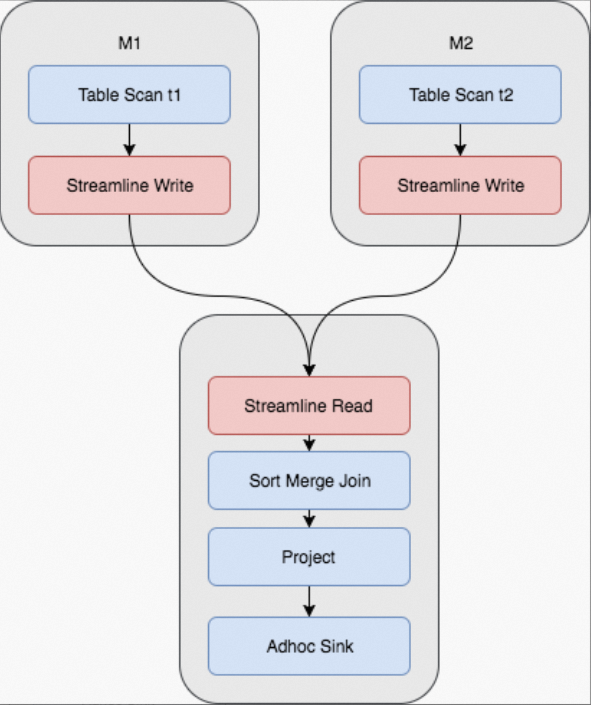 Además, algunas uniones pueden ocurrir repetidamente. Por ejemplo, si la consulta se cambia a:
SELECT t1.c, t2.d FROM t1 JOIN t2 ON t1.id = t2.id;Aunque las columnas seleccionadas son diferentes, la operación de unión es idéntica. Todo el proceso de shuffle y ordenamiento también es el mismo.
O bien, si la consulta se cambia a:
SELECT t1.c, t3.d FROM t1 JOIN t3 ON t1.id = t3.id;Esto une la tabla t1 y la tabla t3. Para la tabla t1, todo el proceso de shuffle y ordenamiento sigue siendo el mismo.
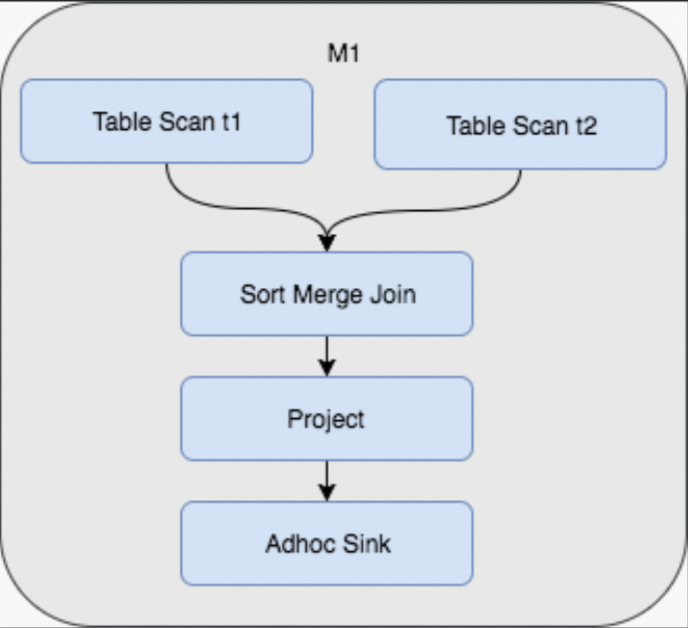
Por lo tanto, si los datos iniciales de la tabla se almacenan mediante un método de shuffle hash y ordenamiento, las consultas posteriores pueden evitar volver a realizar el shuffle y el ordenamiento de los datos. La ventaja es que un costo único durante la creación de la tabla ahorra costos repetidos de shuffle y unión en consultas subsecuentes. El plan de ejecución física de Fuxi para la unión cambia entonces como se muestra en la siguiente figura. Este cambio no solo ahorra las operaciones de shuffle y ordenamiento, sino que también reduce la consulta de tres etapas a una.
Notas de uso
Crear una tabla Hash Clustering
Puede usar la siguiente sentencia para crear una tabla Hash Clustering. Debe especificar una clave de clúster, que es la clave hash, y el número de buckets hash. El ordenamiento es opcional. Sin embargo, para obtener un rendimiento óptimo, en la mayoría de los casos debe establecer la clave de ordenamiento igual a la clave de clúster.
-
Sintaxis
CREATE TABLE [IF NOT EXISTS] <table_name> [(<col_name> <data_type> [comment <col_comment>], ...)] [comment <table_comment>] [PARTITIONED BY (<col_name> <data_type> [comment <col_comment>], ...)] [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS] [AS <select_statement>] -
Ejemplos
-
Tabla sin particiones
CREATE TABLE T1 (a string, b string, c bigint) CLUSTERED BY (c) SORTED by (c) INTO 1024 BUCKETS; -
Tabla con particiones
CREATE TABLE T1 (a string, b string, c bigint)
       PARTITIONED BY (dt string)
       CLUSTERED BY (c)
       SORTED by (c) INTO 1024 BUCKETS;
-
-
Propiedades
-
CLUSTERED BY
Especifica la clave hash. MaxCompute realiza una operación hash en las columnas especificadas y distribuye los datos en buckets según los valores hash. Para evitar la inclinación de datos, prevenir puntos críticos y lograr una buena ejecución paralela, seleccione columnas con un amplio rango de valores y pocos valores de clave duplicados para la cláusula
CLUSTERED BY. Para optimizar las uniones, también puede seleccionar claves de unión o agregación de uso frecuente, similares a las claves primarias en bases de datos tradicionales. -
SORTED BY
Especifica el orden de clasificación de los campos dentro de un bucket. Para mejorar el rendimiento, establezca la clave
SORTED BYigual a la claveCLUSTERED BY. Cuando se especifica la cláusulaSORTED BY, MaxCompute crea automáticamente un índice y lo utiliza para acelerar las consultas. -
INTO number_of_buckets BUCKETS
Especifica el número de buckets hash. Este número es obligatorio y depende del volumen de datos. Un mayor número de buckets aumenta la concurrencia y puede acortar los tiempos de ejecución de los trabajos. Sin embargo, demasiados buckets pueden crear una cantidad excesiva de archivos pequeños, y una alta concurrencia puede aumentar el tiempo de CPU. Debe configurar el número de buckets de modo que cada uno tenga un tamaño de 500 MB a 1 GB. Para tablas muy grandes, este número puede ser mayor. Para optimizar las uniones eliminando los pasos de shuffle y ordenamiento, el número de buckets de las dos tablas debe ser múltiplo entre sí, como
256y512. Se recomienda usar una potencia de 2 para el número de buckets, como 512, 1024, 2048 o 4096. Esto permite que el sistema divida y fusione automáticamente los buckets hash y elimine los pasos de shuffle y ordenamiento.
-
Cambiar las propiedades Hash Clustering de una tabla
Puede usar la sentencia ALTER TABLE para agregar o eliminar propiedades Hash Clustering en una tabla con particiones.
-
Sentencias
-- Change the table to a Hash Clustering table ALTER TABLE <table_name> [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS]; -- Change a Hash Clustering table to a non-Hash Clustering table ALTER TABLE <table_name> NOT CLUSTERED; -
Notas
La sentencia
ALTER TABLEcambia las propiedades de clúster solo para tablas con particiones. En las tablas sin particiones, las propiedades de clúster no se pueden modificar una vez establecidas.La sentencia
ALTER TABLEafecta solo a las nuevas particiones de una tabla con particiones, incluidas las generadas porINSERT OVERWRITE. Las nuevas particiones se almacenan con las nuevas propiedades de clúster. Las particiones de datos existentes permanecen sin cambios.No especifique la cláusula
PARTITIONen la sentencia, ya que esta solo afecta a las nuevas particiones.
La sentencia ALTER TABLE es adecuada para tablas existentes. Después de agregar nuevas propiedades de clúster, las nuevas particiones se almacenan utilizando Hash Clustering.
Comprobar las propiedades de la tabla
Después de crear una tabla Hash Clustering, puede ejecutar el siguiente comando para consultar sus propiedades. Las propiedades de Hash Clustering se muestran en la sección Extended Info.
DESC EXTENDED <table_name>;A continuación se muestra un ejemplo del resultado devuelto.
| Owner: ALIYUN$                          | Project:
| TableComment:
|
| CreateTime:               2017-06-19 14:10:55
| LastDDLTime:              2017-06-19 14:10:55
| LastModifiedTime:         2017-06-19 14:13:13
|
| InternalTable: YES    | Size: 21680295746
|
| Native Columns:
|
| Field           | Type    | Label | Comment
|
| l_orderkey      | bigint  |       |
| l_partkey       | bigint  |       |
| l_suppkey       | bigint  |       |
| l_linenumber    | bigint  |       |
| l_quantity      | double  |       |
| l_extendedprice | double  |       |
| l_discount      | double  |       |
| l_tax           | double  |       |
| l_returnflag    | string  |       |
| l_linestatus    | string  |       |
| l_shipdate      | string  |       |
| l_commitdate    | string  |       |
| l_receiptdate   | string  |       |
| l_shipinstruct  | string  |       |
| l_shipmode      | string  |       |
| l_comment       | string  |       |
|
| Extended Info:
|
| TableID:
| IsArchived:          false
| PhysicalSize:        65040887238
| FileNum:             1001
| ClusterType:         hash
| BucketNum:           1000
| ClusterColumns:      [l_orderkey]
| SortColumns:         [l_orderkey ASC]
Para una tabla con particiones, después de consultar las propiedades de la tabla, puede ejecutar el siguiente comando para ver las propiedades de la partición.
DESC EXTENDED <table_name> partition(<pt_spec>);A continuación se muestra un ejemplo del resultado devuelto.
| PartitionSize: 754

| CreateTime:               2017-07-07 14:01:03
| LastDDLTime:              2017-07-07 14:01:03
| LastModifiedTime:         2017-07-07 14:01:03

| IsExstore:                false
| IsArchived:               false
| PhysicalSize:             2262
| FileNum:                  2
| ClusterType:              hash
| BucketNum:                500
| ClusterColumns:           [c1]
| SortColumns:              [c1 ASC]
Ventajas de Hash Clustering
Bucket pruning y optimización de índices
CREATE TABLE t1 (id bigint,
                 a string,
                 b string)
             CLUSTERED BY (id)
             SORTED BY (id) into 1000 BUCKETS;
...
SELECT t1.a, t1.b FROM t1 WHERE t1.id=12345;idid
La consulta encuentra el bucket hash correspondiente al valor
12345. Esto requiere escanear solo un bucket en lugar de los 1,000 buckets completos. Este proceso se conoce como bucket pruning.Dado que los datos dentro del bucket están ordenados por
id, MaxCompute crea automáticamente un índice. Luego, MaxCompute utiliza una búsqueda de índice para localizar directamente los registros relevantes.
Esta optimización no solo reduce considerablemente el número de mappers, sino que también permite que los mappers localicen directamente la página de datos mediante el índice. Esto disminuye significativamente la cantidad de datos que se cargan y leen.
Por ejemplo, una tarea de big data inició 1,111 mappers y leyó 42,700 millones de registros para encontrar 26 registros coincidentes. El tiempo total de ejecución fue de 1 minuto y 48 segundos. Con una tabla Hash Clustering, la misma consulta sobre los mismos datos puede localizar directamente un solo bucket y usar un índice para leer solo las páginas que contienen los datos de la consulta. Este proceso utiliza solo 4 mappers, lee 10,000 registros y toma solo 6 segundos.
Optimización de agregaciones
Para la siguiente consulta:
SELECT department, SUM(salary) FROM employee GROUP BY (department);Normalmente, esta consulta realiza un shuffle y ordena los datos en la columna department y luego ejecuta una agregación de flujo para contar cada grupo de department. Sin embargo, si los datos de la tabla ya están agrupados y ordenados por department, las operaciones de shuffle y ordenamiento ya no son necesarias.
Optimización de almacenamiento
Incluso sin considerar las optimizaciones computacionales, simplemente realizar un shuffle y ordenar los datos de la tabla para su almacenamiento puede ahorrar espacio significativamente. MaxCompute utiliza un almacén de columnas en la capa subyacente. El ordenamiento coloca juntos los registros con valores de clave iguales o similares. Esto mejora la eficacia de la compresión y la codificación, lo que conduce a mayores tasas de compresión. En las pruebas, una tabla ordenada puede usar hasta un 50% menos de espacio de almacenamiento que una tabla no ordenada en algunos casos extremos. Para tablas con un ciclo de vida largo, usar Hash Clustering para el almacenamiento es una optimización que vale la pena.
El siguiente experimento utiliza la tabla lineitem de 100 GB del conjunto de datos TPC-H. La tabla contiene diversos tipos de datos, como int, double y string. Con los mismos datos y método de compresión, comparamos el tamaño de almacenamiento de una tabla con y sin Hash Clustering. La tabla con Hash Clustering utilizó aproximadamente un 10% menos de almacenamiento, como se muestra en las siguientes figuras.
-
Sin Hash Clustering
odps@xxx>desc tpch_lineitem; +------------------------------------------------------------------------------------+ | Owner: xxx | Project: xxx | | TableComment: | +------------------------------------------------------------------------------------+ | CreateTime: 2016-04-17 21:48:08 | | LastDDLTime: 2016-04-17 21:48:08 | | LastModifiedTime: 2016-04-17 21:50:10 | +------------------------------------------------------------------------------------+ | InternalTable: YES | Size: 23573055432 | +------------------------------------------------------------------------------------+ | Native Columns: | +------------------------------------------------------------------------------------+ | Field | Type | Label | Comment | +------------------------------------------------------------------------------------+ | l_orderkey | bigint | | | | l_partkey | bigint | | | | l_suppkey | bigint | | | | l_linenumber | bigint | | | | l_quantity | double | | | | l_extendedprice | double | | | | l_discount | double | | | | l_tax | double | | | | l_returnflag | string | | | | l_linestatus | string | | | | l_shipdate | string | | | | l_commitdate | string | | | | l_receiptdate | string | | | | l_shipinstruct | string | | | | l_shipmode | string | | | | l_comment | string | | | +------------------------------------------------------------------------------------+ -
Con Hash Clustering
odps@ xxx      >desc tpch_lineitem_hash_500;

| Owner:          xxx               | Project:    xxx
| TableComment:

| CreateTime:          2017-07-13 14:40:11
| LastDDLTime:         2017-07-13 14:40:11
| LastModifiedTime:    2017-07-13 15:05:04

| InternalTable: YES  | Size: 21658913950

| Native Columns:

| Field            | Type      | Label | Comment

| l_orderkey       | bigint    |       |
| l_partkey        | bigint    |       |
| l_suppkey        | bigint    |       |
| l_linenumber     | bigint    |       |
| l_quantity       | double    |       |
| l_extendedprice  | double    |       |
| l_discount       | double    |       |
| l_tax            | double    |       |
| l_returnflag     | string    |       |
| l_linestatus     | string    |       |
| l_shipdate       | string    |       |
| l_commitdate     | string    |       |
| l_receiptdate    | string    |       |
| l_shipinstruct   | string    |       |
| l_shipmode       | string    |       |
| l_comment        | string    |       |
Datos de prueba y análisis
Las ventajas generales de rendimiento de Hash Clustering se midieron utilizando el conjunto de pruebas estándar TPC-H. La prueba utilizó 1 TB de datos y 500 buckets para todas las tablas. Excepto por las dos tablas pequeñas, nation y region, todas las demás tablas utilizaron la primera columna como clave de clúster y ordenamiento. Los resultados generales de la prueba muestran que, tras usar Hash Clustering, el tiempo total de CPU se redujo aproximadamente un 17.3% y el tiempo total de ejecución del trabajo se redujo aproximadamente un 12.8%.
Tenga en cuenta que no todas las consultas en TPC-H pueden usar la propiedad de clúster. En particular, las dos consultas de mayor duración no pueden utilizar esta propiedad. Por lo tanto, la mejora general de eficiencia no es drástica. Sin embargo, para las consultas que sí pueden usar la propiedad de clúster, las ventajas son significativas. Por ejemplo, Q4 fue aproximadamente un 68% más rápida, Q12 fue aproximadamente un 62% más rápida y Q10 fue aproximadamente un 47% más rápida.
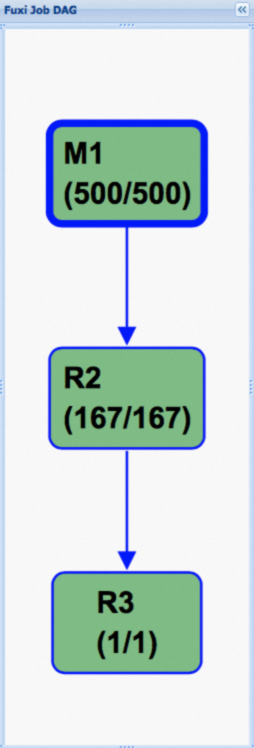
La siguiente figura muestra el plan de ejecución de Fuxi para TPC-H Q4 en una tabla estándar: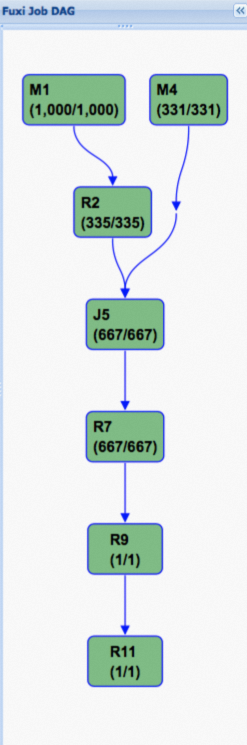 La siguiente figura muestra el plan de ejecución después de usar Hash Clustering. Como puede observar, el grafo acíclico dirigido (DAG) se simplifica enormemente. Esta es la razón clave de la importante mejora de rendimiento.