Este documento describe cómo usar la función de IA de MaxFrame en Alibaba Cloud MaxCompute y presenta casos de uso para comenzar a trabajar con aplicaciones de inference offline de modelos de lenguaje grandes.
Descripción general
La función de IA de MaxFrame es una solución integral para el inference offline de modelos de lenguaje grandes (LLM) en la plataforma Alibaba Cloud MaxCompute. Integra de forma transparente el procesamiento de datos con las capacidades de IA, lo que simplifica la adopción de modelos de lenguaje grandes a nivel empresarial.
Filosofía de diseño: "Entran datos, salen resultados". Esto le permite usar el framework Python de MaxFrame y API con estilo pandas para completar todo el flujo de trabajo dentro del ecosistema de MaxCompute: desde la preparación y el procesamiento de los datos hasta el inference del modelo y el almacenamiento de los resultados.
Casos de uso: Esta función resulta ideal para procesar volúmenes masivos de datos estructurados, como registros de análisis y de comportamiento de usuarios, así como datos no estructurados en tareas de traducción de texto, resumen de documentos y vectorización. Procesa datos a escala de petabytes en un solo trabajo y alcanza baja latencia y escalabilidad lineal gracias a su arquitectura de cómputo distribuido. Sirve para extraer información estructurada de textos, organizar y resumir contenido, generar resúmenes, traducir idiomas, evaluar la calidad textual y clasificar sentimientos. Todo esto simplifica enormemente el procesamiento de datos para modelos de lenguaje grandes y mejora la calidad de los resultados.
-
Arquitectura
La función de IA de MaxFrame ofrece una interfaz
generateflexible y de propósito general, además de interfacestaskconcisas y específicas para escenarios como traducción de texto, extracción de datos estructurados y vectorización. Usted selecciona un modelo y proporciona como entrada una tabla de MaxCompute junto con los prompts.Cuando se llama a una interfaz, MaxFrame fragmenta primero los datos de la tabla de entrada. Usted establece un nivel de concurrencia adecuado según el volumen de datos e inicia un grupo de workers para ejecutar el trabajo de cómputo. Cada worker utiliza la plantilla de prompt proporcionada para representar y construir las entradas del modelo a partir de las filas de datos, ejecuta el trabajo de inference y escribe los resultados y el estado de éxito de vuelta en MaxCompute.
A continuación se muestra la arquitectura y el flujo de trabajo.
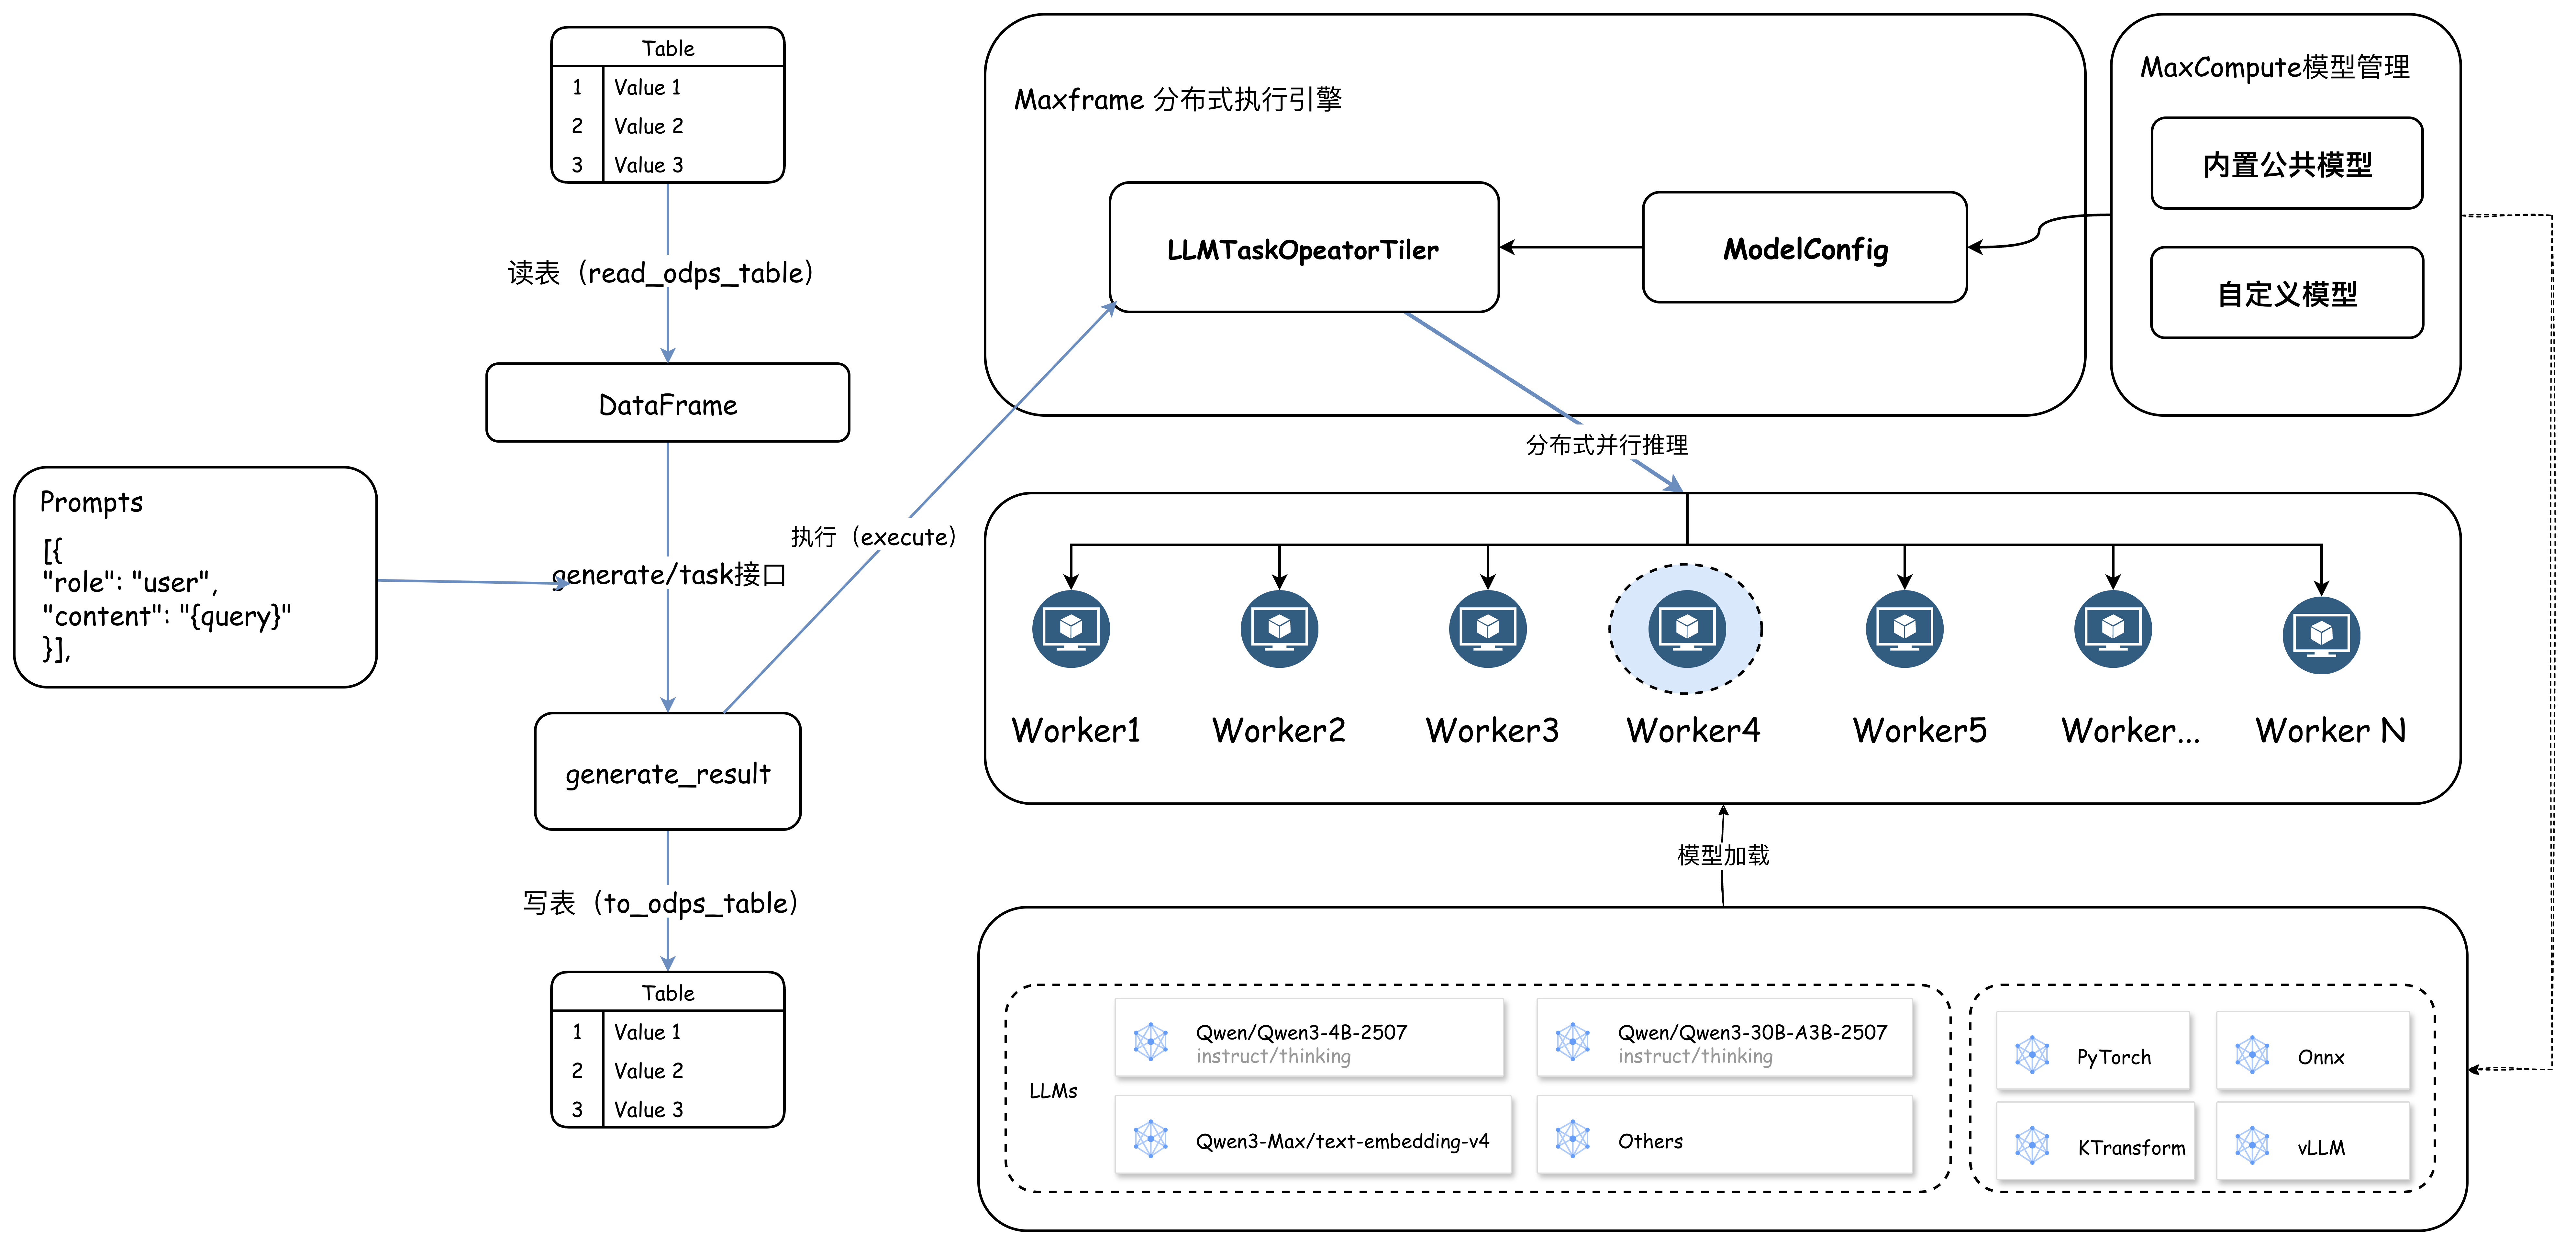
-
Ventajas principales:
Facilidad de uso: API de Python conocidas, una biblioteca de modelos lista para usarse y costo de despliegue nulo.
Escalabilidad: Aprovecha los recursos de cuota CU, cuota GU e Inference Quota de MaxCompute para admitir el procesamiento paralelo a gran escala y mejorar el rendimiento general de tokens.
Integración de datos e IA: Complete todo su flujo de trabajo en una sola plataforma, desde la lectura y el procesamiento de datos hasta el inference de IA y el almacenamiento de resultados. Esto reduce los costos de migración de datos y mejora la eficiencia de desarrollo.
Amplia cobertura de escenarios: Abarca más de 10 casos de uso comunes, entre ellos traducción, extracción de datos estructurados y vectorización.
Requisitos
-
Regiones compatibles:
China (Hangzhou), China (Shanghai), China (Beijing), China (Ulanqab), China (Shenzhen), China (Chengdu), China (Hong Kong), China (Hangzhou) Finance Cloud y China (Shanghai) Finance Cloud.
Versión de Python compatible: 3.11.
-
Versión del SDK compatible: Asegúrese de que la versión de su SDK de MaxFrame sea la 2.7.1 o posterior. Compruebe la versión al ejecutar uno de los comandos siguientes:
// For Windows
pip list | findstr maxframe

// For Linux
pip list | grep maxframe
Si su versión está desactualizada, ejecute
pip install --upgrade maxframepara actualizar a la versión más reciente.
Modelos compatibles
MaxFrame admite de forma inmediata una serie de modelos de lenguaje grandes integrados, entre ellos Qwen 3, DeepSeek-R1-Distill-Qwen y Qwen3-embedding. También permite llamar a modelos comerciales insignia de Model Studio, como los modelos multimodales qwen3.7-max, qwen3.6-plus, qwen3.6-flash, deepseek-v4-pro, deepseek-v4-flash y qwen3-vl-embedding, además del modelo de texto text-embedding-v4. Todos los modelos se alojan de manera offline dentro de la plataforma MaxCompute. Así se elimina la necesidad de gestionar descargas de modelos, su distribución o los límites de concurrencia de API. Usted utiliza los modelos mediante llamadas simples a la API, lo que le permite aprovechar los enormes recursos de cómputo de MaxCompute para completar tareas de inference offline con alta concurrencia y un gran rendimiento general de tokens.
Modelos compatibles
Tipo de modelo | Nombre del modelo | Cuota |
Modelos comerciales de Model Studio |
|
|
Modelos de código abierto de la serie Qwen 3 |
|
|
Modelos de código abierto de Qwen Embedding |
|
|
Modelos de código abierto de la serie Deepseek-R1-Distill-Qwen |
|
|
Modelos de código abierto Deepseek-R1-0528-Qwen3 |
|
|
Tipos de recursos de cuota
MaxFrame admite tres tipos de recursos para que usted elija el que mejor se ajuste al tamaño de su modelo y a sus requisitos de negocio.
Recursos de cuota CU
Una unidad de cómputo (CU) es un recurso de cómputo de CPU de propósito general (1 vCPU y 4 GB de memoria) adecuado para modelos pequeños y tareas de inference a pequeña escala.
Configuración:
# Use CU quota compute resources.
options.session.quota_name = "mf_cpu_quota"
Recursos de cuota GU
Una unidad de GPU (GU) es un recurso de cómputo de GPU optimizado para el inference de LLM. Admite modelos más grandes y resulta adecuada para tareas de inference con modelos de 8B de parámetros o más.
Configuración:
# Use GU quota compute resources.
options.session.gu_quota_name = "mf_gpu_quota"
Recursos de Inference Quota (facturación basada en tokens)
Esta opción le permite llamar a modelos de lenguaje grandes comerciales de Model Studio, como qwen3-max y text-embedding-v4. La facturación se basa en el consumo real de tokens. Este enfoque elimina la necesidad de aprovisionar recursos CU o GU y de gestionar la infraestructura subyacente, por lo que ofrece una solución flexible, práctica y rentable.
Referencia de API
La función de IA de MaxFrame proporciona dos interfaces para equilibrar flexibilidad y facilidad de uso: la interfaz de propósito general generate y las interfaces específicas de tarea task.
General: generate
Interfaz generate
Parámetros clave
|
Parámetro |
Obligatorio |
Descripción |
|
model_name |
Sí |
Nombre del modelo que se va a utilizar. |
|
df |
Sí |
Texto o datos que se van a analizar, encapsulados en un DataFrame. |
|
prompt_template |
Sí |
Lista de mensajes compatible con el formato de mensajes de chat de OpenAI. En el contenido puede usar la sintaxis |
Específica de tarea: task
Interfaz específica de escenario: Task
Las interfaces de tarea predefinidas y estandarizadas simplifican el desarrollo en los casos de uso más comunes. Entre las interfaces task compatibles actualmente se incluyen translate, extract y embed.
-
Parámetros clave
Parámetro
Obligatorio
Descripción
model_name
Sí
Nombre del modelo que se va a utilizar.
df
Sí
Texto o datos que se van a analizar, encapsulados en un DataFrame.
task interface
Sí
translate: realiza traducciones de idioma.extract: extrae datos estructurados.embed: realiza la vectorización.
-
Ejemplo de uso
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="<model_name>")

# Translate text.
translated_df = llm.translate(
    df["english_column"],
    source_language="english",
    target_language="Chinese",
    examples=[("Hello", "你好"), ("Goodbye", "再见")],
)

translated_df.execute()
Casos de uso
Cuota GU
Escenarios de cuota GU
Traducción de idiomas
Escenario: Una empresa multinacional necesita traducir 100 000 contratos del inglés al chino y anotar las cláusulas clave.
import os
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# Initialize the MaxFrame session.
session = new_session(o)

# Print the Logview URL for the job.
print(session.get_logview_address())

# 1. Use GU quota compute resources.
options.session.gu_quota_name = "mf_gu_quota"

# 2. Use the Qwen3-1.7B model.
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-1.7B")

# 3. Prepare the data. You can skip this step if you already have data.
# o.execute_sql("""
#   CREATE TABLE IF NOT EXISTS raw_contracts (
#       en STRING
#   );
#   """)
#
# o.execute_sql("""
#   INSERT INTO raw_contracts VALUES
#   ('This agreement is governed by the laws of the State of California.'),
#   ('The tenant shall pay rent on the first day of each month.'),
#   ('Either party may terminate this contract with 30 days written notice.'),
#   ('All intellectual property rights shall remain with the original owner.'),
#   ('The warranty period for this product is twelve months from the date of purchase.');
#   """)

df = md.read_odps_table("raw_contracts")

# 4. Define the prompt template.
messages = [
    {
        "role": "system",
        "content": "You are a document translation expert who can fluently translate English text into Chinese.",
    },
    {
        "role": "user",
        "content": "Translate the following English text into Chinese. Output only the translated text, with no other content.\n\n Example:\nInput: Hi\nOutput: 你好。\n\n Text to translate:\n\n{en}",
    },
]

# 5. Call the `generate` interface, define the prompt, and reference the corresponding data column.
result_df = llm.generate(
    df,
    prompt_template=messages,
    params={
        "temperature": 0.7,
        "top_p": 0.8,
    },
).execute()

# 6. Write the results to a MaxCompute table.
result_df.to_odps_table("raw_contracts_result")
Extracción de palabras clave
Escenario: Este caso de uso demuestra cómo la función de IA de MaxFrame procesa datos no estructurados. Gran parte de estos datos consiste en texto e imágenes, lo cual representa un reto importante para el análisis de big data. El ejemplo siguiente muestra cómo usar la función de IA para simplificar este proceso.
El código siguiente demuestra cómo usar la función de IA para extraer la experiencia laboral de un candidato a partir de un currículum. Como entrada se utiliza un texto de currículum generado de forma aleatoria. Para conocer prácticas de desarrollo detalladas y demostraciones, consulte AI Function on GU Development Practices.
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# Initialize the MaxFrame session.
session = new_session(o)

# Print the Logview URL for the job.
print(session.get_logview_address())

# 1. Use GU quota compute resources.
options.session.gu_quota_name = "mf_gu_quota"

# 2. Use the Qwen3-4B model.
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-4B-Instruct-2507-FP8")

df = md.read_odps_table("traditional_chinese_medicine", index_col="index")

# Specify four concurrent partitions.
parallel_partitions = 4
df = df.mf.rebalance(num_partitions=parallel_partitions)

# 3. Use the preset `extract` task interface.
result_df = llm.extract(
    df["text"],
    description="Please extract structured data from the following medical record in order. Return the final output in strict JSON format according to the schema.",
    schema=MedicalRecord,
    examples=[(example_input, example_output)],
)
result_df.execute()
Cuota de inference
Escenarios de cuota de inference
Vectorización de texto: text-embedding-v4
Escenario: Utilice el modelo comercial text-embedding-v4 de Model Studio para realizar tareas de vectorización. La facturación se basa en el consumo de tokens, lo que elimina la necesidad de gestionar los recursos de cómputo subyacentes. Este escenario es adecuado para análisis de texto complejos y tareas de inference de alta calidad que requieren modelos grandes o modelos de lenguaje grandes comerciales de Model Studio.
Comprensión de imágenes: qwen3.6-plus
Escenario: Este escenario es adecuado para tareas de inference de alta calidad, análisis de texto complejo o procesamiento de datos multimodales que requieren modelos grandes o modelos de lenguaje grandes comerciales de Model Studio. Los recursos se consumen bajo demanda, lo que le ayuda a controlar los costos.
Optimización del rendimiento
Inference paralelo
MaxFrame utiliza cómputo paralelo para ejecutar el inference offline a gran escala:
Fragmentación de datos: La interfaz
rebalancedistribuye la tabla de datos de entrada de manera uniforme entre varios nodos worker, según el número de particiones especificado (num_partitions).Carga paralela de modelos: Cada worker carga y precalienta el modelo de forma independiente. Esto evita la latencia de arranque en frío provocada por la carga del modelo.
Agregación de resultados: Los resultados de salida se escriben por partición en una tabla de MaxCompute, lo que facilita el análisis de datos posterior.
Recomendaciones de ajuste
-
Cambio de recursos de cómputo heterogéneos
En modelos grandes (de 8B de parámetros o más), el inference con CPU resulta ineficiente. Se recomienda cambiar a recursos de cuota GU o de Inference Quota para el inference.
-
Procesamiento paralelo de particiones de datos
Para trabajos de inference a gran escala, utilice la interfaz
rebalancepara fragmentar los datos y procesarlos en paralelo según su distribución.