Hay tres herramientas de depuración disponibles, ordenadas de la más ligera a la más compleja:
Visualizar el plan de ejecución: consulte cómo PyODPS optimiza y combina sus operaciones antes de ejecutarlas.
Inspeccionar el SQL compilado: compruebe el código SQL que PyODPS genera para el backend de SQL de MaxCompute.
Ejecutar localmente con pandas: descargue una muestra pequeña e itere rápidamente sin programar un trabajo de MaxCompute.
Visualizar el plan de ejecución
Si visualiza el plan de ejecución antes de ejecutar un cálculo, identificará dónde se combinan las operaciones en una sola etapa y dónde existen límites explícitos entre etapas. Esto revela posibles cuellos de botella, como operaciones que no se pueden paralelizar, antes de que afecten los trabajos en producción.
Requisitos previos: instale graphviz y el paquete de Python graphviz.
Llame al método .visualize() en cualquier DataFrame para representar su gráfico de cálculo.
Ejemplo: operaciones combinadas en una sola etapa
Cuando ningún límite de caché separa las operaciones, PyODPS las combina automáticamente:
>>> df = iris.groupby('name').agg(id=iris.sepalwidth.sum())
>>> df = df[df.name, df.id + 3]
>>> df.visualize()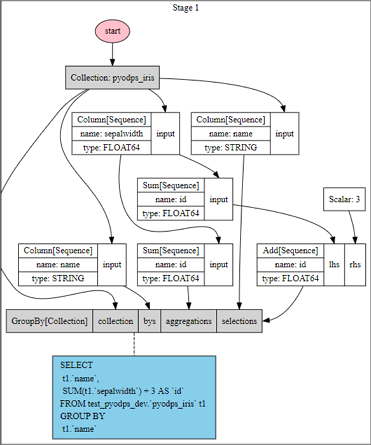
El gráfico muestra que PyODPS combina las operaciones groupby y de filtrado de columnas en una sola etapa.
Ejemplo: operaciones divididas en dos etapas
Si inserta .cache() entre las operaciones, forzará un límite de etapa:
>>> df = iris.groupby('name').agg(id=iris.sepalwidth.sum()).cache()
>>> df2 = df[df.name, df.id + 3]
>>> df2.visualize()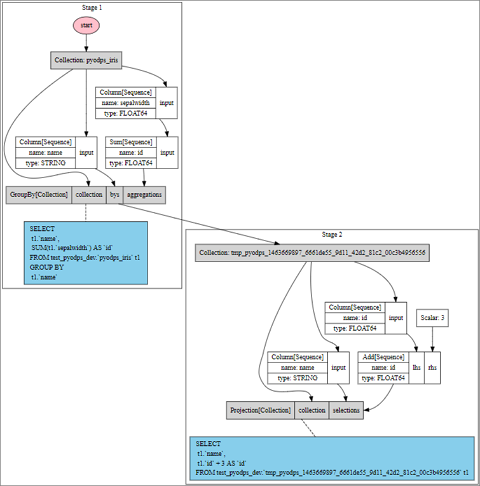
Ahora el gráfico muestra dos etapas porque la llamada a .cache() crea un límite de ejecución explícito. Al comparar estos dos gráficos, queda claro dónde ocurren las divisiones de etapa y dónde es posible combinarlas.
Inspeccionar el SQL compilado
Llame al método .compile() para ver el código SQL que PyODPS genera para el backend de SQL de MaxCompute. Úselo para comprobar que la consulta generada coincide con lo que necesita antes de enviar un trabajo.
>>> df = iris.groupby('name').agg(sepalwidth=iris.sepalwidth.max())
>>> df.compile()
Stage 1:

SQL compiled:

SELECT
  t1.`name`,
  MAX(t1.`sepalwidth`) AS `sepalwidth`
FROM test_pyodps_dev.`pyodps_iris` t1
GROUP BY
  t1.`name`
Ejecutar localmente con pandas
Para iterar más rápido, descargue una muestra pequeña de datos desde MaxCompute y ejecútela con el backend de cálculo de pandas. Como PyODPS usa el servicio MaxCompute Tunnel para descargar los datos directamente, se omite por completo el programador del backend de SQL de MaxCompute. Por lo tanto, no hay tiempos de espera por la programación de trabajos.
A continuación se muestran las operaciones que activan una descarga mediante Tunnel en lugar de un trabajo de SQL de MaxCompute:
Tabla sin particiones: seleccione todas o algunas filas, filtre columnas o cuente filas. El filtrado de columnas no calcula los valores de estas.
>>> iris.count()
>>> iris['name', 'sepalwidth'][:10]
Tabla con particiones: seleccione filas de todas las columnas de partición o de las primeras, filtre columnas o cuente filas.
>>> df[:10]
>>> df[df.ds == '20160808']['f0', 'f1']
>>> df[(df.ds == '20160808') & (df.hh == 3)][:10]
>>> df[(df.ds == '20160808') & (df.hh == 3) & (df.mm == 15)]
Alternar entre el modo local y el de producción
Use un indicador DEBUG para alternar entre la ejecución local con pandas y la ejecución completa en MaxCompute:
>>> DEBUG = True
>>> if DEBUG:
>>> df = iris[:100].to_pandas(wrap=True)
>>> else:
>>> df = iris
Establezca DEBUG = True durante el desarrollo para descargar los datos de forma local. Establezca DEBUG = False antes de ejecutar en producción para que el cálculo completo se ejecute en MaxCompute.
La ejecución local y la ejecución en MaxCompute no son equivalentes. Algunos programas que superan la depuración local pueden fallar en MaxCompute debido a las restricciones del sandbox. Pruebe siempre en el entorno de producción antes de confiar en los resultados locales.