Hologres Dynamic Table es una arquitectura declarativa de procesamiento de datos que procesa y almacena automáticamente los resultados agregados de una o más tablas base. Incluye políticas de actualización de datos integradas y configurables que permiten el reenvío automático de datos desde las tablas base hacia las Dynamic Tables. De este modo, cubre la necesidad de un desarrollo unificado, un reenvío automático de datos y un procesamiento oportuno de la información.
Cuándo usar Dynamic Table
Dynamic Table es adecuado en los siguientes casos:
Cuando necesita automatizar la transformación de datos sin escribir código de programación personalizado.
Cuando desea evitar el seguimiento manual de las dependencias de datos y la gestión de los calendarios de actualización.
Cuando requiere encadenar varias tablas para transformar datos en un pipeline. Por ejemplo, para compilar automáticamente las capas de detalle del almacén de datos (DWD), servicio del almacén de datos (DWS) y servicio de datos de aplicación (ADS).
Cuando su carga de trabajo no exige una actualización estricta en tiempo real y basta con una latencia de minutos u horas.
Cuando busca consolidar una arquitectura Lambda en un solo motor con una interfaz SQL unificada.
Ventajas
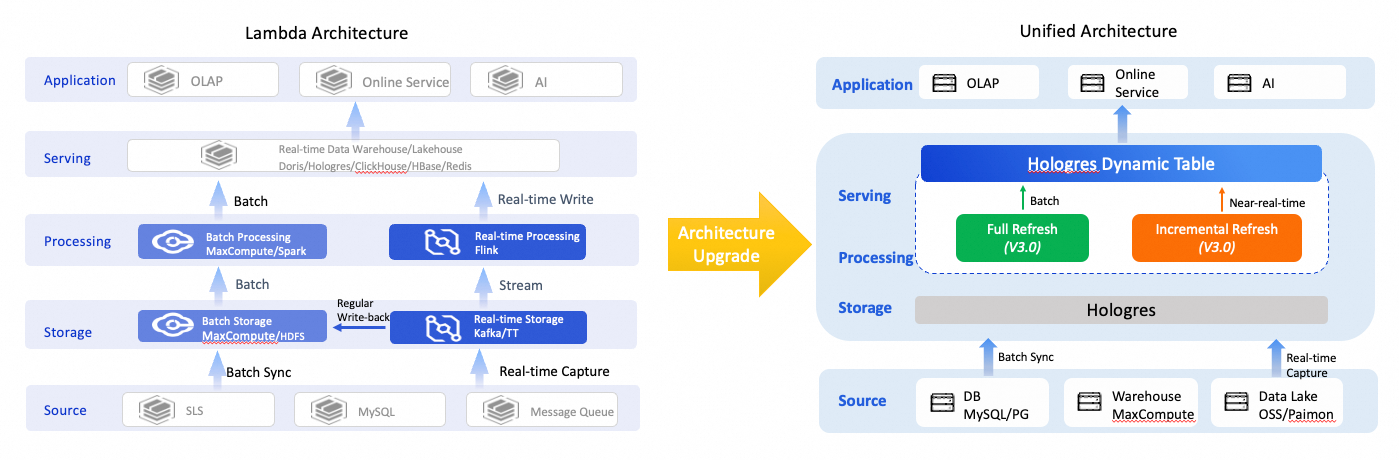
Arquitectura de almacén de datos simplificada: los modos de actualización completa e incremental admiten tanto la transformación de datos sin conexión como la transformación casi en tiempo real. Gracias al almacenamiento unificado de Hologres, Dynamic Table atiende directamente diversos escenarios de aplicación (consultas de procesamiento analítico en línea [OLAP], servicios en línea y cargas de trabajo de IA) mediante un solo motor, un único cálculo y una sola instrucción SQL. Esto sustituye a la arquitectura Lambda y reduce los costos de desarrollo, así como los de operación y mantenimiento (O&M).
Automatic data warehouse layering: una Dynamic Table activa su actualización de forma automática según la frescura de los datos de la tabla base. Esto permite reenviar datos automáticamente entre las capas operation data store (ODS) → DWD → DWS → ADS.
Mayor eficiencia de ETL: la actualización incremental procesa únicamente los datos nuevos de la tabla base en cada ejecución. Así se reduce el volumen de datos calculado por ciclo de extracción, transformación y carga (ETL). Los recursos no necesitan permanecer activos de manera constante, como ocurre en la computación de flujos. Además, las actualizaciones automáticas activadas por la frescura de los datos disminuyen los costos de cómputo.
Menores costos de desarrollo y O&M: todos los modos de actualización utilizan una interfaz SQL unificada. Las Dynamic Tables gestionan automáticamente las tareas de actualización y las dependencias jerárquicas entre capas, lo que simplifica los flujos de trabajo complejos de desarrollo y O&M.
Conceptos clave
Tabla base: es el origen de datos de una Dynamic Table. Puede tratarse de una única tabla interna o externa, o bien de una unión (join) de varias tablas. Los tipos de tabla base compatibles varían según el modo de actualización. Para obtener más información, consulte Supported features and limits of Dynamic Table.
Consulta: es la consulta especificada al crear una Dynamic Table. Define cómo se procesan los datos de la tabla base, de manera similar a un proceso ETL. Los tipos de consulta compatibles varían según el modo de actualización. Para obtener más información, consulte Supported features and limits of Dynamic Table.
Actualización: cuando cambian los datos de una tabla base, la Dynamic Table debe actualizarse para reflejar dichos cambios. Las Dynamic Tables ejecutan automáticamente las tareas de actualización en segundo plano, según la hora de inicio y el intervalo configurados. Para obtener más información sobre el monitoreo y la gestión de las tareas de actualización, consulte Manage Dynamic Table refresh tasks.
Funcionamiento
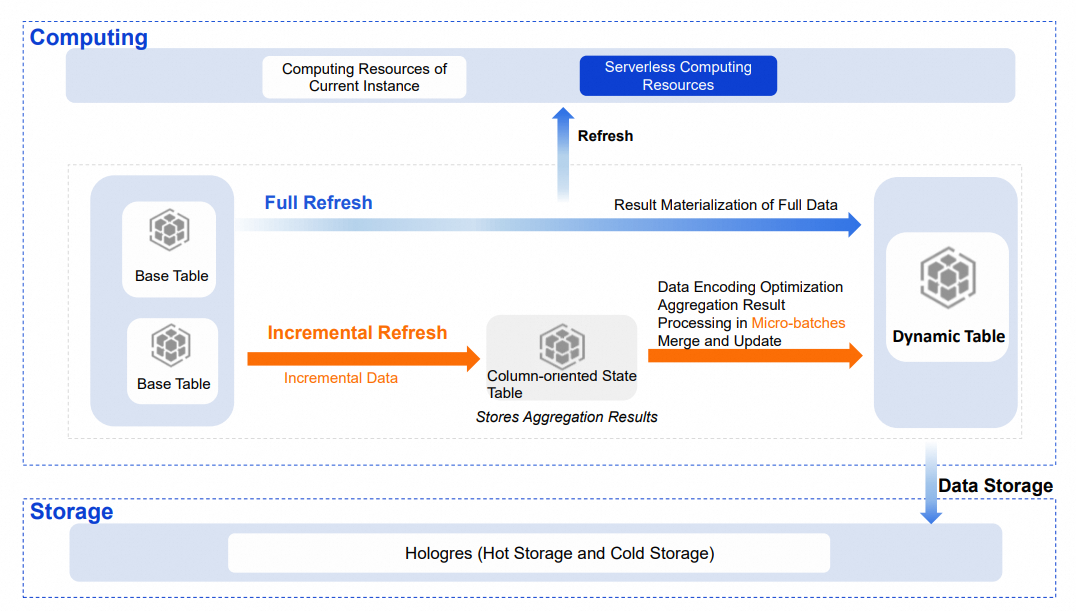
Los datos de una tabla base se escriben en una Dynamic Table mediante un proceso de actualización, el cual sigue el flujo de procesamiento definido por la consulta de la Dynamic Table. En las siguientes secciones se describen los principios técnicos de Dynamic Table, incluidos los modos de actualización, los recursos de cómputo, el almacenamiento de datos y los índices de tabla.
Modos de actualización
Dynamic Table admite dos modos de actualización: completo e incremental. Los principios técnicos subyacentes difieren según el modo configurado.
Actualización completa
La actualización completa reprocesa todos los datos durante cada ejecución y sobrescribe la Dynamic Table con los resultados totales calculados a partir de la tabla base. Su principio es similar al de una operación INSERT OVERWRITE. Este proceso genera un gran volumen de datos de Binlog y provoca una sobrecarga considerable de almacenamiento. Para conocer los límites y saber cómo deshabilitar Binlog, consulte INSERT OVERWRITE.
Actualización incremental
La actualización incremental lee únicamente los datos nuevos de la tabla base en cada ejecución. Calcula el resultado final a partir del estado de agregación intermedio y los datos incrementales, y luego actualiza la Dynamic Table. En comparación con la actualización completa, este método procesa menos datos por ejecución, lo que mejora la puntualidad y reduce el uso de recursos de cómputo.
Principio técnico
Al crear una Dynamic Table con actualización incremental, el sistema lee los datos incrementales de la tabla base mediante el método Stream o Binlog. Después, crea en segundo plano una tabla de estado orientada a columnas que almacena el estado de agregación intermedio de la consulta. El motor DPI optimiza la codificación y el almacenamiento de este estado intermedio para acelerar la lectura y la actualización. Los datos incrementales se agregan en micro lotes en la memoria y se combinan con la tabla de estado. Por último, los resultados agregados más recientes se escriben en la Dynamic Table mediante el método BulkLoad.
Elección entre Stream y Binlog
|
Método |
Principio |
Rendimiento de lectura |
Notas |
|
Stream (recomendado) |
Detecta los cambios de datos a nivel de archivo para calcular los datos incrementales de la tabla base. |
Más de 10 veces superior al de Binlog. |
Es más sencillo de usar. No registra los cambios incrementales por separado, por lo que no genera sobrecarga de almacenamiento adicional ni requiere gestionar el ciclo de vida del registro binario. No admite tablas orientadas a filas como tablas base. |
|
Binlog |
El registro binario guarda los cambios de lenguaje de manipulación de datos (DML) de la tabla base y los almacena en segundo plano como un registro binario. El sistema lee dicho registro para detectar los cambios de datos. |
Inferior. |
Genera sobrecarga de almacenamiento adicional. Requiere gestionar el ciclo de vida de almacenamiento (TTL) del registro binario; de lo contrario, el uso de almacenamiento crece de forma continua conforme cambian los datos. |
Notas de uso
Existen ciertos límites en las tablas base compatibles con la actualización incremental. Para obtener más información, consulte Supported features and limits of Dynamic Table.
La tabla de estado integrada para la actualización incremental ocupa espacio de almacenamiento. El sistema establece un TTL para limpiar los datos periódicamente. Utilice la función proporcionada para consultar el tamaño de almacenamiento de esta tabla. Para obtener más información, consulte Manage state tables.
Selección del modo de actualización
Utilice los siguientes criterios para elegir un modo de actualización:
|
Condición |
Modo recomendado |
|
La consulta usa operadores compatibles y las tablas base no están orientadas a filas |
Incremental |
|
Un porcentaje elevado de los datos cambia en cada actualización, o la consulta incluye operadores no compatibles |
Completo |
|
Carga inicial o necesidad de garantizar la coherencia de datos entre capas |
Completo (una sola vez) |
Recursos de cómputo
Las tareas de actualización pueden utilizar recursos de la instancia actual o recursos serverless:
Recursos serverless (predeterminado): en Hologres V3.1 y versiones posteriores, las nuevas Dynamic Tables usan recursos serverless de forma predeterminada. Para consultas complejas o grandes volúmenes de datos, estos recursos mejoran la estabilidad de la actualización y evitan la contención entre las tareas de la instancia. Además, los recursos de cómputo de cada tarea de actualización se ajustan de manera independiente.
Recursos de la instancia actual: la tarea de actualización comparte recursos con otras tareas de la instancia, lo que puede provocar contención durante las horas pico.
Almacenamiento de datos
El almacenamiento de datos de una Dynamic Table funciona igual que el de una tabla estándar y utiliza el modo de almacenamiento activo de forma predeterminada. Para reducir los costos de almacenamiento, traslade los datos que rara vez se consultan al almacenamiento inactivo.
Índices de tabla
Consultar una Dynamic Table directamente equivale a consultar los resultados agregados, lo que mejora significativamente el rendimiento. Al igual que las tablas estándar, las Dynamic Tables admiten índices de tabla como el almacenamiento orientado a filas o a columnas, Distribution Key y Clustering Key. El motor DPI deduce los índices adecuados a partir de la consulta de la Dynamic Table. Establezca índices adicionales para mejorar aún más el rendimiento de las consultas.
Comparación con las vistas materializadas
Dynamic Table frente a la vista materializada en tiempo real de Hologres
Hologres introdujo SQL-managed materialized views en la versión V1.3. Dynamic Table amplía considerablemente estas capacidades.
| Función | Hologres Dynamic Table | Vista materializada en tiempo real de Hologres |
|---|---|---|
| Tipo de tabla base | Tabla interna; tabla externa (MaxCompute, Paimon, OSS); Dynamic Table; vista | Una sola tabla interna |
| Operaciones de la tabla base | Escritura, actualización, eliminación | Escrituras de solo anexión |
| Principio de actualización | Actualización asíncrona (completa o incremental) | Síncrona |
| Puntualidad de la actualización | Nivel de minutos u horas | Tiempo real |
| Tipos de consulta | Agregación de tabla única; unión de varias tablas; JOIN de tabla de dimensiones; OLAP complejo (funciones de ventana, CTE, RB, etc.) Nota
Los tipos de consulta compatibles varían según el modo de actualización. Para obtener más información, consulte Supported features and limits of Dynamic Table. |
Compatibilidad limitada de operadores (AGG, funciones RB, etc.) |
| Modo de consulta | Consultar la Dynamic Table directamente | Consultar la vista materializada directamente; reescritura de consultas |
Dynamic Table frente a la vista materializada asíncrona
Otras plataformas ofrecen funciones similares a Dynamic Table, como las vistas materializadas asíncronas en productos OLAP y Snowflake Dynamic Table.
| Función | Hologres Dynamic Table | Vista materializada asíncrona de producto OLAP | Snowflake Dynamic Table |
|---|---|---|---|
| Tipo de tabla base | Tabla interna; tabla externa (MaxCompute, Paimon, OSS); Dynamic Table; vista Nota
Los tipos de consulta compatibles varían según el modo de actualización. Para obtener más información, consulte Supported features and limits of Dynamic Table. |
Tabla interna; tabla externa (Hive, Hudi, Iceberg, etc.); vista materializada; vista | Tabla interna; Dynamic Table; vista |
| Modo de actualización | Completa; incremental | Completa; actualización por partición específica o rango de marcas de tiempo | Completa; incremental |
| Puntualidad de la actualización | Nivel de minutos u horas | Nivel de horas | Nivel de horas o minutos |
| Tipos de consulta | Agregación de tabla única; unión de varias tablas; JOIN de tabla de dimensiones; OLAP complejo (funciones de ventana, CTE, RB, etc.) | Agregación de tabla única; unión de varias tablas; JOIN de tabla de dimensiones; OLAP complejo (funciones de ventana, CTE, etc.) | Agregación de tabla única; unión de varias tablas; JOIN de tabla de dimensiones; OLAP complejo (funciones de ventana, CTE, etc.) |
| Modo de consulta | Consultar la Dynamic Table directamente | Consultar la vista materializada directamente; reescritura de consultas | Consultar la Dynamic Table directamente |
| Monitoreo/O&M | Interfaces de visualización de DataWorks y HoloWeb; métricas de monitoreo completas | Métricas de monitoreo completas | Interfaz de visualización |
Casos de uso
Dynamic Table completa automáticamente la transformación y el almacenamiento de datos, lo que permite acelerar los datos y mejorar la puntualidad del negocio.
Modernización de la arquitectura Lambda
La arquitectura Lambda utiliza varios componentes de productos para cumplir distintos requisitos de puntualidad. Esto genera una arquitectura redundante, definiciones de datos inconsistentes, dificultades de mantenimiento y redundancia de almacenamiento. Dynamic Table admite la transformación de datos por lotes y el procesamiento casi en tiempo real. Combinada con el almacenamiento unificado de Hologres, que admite consultas OLAP y consultas puntuales de clave-valor (KV), abarca múltiples escenarios de aplicación dentro de un solo producto. De este modo, simplifica la arquitectura y reduce la complejidad del desarrollo y los costos de almacenamiento.
Procesamiento de datos casi en tiempo real
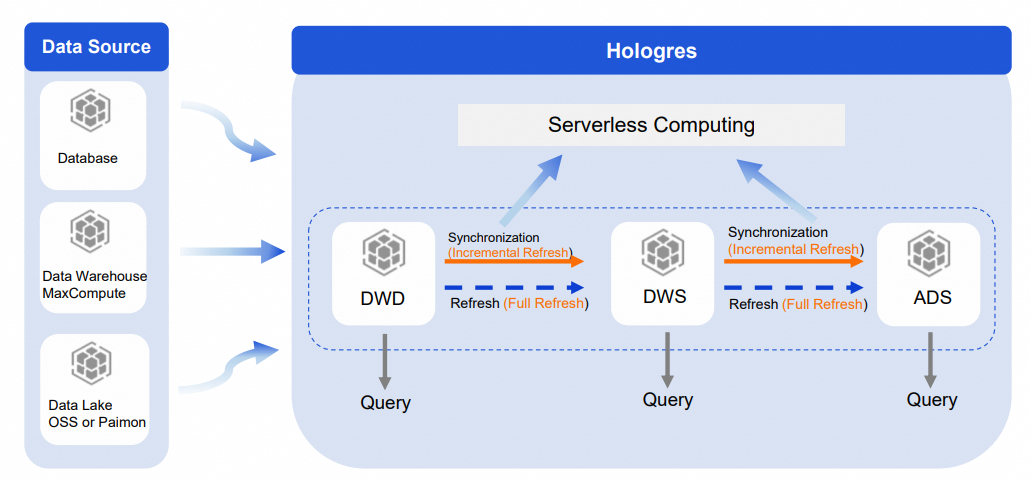
Para tablas base grandes que requieren un procesamiento ETL complejo, la creación de capas en el almacén de datos es el enfoque estándar. Dynamic Table cuenta con procesamiento de datos automático integrado, lo que facilita implementar estas capas en Hologres.
Construya las capas DWD → DWS → ADS en Hologres mediante Dynamic Tables:
Utilice la actualización incremental entre capas. Esto garantiza que se procesen menos datos en cada capa, reduce los cálculos repetidos y mejora la velocidad de sincronización. Envíe las tareas de actualización a Serverless Computing para aumentar aún más la puntualidad y la estabilidad.
Ejecute una actualización completa de una sola vez para garantizar la coherencia de los datos entre capas. Envíe también esta tarea de actualización completa a Serverless Computing.
Cada capa se puede consultar directamente en Hologres. Esto proporciona una estructura clara del almacén de datos, con visibilidad y reutilización en cada nivel.
Aceleración de lakehouse
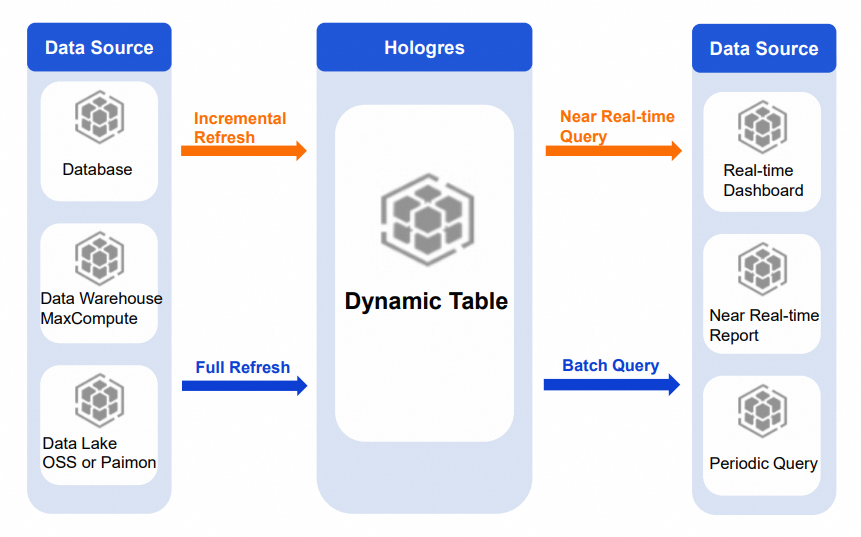
Las tablas base de una Dynamic Table pueden provenir de tablas de Hologres, de almacenes de datos como MaxCompute o de lagos de datos como OSS y Paimon. Las actualizaciones completas o incrementales sobre estos datos admiten diversas necesidades de consulta y exploración con distintos requisitos de puntualidad.
Consultas de informes periódicos: para escenarios de observación periódica con volúmenes de datos pequeños o consultas sencillas, utilice la actualización completa o incremental. Actualice periódicamente los resultados de agregación y análisis de los datos del lakehouse hacia una Dynamic Table. La capa de aplicación consulta la Dynamic Table directamente para recuperar los resultados precalculados, lo que acelera las consultas de informes.
Paneles e informes en tiempo real: para escenarios con mayores exigencias de puntualidad, utilice la actualización incremental. Actualice los resultados de agregación y análisis de Paimon o de datos en tiempo real hacia una Dynamic Table para habilitar el análisis casi en tiempo real.
Sustitución de la programación periódica sin conexión
En los escenarios típicos de procesamiento sin conexión, el volumen de datos es grande y el ciclo de cálculo es largo. Un enfoque común ejecuta un procesamiento T+H (por ejemplo, cada 30 minutos) de DWD a DWS y a ADS, además de un pipeline sin conexión T+1 independiente para procesar los datos de los últimos días con mayor precisión. Esto genera cálculos redundantes, desperdicio de recursos y duplicación de datos. Asimismo, las tareas programadas pueden bloquear los trabajos posteriores si no finalizan a tiempo.
Con Dynamic Table, utilice la actualización incremental T+H para cada capa, de DWD a DWS y a ADS. Varios trabajos se fusionan en un único trabajo de cómputo incremental. Las Dynamic Tables gestionan la programación automáticamente, lo que elimina la necesidad de mantener trabajos de programación externos. Cada vez se calculan únicamente los datos incrementales, lo que evita los cálculos redundantes, acelera el procesamiento, previene la acumulación de tareas y reduce significativamente el uso de recursos de cómputo.
