Cuando el tráfico de consultas se concentra en una sola instancia de Hologres, existe el riesgo de sobrecargarla y perder disponibilidad si dicha instancia falla. Al incluir varios endpoints de instancias secundarias de solo lectura en una única URL de conexión JDBC, Hologres distribuye el tráfico de consultas de forma aleatoria entre las instancias y reintenta automáticamente con otros endpoints cuando uno deja de ser accesible.
Esta función está disponible a partir de Hologres V1.3.
Funcionamiento
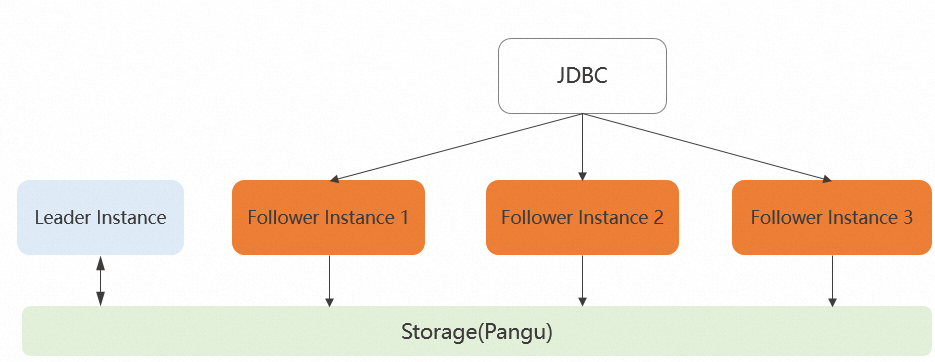
Una instancia principal de Hologres puede tener asociadas varias instancias secundarias de solo lectura. Las instancias comparten almacenamiento, pero sus recursos de cómputo están aislados entre sí, lo que forma un despliegue de alta disponibilidad (HA) con separación de lectura y escritura. Para obtener más información, consulte Primary and secondary instances with read/write splitting (shared storage).
Al enumerar varios endpoints en la URL de conexión, JDBC ofrece dos comportamientos:
Distribución aleatoria: Cuando
loadBalanceHosts=true, JDBC selecciona aleatoriamente entre los endpoints listados y distribuye las conexiones entre las instancias.Failover secuencial: Si falla un intento de conexión a un endpoint, JDBC prueba automáticamente con el siguiente endpoint de la URL. JDBC solo notifica un error de conexión si todos los endpoints listados son inaccesibles.
JDBC determina si una instancia es principal o secundaria de solo lectura mediante la verificación del parámetro Grand Unified Configuration (GUC) in_hot_standby: off indica instancia principal y on indica instancia secundaria de solo lectura. Esto permite que targetServerType enrute las solicitudes según el rol de la instancia.
Requisitos previos
Antes de empezar, asegúrese de contar con lo siguiente:
Varias instancias secundarias de solo lectura de Hologres asociadas a una instancia principal. Consulte Configure primary and secondary instances that use shared storage
Controlador JDBC de PostgreSQL versión 42.3.2 o posterior. Consulte JDBC
Configuración del balanceo de carga en la URL de conexión
Incluya todos los endpoints de las instancias en la URL de conexión, separados por comas. El siguiente ejemplo muestra la configuración recomendada para el balanceo de carga aleatorio con una caché de endpoints de 10 segundos:
jdbc:postgresql://<Endpoint1>:<Port1>,<Endpoint2>:<Port2>,<Endpoint3>:<Port3>/<DBNAME>?user=<AccessKey ID>&password=<AccessKey secret>&targetServerType=any&loadBalanceHosts=true&hostRecheckSeconds=10La siguiente tabla describe cada parámetro.
|
Parámetro |
Descripción |
|
|
Dirección de red de la instancia de Hologres. Obténgala desde la página Instance Details en la consola de Hologres. |
|
|
Puerto de la instancia de Hologres. Obténgalo desde la página Instance Details en la consola de Hologres. |
|
|
Nombre de la base de datos a la que se conectará. |
|
|
Su AccessKey ID. Obténgalo en AccessKey Management. |
|
|
Su AccessKey secret. Obténgalo en AccessKey Management. |
|
|
Controla qué tipos de instancia aceptan conexiones. Valores compatibles: |
|
|
Controla el orden de conexión. |
|
|
Tiempo en segundos durante el cual JDBC almacena en caché la lista de endpoints accesibles. Valor predeterminado: |
Para consultar la lista completa de opciones de configuración de JDBC para PostgreSQL, revise la documentación de JDBC .
Ejemplos
Balanceo de carga aleatorio entre tres instancias secundarias de solo lectura
Conéctese a tres instancias secundarias de solo lectura con distribución aleatoria (loadBalanceHosts=true, targetServerType=any). Cuando una instancia no esté disponible, JDBC reintentará automáticamente con los demás endpoints.
import java.sql.*;
import java.util.HashMap;
import java.util.Map;
import java.util.Properties;

public class hatest {
    public static void main(String[] args) {
        // Read-only secondary instance 1
        String endpoint1 = "hgpostcn-cn-wxxxxxxxx01-cn-shanghai.hologres.aliyuncs.com:80";
        // Read-only secondary instance 2
        String endpoint2 = "hgpostcn-cn-wxxxxxxxx02-cn-shanghai.hologres.aliyuncs.com:80";
        // Read-only secondary instance 3
        String endpoint3 = "hgpostcn-cn-wxxxxxxxx03-cn-shanghai.hologres.aliyuncs.com:80";
        String dbname = "postgres";
        String jdbcUrl = "jdbc:postgresql://" + endpoint1 + "," + endpoint2 + "," + endpoint3 + "/" + dbname;
        Properties properties = new Properties();
        properties.setProperty("user", "xxxx");
        properties.setProperty("password", "xxxx");
        // any: connect to any listed endpoint regardless of instance role
        properties.setProperty("targetServerType", "any");
        // true: randomly select from listed endpoints to distribute load
        properties.setProperty("loadBalanceHosts", "true");
        // Cache reachable endpoints for 10 seconds before rechecking
        properties.setProperty("hostRecheckSeconds", "10");
        try {
            Class.forName("org.postgresql.Driver");
            Connection connection = DriverManager.getConnection(jdbcUrl, properties);
            PreparedStatement preparedStatement = connection.prepareStatement("show hg_frontend_endpoints;");
            ResultSet resultSet = preparedStatement.executeQuery();
            while (resultSet.next()) {
                ResultSetMetaData rsmd = resultSet.getMetaData();
                int columnCount = rsmd.getColumnCount();
                Map map = new HashMap();
                for (int i = 0; i < columnCount; i++) {
                    map.put(rsmd.getColumnName(i + 1).toLowerCase(), resultSet.getObject(i + 1));
                }
                System.out.println(map);
            }
        } catch (Exception exception) {
            exception.printStackTrace();
        }
    }
}
Alternancia entre una instancia principal y una secundaria de solo lectura
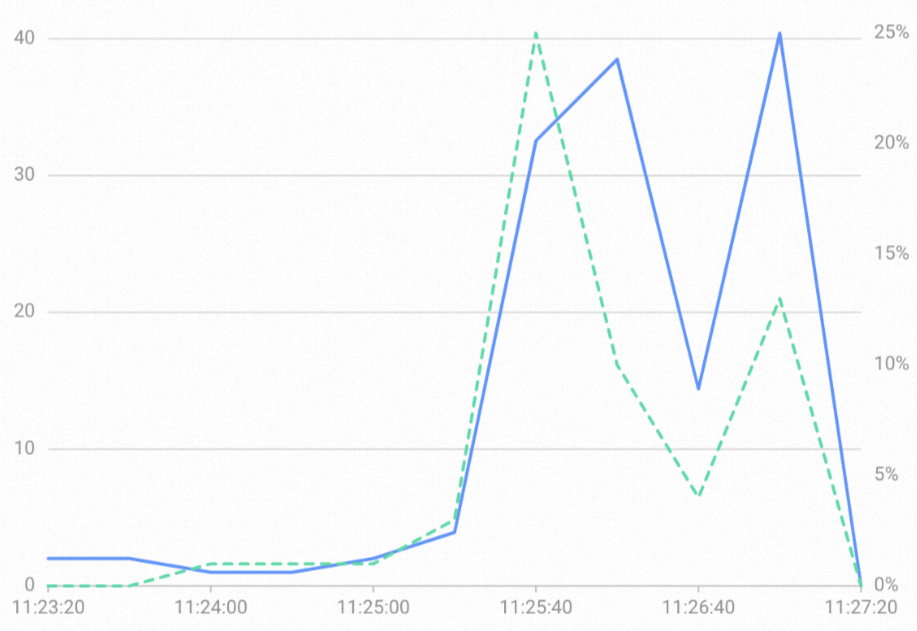
Envíe 100 consultas distribuidas entre una instancia principal y una secundaria de solo lectura. Con loadBalanceHosts=true, JDBC distribuye las conexiones de forma aleatoria, por lo que el recuento de conexiones en ambas instancias debería ser aproximadamente igual tras ejecutar las consultas.
import java.sql.*;
import java.util.HashMap;
import java.util.Map;
import java.util.Properties;

public class hatest {
    public static void main(String[] args) {
        int x = 1;
        while (x <= 100) {
            // Primary instance
            String endpoint1 = "hgpostcn-cn-wxxxxxxxx04-cn-hangzhou.hologres.aliyuncs.com:80";
            // Read-only secondary instance
            String endpoint2 = "hgpostcn-cn-wxxxxxxxx05-cn-hangzhou.hologres.aliyuncs.com:80";
            String dbname = "postgres";
            String jdbcUrl = "jdbc:postgresql://" + endpoint1 + "," + endpoint2 + "/" + dbname;
            Properties properties = new Properties();
            properties.setProperty("user", "xxx");
            properties.setProperty("password", "xxx");
            // any: connect to any listed endpoint regardless of instance role
            properties.setProperty("targetServerType", "any");
            // true: randomly select from listed endpoints to distribute load
            properties.setProperty("loadBalanceHosts", "true");
            // Cache reachable endpoints for 10 seconds before rechecking
            properties.setProperty("hostRecheckSeconds", "10");
            try {
                Class.forName("org.postgresql.Driver");
                Connection connection = DriverManager.getConnection(jdbcUrl, properties);
                PreparedStatement preparedStatement = connection.prepareStatement("show hg_frontend_endpoints;");
                ResultSet resultSet = preparedStatement.executeQuery();
                while (resultSet.next()) {
                    ResultSetMetaData rsmd = resultSet.getMetaData();
                    int columnCount = rsmd.getColumnCount();
                    Map map = new HashMap();
                    for (int i = 0; i < columnCount; i++) {
                        map.put(rsmd.getColumnName(i + 1).toLowerCase(), resultSet.getObject(i + 1));
                    }
                    System.out.println(map);
                }
            } catch (Exception exception) {
                exception.printStackTrace();
            }
            x++;
        }
    }
}
Para comprobar la distribución, revise el recuento de conexiones de cada instancia en el panel de monitoreo. Los recuentos deberían ser aproximadamente iguales. Consulte View monitoring metrics para obtener más detalles.
Métricas de monitoreo de la instancia hgpostcn-cn-wxxxxxxxx04.
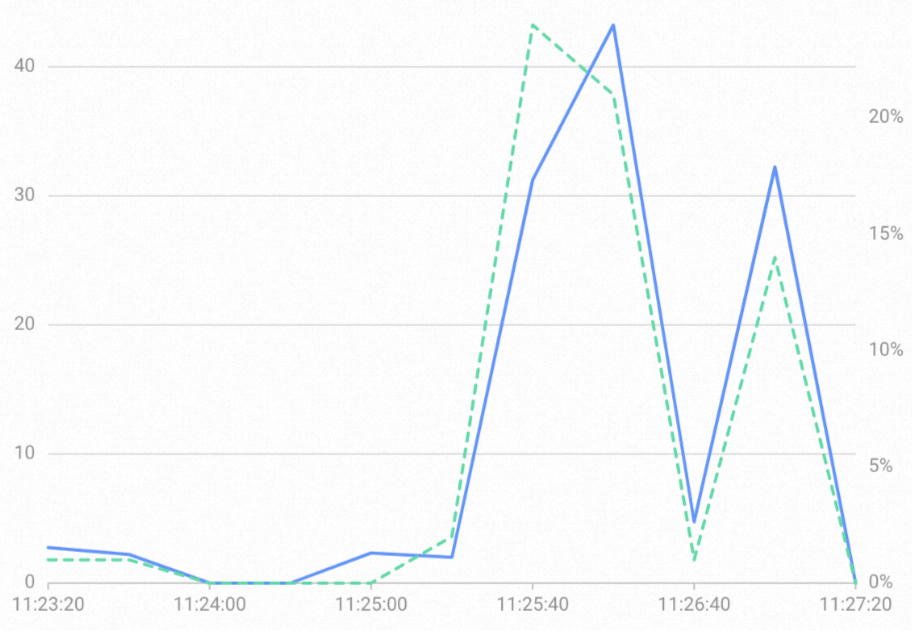
Métricas de monitoreo de la instancia hgpostcn-cn-wxxxxxxxx05.